---
title: 사용자 인증 없이 구조화된 데이터 검색하기: Copilot Studio의 Dataverse searchQuery
description: 로그인 없이 Dataverse 구조화 데이터를 검색하는 Copilot Studio searchQuery 활용법을 소개해요. 설정 5단계와 entities JSON 구성, 보안 주의사항까지 한 번에 확인해요.
date: 2026-09-07
tags: [Copilot Studio, Dataverse, searchQuery, 메이커 인증, 구조화 데이터 검색]
cards:
- /cards/dataverse-searchquery-noauth/card-01.png
- /cards/dataverse-searchquery-noauth/card-02.png
- /cards/dataverse-searchquery-noauth/card-03.png
- /cards/dataverse-searchquery-noauth/card-04.png
- /cards/dataverse-searchquery-noauth/card-05.png
- /cards/dataverse-searchquery-noauth/card-06.png
- /cards/dataverse-searchquery-noauth/card-07.png
author: Lissa
source: https://interlinear.work/notes/dataverse-searchquery-noauth/
---
> **원문:** [Structured Data with Zero User Auth: Dataverse searchQuery in Copilot Studio](https://microsoft.github.io/mcscatblog/posts/dataverse-search-in-copilot-studio-unauthenticated-structured-data/)
> **게시일:** 2026-03-20 · **저자:** Karima Kanji-Tajdin
Dataverse에 구조화된 데이터가 있다고 해 봐요. 구역, 유형, 전화번호, 좌표를 가진 시설 목록 같은 것 말이죠. 그리고 사람들이 로그인 없이 이 데이터를 검색할 수 있는 Copilot Studio 에이전트를 만들고 싶어요. B2C 포털, 공공 키오스크, 부서 디렉터리를 떠올려 보세요. 사용자에게는 퍼지(fuzzy) 탐색("Darol 센터")*과* 구조화된 필터링("West 구역에 있는")이 모두 필요하고, 로그인 화면은 절대 보여선 안 돼요.
데이터가 비구조화된 형태였다면 [파일을 에이전트에 직접 업로드](https://learn.microsoft.com/en-us/microsoft-copilot-studio/knowledge-add-file-upload)하고 끝낼 수 있었을 거예요. 하지만 테이블에는 다른 접근이 필요해요. 그리고 로그인한 사용자에게는 이 문제를 훌륭하게 처리해 주는 [Dataverse 테이블 기반 지식(Knowledge)](https://learn.microsoft.com/en-us/microsoft-copilot-studio/knowledge-add-dataverse)은 인증을 요구해요. 시작조차 할 수 없죠.
[Dataverse MCP](https://microsoft.github.io/mcscatblog/posts/connecting-copilot-studio-dataverse-mcp-endpoint-across-environments/)는 서비스 주체(service principal) 인증으로 동작하고 환경 간 호출까지 지원해요. 하지만 MCP 서버는 에이전트에게 초능력을 부여해요. 여러 테이블을 넘나들 수 있고, 여러분이 의도하지 않은 쿼리에도 응답할 수 있어요. 공개용 에이전트에서는 어떤 테이블, 어떤 열, 어떤 비즈니스 규칙에 에이전트가 접근할 수 있는지를 더 엄격하게 제어해야 했어요.
우리에게 필요한 것은 퍼지 검색이 되면서 *동시에* 인증이 필요 없고 *동시에* 메이커가 완전히 제어할 수 있는 거였어요.
**그런 것이 이미 존재해요.** Dataverse 커넥터 안에 숨어 있는 **`searchQuery`**라는 언바운드 액션(unbound action)이 바로 그거예요. 모델 기반 앱의 검색 창과 Dataverse MCP를 구동하는 것과 같은 관련성(relevance) 엔진이에요. 처음부터 쭉 거기 있었어요. 다만 이것을 Copilot Studio 에이전트에 도구로 직접 연결할 수 있다는 사실을 대부분 모를 뿐이에요.
완성된 에이전트의 모습은 다음과 같아요. 검색 도구 하나에 몇 가지 개선을 더하면, 실제의 지저분한 사람 입력을 처리하는 검색 경험이 완성돼요.
_기본 패턴은 도구 하나로 시작해요. 전체 레코드 조회가 필요하면 나중에 List Rows를 추가하세요._
---
## searchQuery란 무엇인가
[`searchQuery`](https://learn.microsoft.com/en-us/power-apps/developer/data-platform/search/query)는 Dataverse 커넥터의 [언바운드 액션](https://learn.microsoft.com/en-us/power-apps/developer/data-platform/webapi/use-web-api-actions#unbound-actions)으로, Copilot Studio에서 도구로 직접 호출할 수 있다는 뜻이에요. 내부적으로는 Dataverse 관련성 검색 인덱스를 노출하는데, 이는 모델 기반 앱의 검색 창과 Dataverse MCP를 구동하는 바로 그 엔진이에요. 이 인덱스는 오타, 어간(stemming), 유사 용어에 대한 지능적 확장을 갖춘 키워드 기반이에요. 벡터 검색1도, 임베딩1 기반도 아니에요. 얼마나 잘 일치하는지에 따라 결과를 순위화하는 퍼지 관련성 엔진이며, 구조화된 데이터에 딱 맞는 크기예요.
그리고 우리 시나리오에서 이것이 통하게 만드는 결정적 디테일이 있어요. **메이커 인증(maker auth)**을 사용하면 [서비스 주체 자격 증명](https://learn.microsoft.com/en-us/power-apps/developer/data-platform/authenticate-oauth#register-your-app)으로 Dataverse 커넥터를 연결할 수 있어요. 에이전트는 그 자격 증명으로 searchQuery를 호출하고, 최종 사용자는 로그인 화면을 결코 보지 않아요.
> **주의:** 서비스 주체의 Dataverse 보안 역할이 에이전트가 접근할 수 있는 데이터를 결정해요. 인증되지 않은 모든 사용자가 같은 데이터를 보게 돼요. 애플리케이션 사용자에게는 공개적으로 노출해도 안전한 테이블과 열에 대한 읽기 권한만 부여했는지 반드시 확인하세요.
---
## 데이터와 인덱스 설정하기
이 섹션에서는 아무것도 없는 상태에서 동작하는 에이전트까지 가요. 테이블을 인덱싱하고, 검색 도구를 연결하고, YAML을 붙여 넣을 거예요. 이 과정을 마치면 뭔가 돌아가는 것이 생기고, [더 똑똑하게 만들기](#더-똑똑하게-만들기)에서 이를 한 단계 끌어올리는 방법을 보여 드려요.
searchQuery가 동작하도록 만드는 설정은 세 가지 도구의 다섯 개 화면에 흩어져 있어요. 하나라도 놓치면 결과가 0건이 되거나 기본 이름 열에서만 매칭되고, 왜 그런지 알려 주는 오류 메시지도 없어요. 지도는 다음과 같아요.
| # | 단계 | 위치 | 건너뛰면 생기는 일 |
|---|------|-------|----|
| 1 | [Dataverse Search 활성화](https://learn.microsoft.com/en-us/power-platform/admin/configure-relevance-search-organization#managing-dataverse-search) | **PP 관리 센터** → 환경 → 설정 → 기능 | searchQuery가 조용히 완전히 실패 |
| 2 | [테이블을 솔루션에 추가](https://learn.microsoft.com/en-us/power-apps/maker/data-platform/create-solution) | **아무 솔루션** → 기존 항목 추가 → 테이블 | Manage Search Index에 표시되지 않음 |
| 3 | [테이블을 검색 인덱스에 추가](https://learn.microsoft.com/en-us/power-platform/admin/configure-relevance-search-organization#select-tables-for-dataverse-searchs-global-search) | **솔루션** → 개요 → Manage Search Index | searchQuery 결과가 0건 |
| 4 | [Quick Find 뷰 구성](https://learn.microsoft.com/en-us/power-platform/admin/configure-relevance-search-organization#set-up-dataverse-search-for-global-search) | **테이블 디자이너** → 뷰 → Quick Find → Find 열과 View 열 추가 → 저장 및 게시 | 기본 이름 열에서만 매칭 |
| 5 | [열을 Searchable로 설정](https://learn.microsoft.com/en-us/power-platform/admin/configure-relevance-search-organization#select-searchable-fields-and-filters-for-each-table) | **열 속성** → 고급 옵션 → Searchable = Yes | 해당 열이 아예 인덱싱되지 않음 |
각 단계의 스크린샷
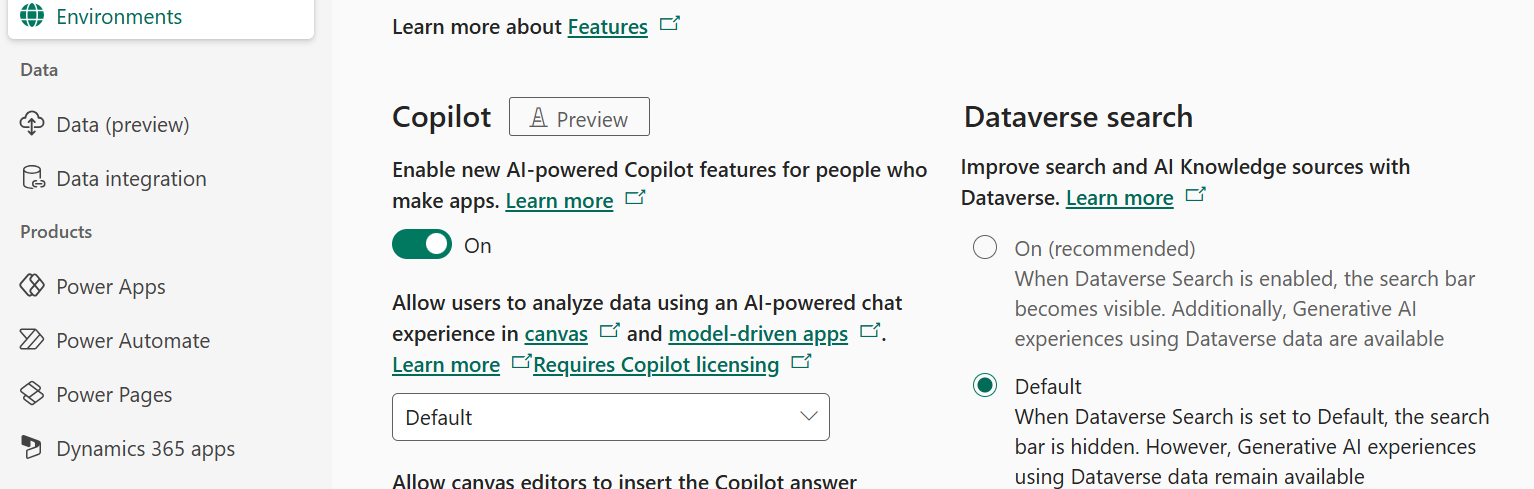
1단계: Power Platform 관리 센터에서 Dataverse Search 활성화
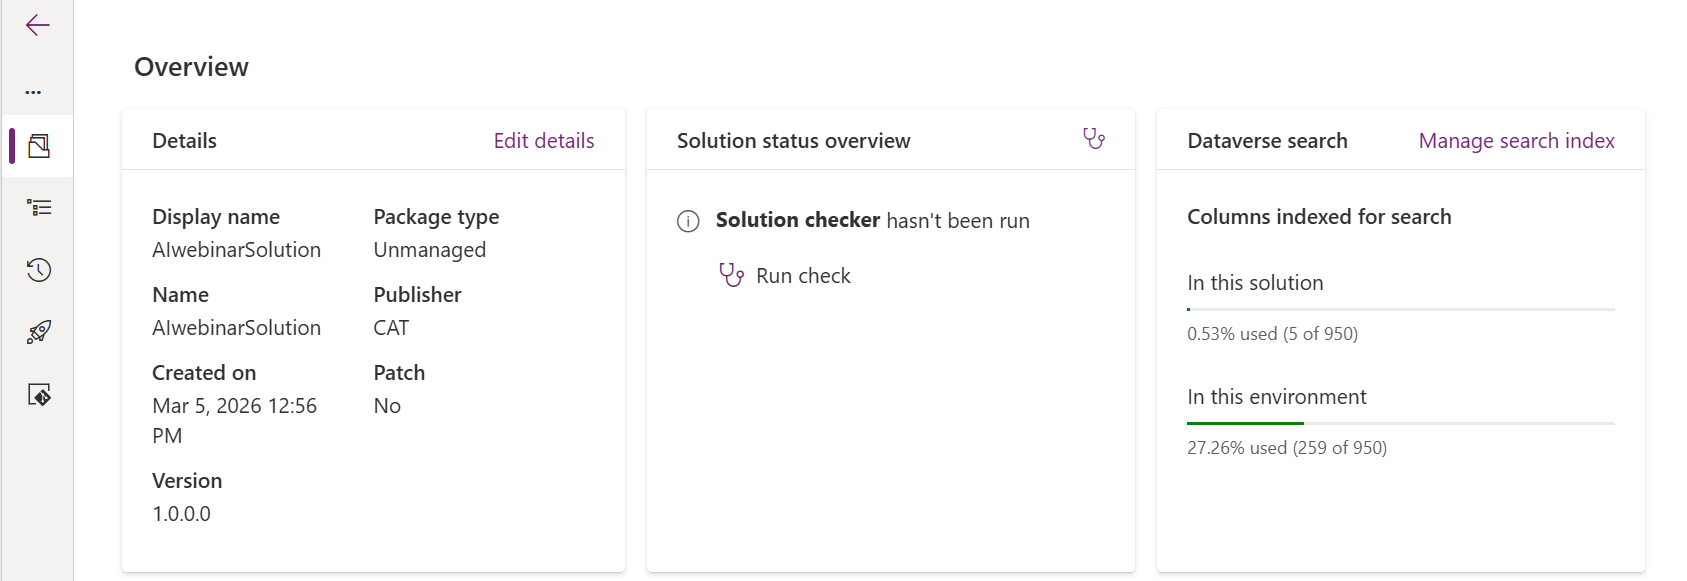
3단계: 테이블을 검색 인덱스에 추가
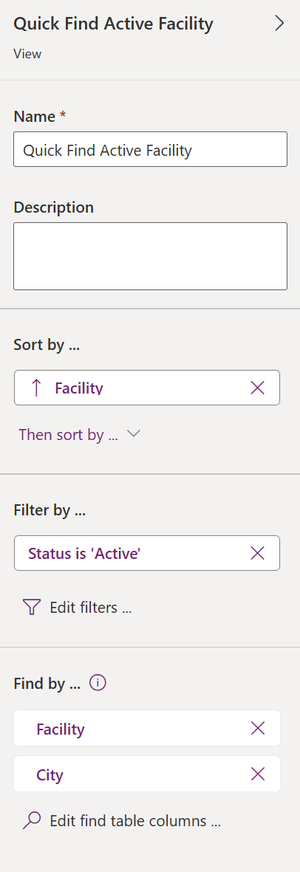
4단계: Quick Find — View 열은 반환되는 내용을, Find 열은 검색 가능한 내용을 정의해요.
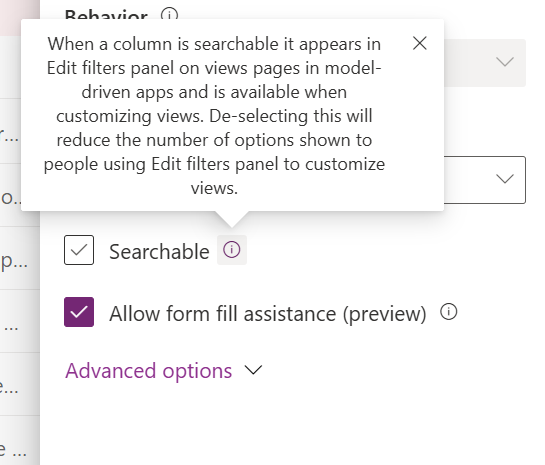
5단계: 열이 인덱싱될 수 있도록 Searchable로 설정
> **참고:** **테이블이 에이전트와 같은 솔루션에 있을 필요는 없어요.** Manage Search Index는 솔루션 수준 기능이지만, 검색 인덱스 자체는 환경 수준이에요. 테이블이 한번 인덱싱되면 같은 환경의 어떤 에이전트든, 에이전트가 어느 솔루션에 있든 searchQuery를 통해 그 테이블을 검색할 수 있어요.
> **팁:** **성격이 급하신가요? 저도 그래요.** 테이블을 인덱스에 추가한 뒤 검색 가능해지기까지 지연이 있을 수 있어요. 우연히 발견한 프로 팁이 있어요. 아무 Copilot Studio 에이전트에서든 그 테이블을 **지식(Knowledge)**에 추가하세요. 그러면 Dataverse가 내부적으로 즉시 인덱싱을 시작해요. 이후 지식에서 제거해도 인덱스는 유지돼요. 천만에요.
## Copilot Studio에 검색과 도구 추가하기
이제 연결해 봐요. Copilot Studio에서:
1. Copilot Studio 에이전트에서 **도구(Tools)** → **도구 추가(Add a tool)**로 이동해요
2. **Dataverse** 커넥터를 선택해요
3. **언바운드 액션 수행(Perform an unbound action)**을 선택해요
4. **searchQuery** 액션을 선택해요
5. 인증을 [**메이커 제공 자격 증명(Maker-provided credentials)**](https://learn.microsoft.com/en-us/microsoft-copilot-studio/configure-enduser-authentication)으로 설정해요
도구 구성은 두 부분으로 나뉘어요. **세부 정보(Details)** 탭(이름과 설명)과 **입력(Inputs)** 탭이에요.
세부 정보 탭부터 시작해요. [**이름(Name)**과 **설명(Description)**](https://learn.microsoft.com/en-us/microsoft-copilot-studio/add-tools-custom-agent#details)은 오케스트레이터가 언제 여러분의 도구를 호출할지, 결과를 어떻게 제시할지 결정하는 근거예요. 커넥터 이름("Perform Unbound Action")이 아니라 비즈니스 기능("Search community facilities")을 따서 이름을 지으세요. 설명은 [더 똑똑하게 만들기](#더-똑똑하게-만들기)에서 대폭 강화할 예정이에요.
_세부 정보 탭: 이름, 설명, 그리고 맨 아래의 사용할 자격 증명(메이커 제공 자격 증명)._
그다음 입력 탭으로 전환해요. 기본 도구에는 네 개의 입력이 필요해요.
| 입력 | 채우기 방식 | 역할 |
|-------|-----------|-------------|
| **Environment** | Custom value | Dataverse 환경 URL이에요. 드롭다운에서 선택하거나 URL을 붙여 넣어요. |
| **Action Name** | Custom value | 항상 `searchquery`예요. 우리가 호출하는 언바운드 액션이에요. |
| **entities** | Custom value | 어떤 테이블을 검색할지, 어떤 열에 대해 매칭할지(`SearchColumns`), 어떤 열을 반환할지(`SelectColumns`)를 정의하는 JSON 배열이에요. 검색 대상이 아니어도 반환할 수 있고, 두 목록 어디에도 없는 열은 searchQuery에서 사용할 수 없어요. |
| **search** | Dynamically fill with AI | 오케스트레이터가 사용자 메시지를 읽고 검색 키워드를 추출해요. `description` 필드는 *무엇을* 추출할지에 대한 지시예요. 여러분 데이터에 담긴 용어의 종류(시설명, 지명, 서비스 유형)에 초점을 맞추세요. |
_입력 탭: 네 개의 입력, 각각의 "Fill using" 모드._
코드 뷰에서 작업하는 편이 좋다면 아래 YAML을 그대로 붙여 넣을 수 있어요. 환경 URL과 엔터티/열의 논리적 이름(logical name)은 반드시 여러분의 것으로 교체하세요.
searchQuery 도구 — 기본 YAML
kind: TaskDialog
inputs:
  - kind: ManualTaskInput
    propertyName: organization
    value: https://YOUR-ENV.crm.dynamics.com  # Replace with your environment URL

  - kind: ManualTaskInput
    propertyName: actionName
    value: searchquery

  - kind: AutomaticTaskInput
    propertyName: item.search
    name: search keywords
    description: >-
      Keywords from the user's question. Extract facility names,
      place names, and service types. Not full sentences.

  - kind: ManualTaskInput
    propertyName: item.entities
    value: >-
      [{"Name": "crc57_facility1",
        "SelectColumns": ["crc57_facility","crc57_facilitydescription",
          "crc57_city","crc57_district","crc57_facilitytype",
          "crc57_phonenumber"],
        "SearchColumns": ["crc57_facility","crc57_city",
          "crc57_facilitydescription"]}]

modelDisplayName: Search community facilities
modelDescription: >-
  Searches the community facility directory using keywords.
  Use this tool when the user is looking for a facility
  but doesn't have an exact name or ID.

action:
  kind: InvokeConnectorTaskAction
  connectionProperties:
    mode: Maker
  operationId: PerformUnboundActionWithOrganization
### Entities JSON 이해하기
`entities` 입력을 하나씩 풀어 봐요. 구성 실수가 가장 많이 발생하는 곳이기 때문이에요.
```json
[{
"Name": "crc57_facility1",
"SelectColumns": ["crc57_facility", "crc57_facilitydescription",
"crc57_city", "crc57_district", "crc57_facilitytype",
"crc57_phonenumber"],
"SearchColumns": ["crc57_facility", "crc57_city",
"crc57_facilitydescription"]
}]
```
> **주의:** `SearchColumns` = searchQuery가 퍼지 검색 시 **매칭 대상으로 삼는** 열. `SelectColumns` = searchQuery가 각 결과에서 **반환하는** 열. 검색 대상이 아니어도 반환할 수 있어요. 두 목록 어디에도 없는 열을 가져오려면 List Rows가 필요해요.
우리 구성에서 `crc57_district`, `crc57_facilitytype`, `crc57_phonenumber`는 SelectColumns에는 있지만 SearchColumns에는 **없어요**. 에이전트가 결과에 표시는 하지만, 구역 이름을 입력해도 그 열들에 대해 퍼지 매칭이 일어나지는 않아요. 구역으로 좁히려면 오케스트레이터가 대신 `filter` 입력을 사용할 수 있는데, 이는 [더 똑똑하게 만들기](#더-똑똑하게-만들기)에서 추가할게요.
SelectColumns에 아예 없는 열들(이미지 URL, 좌표, 운영 시간)은 searchQuery에서 반환되지 않아요. 그 공백은 더 똑똑하게 만들기에서 [List Rows](#전체-레코드-조회를-위한-list-rows-추가하기)를 추가해 메울 거예요.
`entities` 배열은 여러 객체도 허용하므로, 한 번의 searchQuery 호출로 여러 테이블을 동시에 검색할 수 있으며, 각 테이블이 자체 SelectColumns와 SearchColumns를 가져요. 결과는 함께 순위화되어 반환돼요.
### 이게 전부예요 — 도구 하나로 동작해요
searchQuery 도구만 구성해도 에이전트는 이미 Dataverse 테이블을 검색하고 대화형으로 결과를 반환할 수 있어요. 사용자가 "Is there a Darrl community center in hillcrest?"라고 입력하면 에이전트는 "Darrel Jon Senior Centre", "Daryl Ann Recreation Centre", "Darroll Access Point"를 찾아내요. 관련성 순으로 정렬되고, 설명·구역·전화번호까지 함께요.
_도구 하나. 사용자가 이름의 철자를 틀렸는데도 에이전트는 상세 정보와 함께 세 개의 퍼지 매칭을 찾았어요._
searchQuery는 `SelectColumns` 목록에 있는 모든 열의 전체 내용을 반환하며, 여러 줄 텍스트 필드도 포함돼요. 응답의 `Highlights`는 어떤 용어가 매칭되었는지 보여 주고(굵게 표시할 때 유용해요), `Attributes`의 실제 데이터는 온전하게 반환돼요.
> **주의:** entities JSON의 잘못된 논리적 이름, 검색 인덱스에 없는 열, `SelectColumns`를 아예 생략하는 것 — 이 모든 경우가 오류 메시지 없이 결과 0건으로 조용히 실패해요. 에이전트가 아무것도 반환하지 않으면 논리적 이름부터 확인하세요.
> **팁:** searchQuery는 [커스텀 지식 소스 토픽](https://microsoft.github.io/mcscatblog/posts/copilot-studio-custom-knowledge-source/)에서도 호출할 수 있어요. 즉, 에이전트가 searchQuery 결과를 다른 지식 소스와 함께 하나의 그라운딩된 응답으로 요약할 수 있다는 뜻이에요.
**이제 Dataverse 구조화 데이터에 대해 동작하는, 인증이 필요 없는 검색 에이전트가 생겼어요.** 도구 하나, 커넥터 하나, 사용자 로그인 0회. 에이전트는 퍼지 입력을 처리하고, 전체 열 데이터와 함께 순위화된 결과를 반환하며, 대화형으로 응답해요. 이것이 완성된 기본 패턴이에요.
아래의 모든 내용은 선택 사항이에요. 각 기법은 이미 갖춘 것 위에 특정 기능 하나씩을 더해요. 여러분 시나리오에 필요한 것만 고르세요.
---
## 더 똑똑하게 만들기
기본 패턴은 테이블 하나에 대한 퍼지 검색을 제공해요. 하지만 실제 시나리오에서는 금방 더 많은 것이 필요해져요. 검색 인덱스에 없는 열, 구역이나 유형별 필터링, 긴 결과 목록의 페이지네이션, 대상 사용자별로 특화된 여러 검색 도구 등이죠. 아래 각 섹션이 기능을 하나씩 추가해요. 모두 선택 사항이며, 모두 이미 만든 기본 도구 위에 쌓아 올리는 거예요.
### 전체 레코드 조회를 위한 List Rows 추가하기
searchQuery는 `SelectColumns` 목록의 열들을 전체 여러 줄 텍스트까지 포함해 반환해요. 하지만 SelectColumns에 넣지 않은 열들(사진, 좌표, 운영 시간, 웹사이트 링크)은 얻을 수 없어요. 사용자에게 그것들이 필요하다면 두 번째 도구를 추가하세요. 같은 Dataverse 커넥터의 표준 **List Rows** 액션이며, 마찬가지로 메이커 인증을 사용해요.
List Rows는 행 ID로 모든 열을 포함한 전체 레코드를 조회해요. 도구 설명에 "검색 도구가 시설을 식별한 후에(AFTER) 이 도구를 사용하라"고 적혀 있기 때문에 오케스트레이터는 언제 호출할지 알고 있어요. 먼저 탐색을 위해 searchQuery를 호출하고, 사용자가 검색 결과에 없는 상세 정보를 요청하면 List Rows를 호출하는 거예요.
List Rows 도구 — 전체 YAML
kind: TaskDialog
inputs:
  - kind: ManualTaskInput
    propertyName: organization
    value: https://YOUR-ENV.crm.dynamics.com  # Replace with your environment URL

  - kind: ManualTaskInput
    propertyName: entityName
    value: crc57_facility1s  # Replace with your table's plural logical name

  - kind: AutomaticTaskInput
    propertyName: "'$filter'"
    name: Row id
    description: |-
      This is an odata filter query that selects the rows for the
      given guid's. Use the crc57_facility1id value of the facilities
      the user selected or the highest-ranked matches. id format is
      like "5c1a1870-a419-f111-8342-7ced8..."

modelDisplayName: Get full facility details
modelDescription: |-
  Retrieves complete record for specific facilities using row ID.
  Use this tool AFTER the search tool has identified one or many
  facilities the user is interested in. Output: For the location,
  give a clickable bing maps link instead of raw coordinates.
  Present the output as a facility card html: name, district, city,
  type, phone, hours, website, and whether it's accessible.
  If an image URL is available, include it.

action:
  kind: InvokeConnectorTaskAction
  connectionProperties:
    mode: Maker
  operationId: ListRecordsWithOrganization
### OData 필터링 추가하기
기본 searchQuery 도구는 퍼지 키워드 매칭으로 결과를 찾아요. 그런데 사용자가 "show me community hubs in the West district"라고 말하면 어떻게 될까요? 필터링이 없으면 searchQuery는 모든 구역에 걸쳐 "community hubs"의 퍼지 매칭을 전부 반환하고, 사용자는 West에 있는 것을 찾으려고 결과를 훑어야 해요. OData2 필터가 있으면 오케스트레이터가 검색 결과를 반환 전에 West 구역으로만 좁혀 줘요.
searchQuery 도구에 새 `item.filter` 입력을 추가하고 "Fill using"을 **Dynamically fill with AI**로 설정하세요. 핵심은 설명(description)이에요. 필터링 가능한 모든 필드와 그 타입, 유효한 값을 나열해요. 이 설명이 곧 오케스트레이터에게 자연어로부터 유효한 OData 표현식을 생성하는 법을 가르치는 용어집(glossary)**이에요**.
OData filter 입력 YAML
  - kind: AutomaticTaskInput
    propertyName: item.filter
    name: implicitfilter
    description: |-
      Generate a Dataverse OData filter expression ONLY when the user
      request or conversation context clearly implies a filtering
      criterion.

      DO NOT ask the user any follow-up questions.
      DO NOT invent filters.
      DO NOT apply a filter unless the criterion is explicitly or
      unambiguously implied.

      If no clear filter criterion is present, return:
      statecode eq 0

      Rules:
      - Return ONLY a valid OData filter expression.
      - Do NOT include "$filter=".
      - Use eq, ne, and, or.
      - Wrap string values in single quotes.

      Filterable fields (crc57_facility1 table):
      - crc57_district (Choice): e.g. 'West', 'East', 'North',
        'Central', 'South', 'Downtown'
      - crc57_city (Text): e.g. 'Hillcrest', 'Riverton', 'Bayview',
        'Crestwood'
      - crc57_facilitytype (Choice): e.g. 'Community Hub',
        'Library Branch', 'Recreation Centre'

      If multiple criteria are implied, combine using AND.
사용자가 "show me community hubs in the West"라고 말하면 오케스트레이터는 용어집을 읽고 `crc57_district eq 'West' and crc57_facilitytype eq 'Community Hub'`를 생성해요. 자연어가 들어가서 유효한 OData가 나와요. 코드는 없어요.
행동 제약에 주목하세요. "DO NOT ask follow-up questions. DO NOT invent filters." 이런 제약이 없으면 오케스트레이터가 필터 값을 지어내거나 사용자에게 불필요한 질문을 퍼부을 수 있어요.
기본 필터 `statecode eq 0`은 필터가 암시되지 않았을 때 활성 레코드만 반환되도록 보장해요. 작은 디테일이지만 신뢰에는 큰 영향을 줘요.
> **참고:** searchQuery의 `filter`는 **사후 필터(post-filter)**예요. 테이블 전체가 아니라 순위화된 상위 N개 결과를 좁혀요. 매칭되는 모든 행이 필요하다면("West에 있는 시설 전부 보여 줘") 대신 OData `$filter`를 사용하는 List Rows를 쓰세요.
### 동의어로 검색 입력 보강하기
Dataverse 검색 인덱스는 자체적으로도 오타를 잘 처리해요. "Darrl"로 "Darrell"을 찾아내죠. 하지만 시맨틱이 아니라 키워드 기반이에요. 사용자가 "노년층을 위한 활동이 있는 시설"을 묻는데 데이터에는 "senior wellness programs"라고 되어 있다면, 인덱스는 그 연결을 만들지 못해요. 단어가 겹치지 않으니까요.
`item.search` 설명을 보강해서, 쿼리가 API에 도달하기 전에 오케스트레이터가 사용자의 쿼리를 동의어와 관련 용어로 확장하도록 지시하면 이 간극을 메울 수 있어요.
```yaml
- kind: AutomaticTaskInput
propertyName: item.search
name: implicit search words
description: >-
Inferred keywords, partial names, and descriptive phrases from
the user's question and from context. With additional generated
synonyms and related terms that may appear in facility names
or descriptions. For example, "elderly" should also search
"senior", "wellness", "retirement". Combine multiple terms
with spaces or commas for broader matches. Not full sentences.
```
이제 사용자가 "activities for elderly people"이라고 말하면, 오케스트레이터는 검색 인덱스에 "elderly senior wellness retirement activities"를 보낼 수 있어요. 매칭은 여전히 키워드 인덱스가 하지만, AI가 여러분 데이터에 실제로 나타나는 용어까지 커버하도록 쿼리를 미리 확장해 준 거예요.
분명히 해 두자면, 이 방법은 도움이 되는 것이지 기적을 일으키지는 않아요. 검색 인덱스는 여전히 키워드 기반이므로, 확장된 용어가 실제로 데이터에 나타나야 매칭돼요. 설명 텍스트가 사용자가 입력하는 것과 완전히 다른 어휘를 쓴다면, 아무리 동의어를 확장해도 그 간극을 메울 수 없어요. 하지만 어휘가 *어느 정도* 겹치는 대부분의 실제 데이터에서는 AI 확장이 재현율(recall)을 의미 있게 개선해요.
### 페이지네이션 추가하기
대화형 페이지네이션을 위해 다음 세 개의 입력을 추가하세요.
```yaml
- kind: ManualTaskInput
propertyName: item.count
value: true
- kind: ManualTaskInput
propertyName: item.top
value: 10
- kind: AutomaticTaskInput
propertyName: item.skip
name: autogeneratedskip
description: |-
Generate a numeric skip value ONLY when the user request or
conversation context clearly implies pagination (for example:
"next", "more", "previous results").
If no pagination intent is clearly present, return: 0
Rules:
- Return ONLY a non-negative integer.
- Skip represents the number of results to skip before
returning results.
```
`item.top`은 결과를 10개로 제한해요(기본값 50은 채팅에는 너무 많아요). `item.count`는 전체 매칭 수를 반환해서 에이전트가 "27개의 시설을 찾았어요"라고 말할 수 있게 해요. 그리고 `item.skip`은 페이지네이션 의도를 감지해요. 사용자가 "next"라고 말하면 그냥 동작해요. 변수도, 카운터도, 코드도 없어요.
### 특화된 도구 인스턴스
같은 커넥터, 서로 다른 인스턴스, 각각 특정 도메인에 스코프를 맞춰요. 오케스트레이터는 사용자의 질문에 따라 올바른 것을 골라요.
| 도구 이름 | 기본 필터 | 설명이 오케스트레이터에게 알려 주는 것... |
|---|---|---|
| **SearchSeniorServices** | `facilitytype eq 'Senior Centre'` | "senior, elder, retirement, wellness에 대해 물을 때 사용." |
| **SearchYouthPrograms** | `facilitytype eq 'Recreation Centre'` | "youth, children, after-school에 대해 물을 때 사용." |
| **SearchEmergencyFacilities** | `facilitytype eq 'Access Point'` | "긴급 또는 응급 서비스 요청에 사용." |
"우리 할머니에게 웰니스 활동이 필요해요"는 SearchSeniorServices로 라우팅돼요. "우리 아이들이 방과 후에 갈 만한 곳이 있나요?"는 SearchYouthPrograms로 라우팅돼요. 각 인스턴스는 자체 entities JSON, 기본 필터, 설명을 가져요. 이것이 바로 엔터프라이즈 에이전트를 신뢰할 수 있게 만드는 세밀한 제어예요.
---
## 동작 확인 — 강화된 버전
더 똑똑하게 만들기의 모든 개선(보강된 검색 설명, OData 필터링, 페이지네이션, 상세 정보를 위한 List Rows)이 적용된 에이전트의 모습이에요.
### 퍼지 매칭: "Darrl"로 Darrell 찾기
> "Is there a Darrl community center in hillcrest?"
사용자는 철자를 제대로 쓴 적이 한 번도 없어요. 검색 인덱스가 퍼지 매칭으로 이를 자체 처리하고, 보강된 검색 설명이 그 위에 동의어 확장을 더해요. 결과는 "Darrol", "Darryl", "Darrel" — 모두 관련성 순으로 정렬돼요. 정확한 매칭은 필요 없어요.
_퍼지 매칭 동작 모습 — 사용자가 정확한 철자를 몰라도 돼요_
### 시니어 센터 + 페이지네이션
> "show me senier centres with full info including websites"
여기엔 철자 문제가 둘 있어요. "senier"와 영국식 표기 "centres"예요. 인덱스의 퍼지 매칭이 둘 다 처리해요. "senier"는 "senior"에, "centres"는 "centers"에 매칭돼요. 보강된 검색 설명이 관련 용어로 쿼리를 확장할 수도 있지만, 오타 처리의 핵심 역할은 인덱스가 해요.
결과: 웹사이트를 포함한 상세 정보와 함께 관련성 높은 시니어 센터 10곳.
_오타 처리, 영국식 철자 매칭, 상세 정보 반환_
그다음 사용자가 "show me the next 10"이라고 말하면 `item.skip` 입력이 제 역할을 해요. 대화를 통한 페이지네이션, 코드도 카운터도 없어요.
_페이지네이션: 오케스트레이터가 "next"를 감지하고 skip을 자동으로 증가시켜요_
### 지도 링크가 있는 청소년 시설 검색
이건 제가 제일 좋아하는 사례예요. "youth"를 검색하고 상세 정보를 요청하면 — 기분 좋은 일이 일어나요. 에이전트가 원시 위도/경도 좌표를 **클릭 가능한 Bing 지도 링크**로 변환하는 거예요. 어떻게 된 걸까요? 좌표는 List Rows에서 와요. 포맷 지시는 우리가 작성한 List Rows 설명("원시 좌표 대신 클릭 가능한 Bing 지도 링크를 제공하라")에서 와요. 그리고 URL 포맷팅은 모델의 일반 지식이 처리해요.
구조화된 데이터 + 모델 지식 + 사려 깊은 한 줄 지시 = 진정한 사용자 감동.
_"youth" 검색 — 청소년 프로그램이 있는 시설이 즉시 표시돼요_
_상세 정보 — 좌표가 동작하는 지도 링크로 변환된 모습까지_
---
## 마무리
우리는 누군가 "Darol"이라고 입력했을 때 "Darrell"을 찾지 못하는 에이전트에서 시작했어요. 그리고 퍼지 매칭, 순위화된 결과, 클릭 가능한 지도 링크, 적절한 크기의 출력으로 끝맺었어요. 단 한 명의 사용자도 로그인하지 않고서 말이죠. 사려 깊은 설명들. 눈에 보이게 동작을 바꾸는 몇 가지 의도적인 설계 결정들.
검색 인덱스는 처음부터 거기 있었어요. 진짜 솜씨는 그것을 어떻게 다루느냐에 있어요.
여러분은 이걸로 무엇을 만드시겠어요?
### 이 패턴이 빛나는 다른 곳들
시설 디렉터리는 하나의 예일 뿐이에요. searchQuery + List Rows 패턴은 텍스트가 많은 테이블과, 정확한 열 값으로 말하지 않는 사용자가 있는 곳이라면 어디서든 통해요.
- **D365 기술 자료(Knowledge Base) 검색.**
KB 문서에는 Dataverse 검색이 인덱싱할 수 있는 여러 줄 서식 있는 텍스트가 있어요. 제목만이 아니라 문서 *내용*을 퍼지 검색하는 공개용 지원 에이전트를 만들어 보세요.
- **첨부 파일.**
Dataverse 검색은 파일 첨부의 처음 약 2MB 텍스트를 인덱싱해요. 첨부된 PDF가 별도 업로드 없이 같은 도구를 통해 검색 가능해져요.
- **제품 카탈로그.**
"파란색 스탠딩 데스크 같은 거 있나요?" 같은 설명에 대해 퍼지 매칭하고, List Rows로 이미지와 가격을 반환해요.
- **인시던트 조회.**
"최근 브루클린에 수도 관련 문제 있었나요?" 같은 인시던트 설명에 대한 퍼지 검색, 관련성 순위화, 위치별 사후 필터링을 지원해요.
---
## 어휘 주석
1. **벡터 검색·임베딩(vector search / embedding):** 텍스트의 의미를 숫자로 이뤄진 벡터로 바꿔, 정확한 단어 일치가 아니라 '의미가 비슷한 것'을 찾아내는 AI 기반 검색 방식.
2. **OData:** REST API 표준을 따르는 데이터 쿼리·필터링 형식. 이 글의 `$filter` 표현식이 바로 OData 문법이에요.