Capacity와 CU: Fabric 요금이 쿼리 하나에 어떻게 매겨지나
F SKU 용량과 CU, 스무딩·스로틀링 개념을 SQL 사용자 눈높이로 정리했어요. Capacity Metrics 앱에서 어느 워크로드가 CU를 먹는지 보는 법도 함께 봐요.
카드뉴스
1 / 7
원문: Understand the Fabric capacity throttling policy 최종 업데이트: 2026-08-14 · Microsoft Fabric 설명서 팀
Power BI에서 SQL 쿼리를 돌릴 때는 “쿼리가 느리다/빠르다”만 신경 쓰면 됐어요. Fabric으로 넘어오면 갑자기 “이 워크스페이스가 무슨 Capacity에 물려 있냐”, “CU를 얼마나 썼냐” 같은 얘기가 나오기 시작해요. 이건 새로운 과금 언어라기보다, Fabric이 모든 워크로드가 공유하는 컴퓨트 풀을 어떻게 나눠 쓰게 하는지에 대한 이야기예요.
Capacity와 CU — F SKU가 실제로 사는 건 초당 컴퓨트 예산
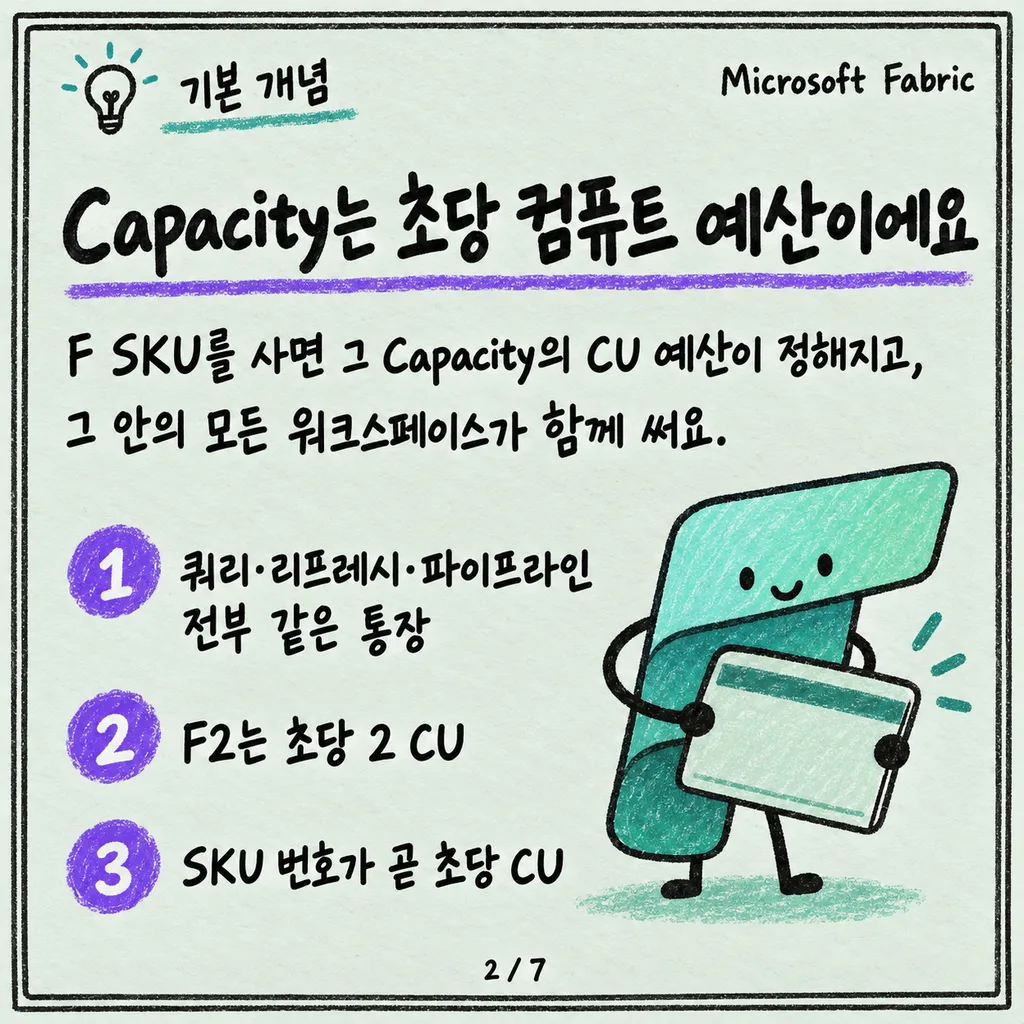
Fabric의 모든 작업(쿼리, 리프레시, 파이프라인, 노트북 실행)은 특정 Capacity1에 물린 워크스페이스 안에서 돌아가요. 어떤 F SKU를 사느냐에 따라 그 Capacity가 쓸 수 있는 Capacity Unit(CU) 예산이 정해지고, 이 예산은 그 Capacity에 속한 모든 워크스페이스·모든 아이템이 공유해요. 즉 SQL analytics endpoint 쿼리, Warehouse 리프레시, Power BI 리포트 렌더링이 전부 같은 CU 통장에서 돈을 빼 쓰는 셈이에요.
버스팅 — 일단 빠르게 끝내고 본다
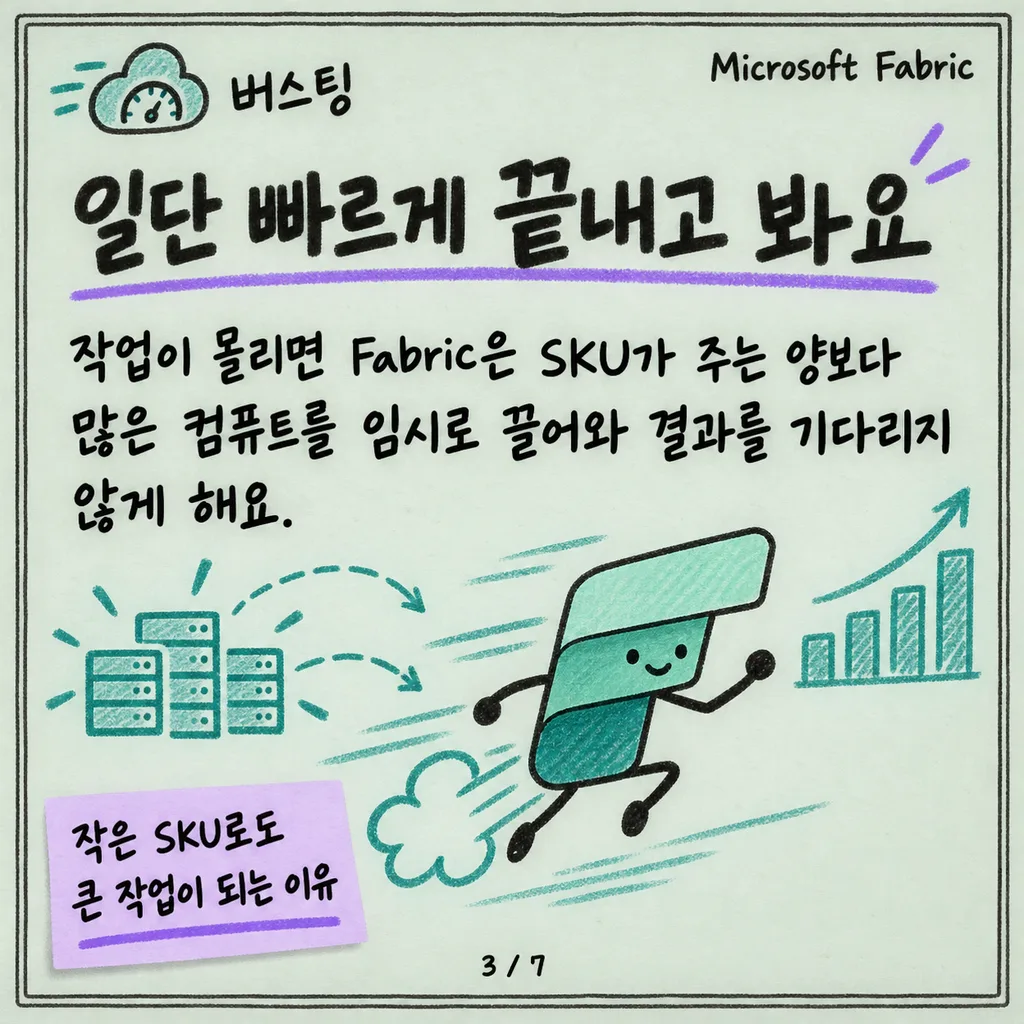
Fabric은 “느리게라도 한도 안에서” 대신 “일단 빠르게” 쪽을 택해요. 이게 **버스팅(bursting)**이에요. 어떤 작업이 순간적으로 몰리면, Fabric은 그 Capacity SKU가 원래 제공하는 양보다 더 많은 컴퓨트를 임시로 끌어다 써서 결과를 기다리지 않게 해줘요. 작은 SKU로도 원래는 더 비싼 SKU가 필요한 큰 작업을 처리할 수 있는 이유가 이거예요.
스무딩 — 쓴 만큼을 미래로 나눠서 갚는다
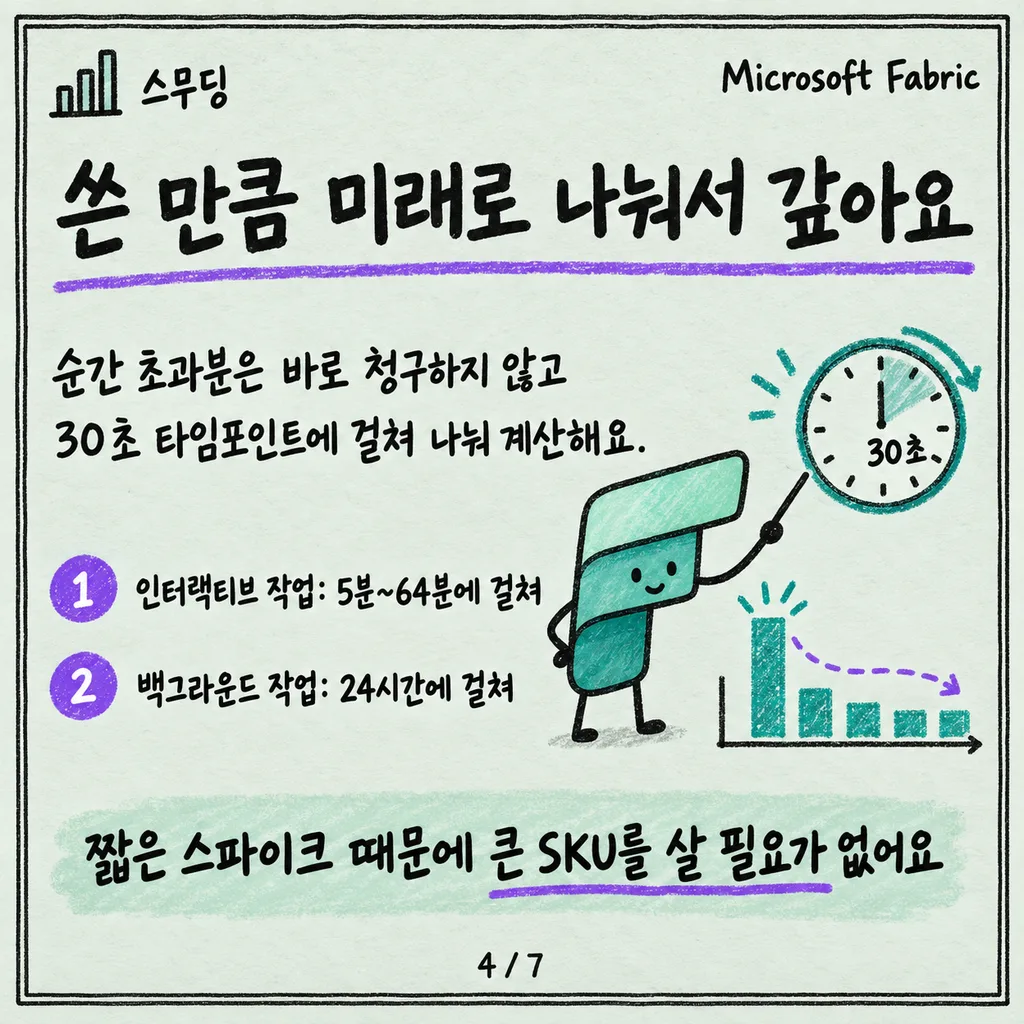
버스팅으로 순간적으로 초과해서 쓴 컴퓨트를, Fabric은 바로 청구하지 않고 **스무딩(smoothing)**이라는 방식으로 시간에 걸쳐 나눠 계산해요. Fabric의 시간 단위는 30초짜리 “타임포인트”이고, 앞으로의 24시간은 2,880개의 타임포인트로 쪼개져요.
- 인터랙티브 작업(사용자가 직접 실행하는 쿼리 등)은 최소 5분, 최대 64분에 걸쳐 스무딩돼요.
- 백그라운드 작업(예약된 리프레시 등)은 실행 시간이 길고 소비량이 큰 편이라 24시간에 걸쳐 스무딩돼요.
문서에 나오는 예시를 그대로 옮기면 이해가 빨라요. F2 Capacity(초당 2 CU)에서 1 CU-hour(=3,600 CU-초)짜리 백그라운드 작업 하나가 돌았다고 해봐요. F2는 하루에 48 CU-hour(2 CU × 24시간)를 쓸 수 있으니, 이 작업은 하루 전체 예산의 약 2.1%에 해당해요. 스무딩은 이 3,600 CU-초를 2,880개 타임포인트에 걸쳐 고르게 뿌리기 때문에, 순간적으로는 실제 사용량의 6배에 달하는 작업이었는데도 10분 스로틀링 한도에는 약 2.1%만 반영돼요. 이 덕분에 짧은 스파이크 때문에 더 큰 SKU를 살 필요가 없어져요.
그래도 넘치면 — 스로틀링 3단계
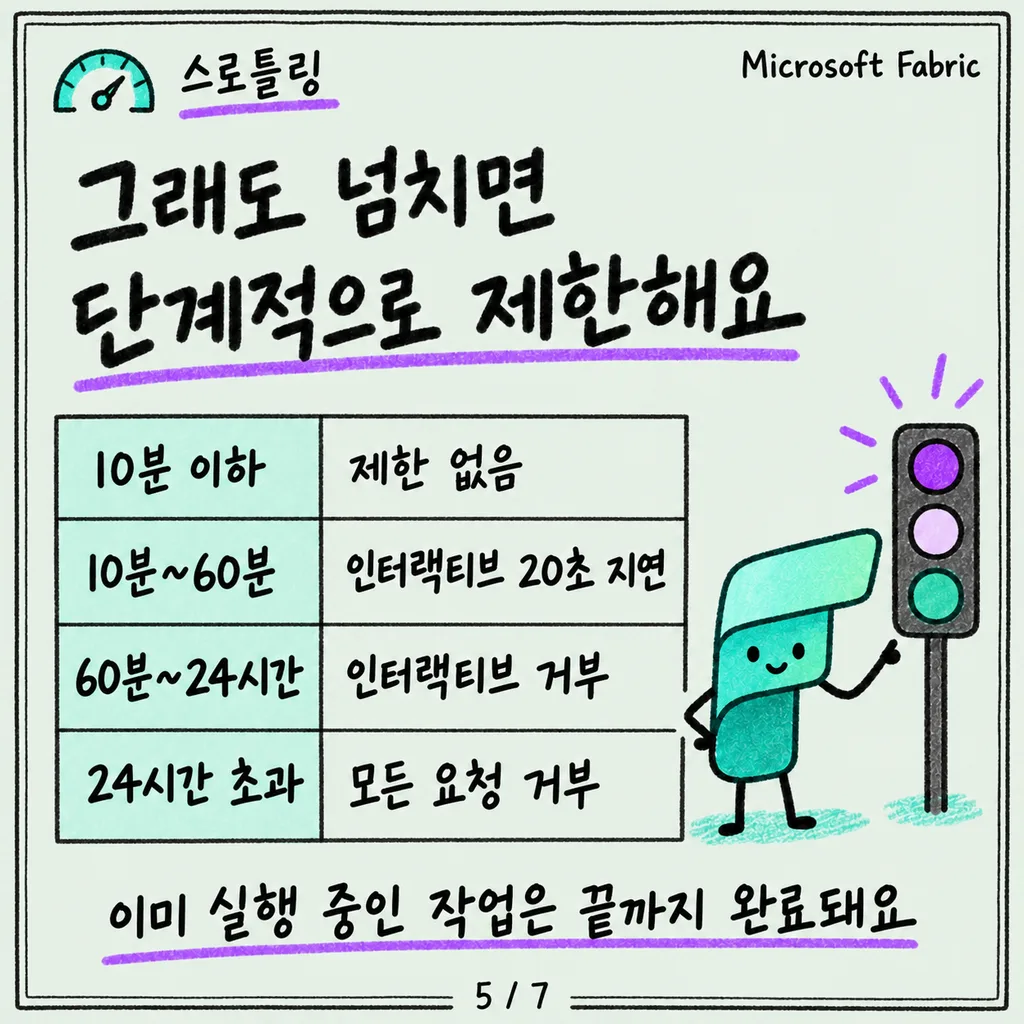
버스팅과 스무딩이 있어도, 계속 과부하가 걸리면 결국 **스로틀링(throttling)**이 시작돼요. Fabric은 앞으로 10분치 CU 자원을 전부 써버린 시점부터 단계적으로 제한을 걸어요.
| 사용량 | 정책 한도 | 실제 영향 |
|---|---|---|
| 10분 이하 | Overage protection | 스로틀링 없이 미래 10분치를 미리 당겨 씀 |
| 10분 초과 ~ 60분 | Interactive delay | 새 인터랙티브 작업 제출을 20초 지연 |
| 60분 초과 ~ 24시간 | Interactive rejection | 인터랙티브 작업 거부(백그라운드는 계속 실행) |
| 24시간 초과 | Background rejection | 모든 신규 요청 거부 |
한 가지 유의할 점은, 이미 실행 중인 작업(in-flight)은 스로틀링이 걸려도 끝까지 완료된다는 거예요. 스로틀링은 그 시점 이후에 “새로” 들어오는 요청에만 적용돼요.
Capacity Metrics 앱으로 범인 찾기
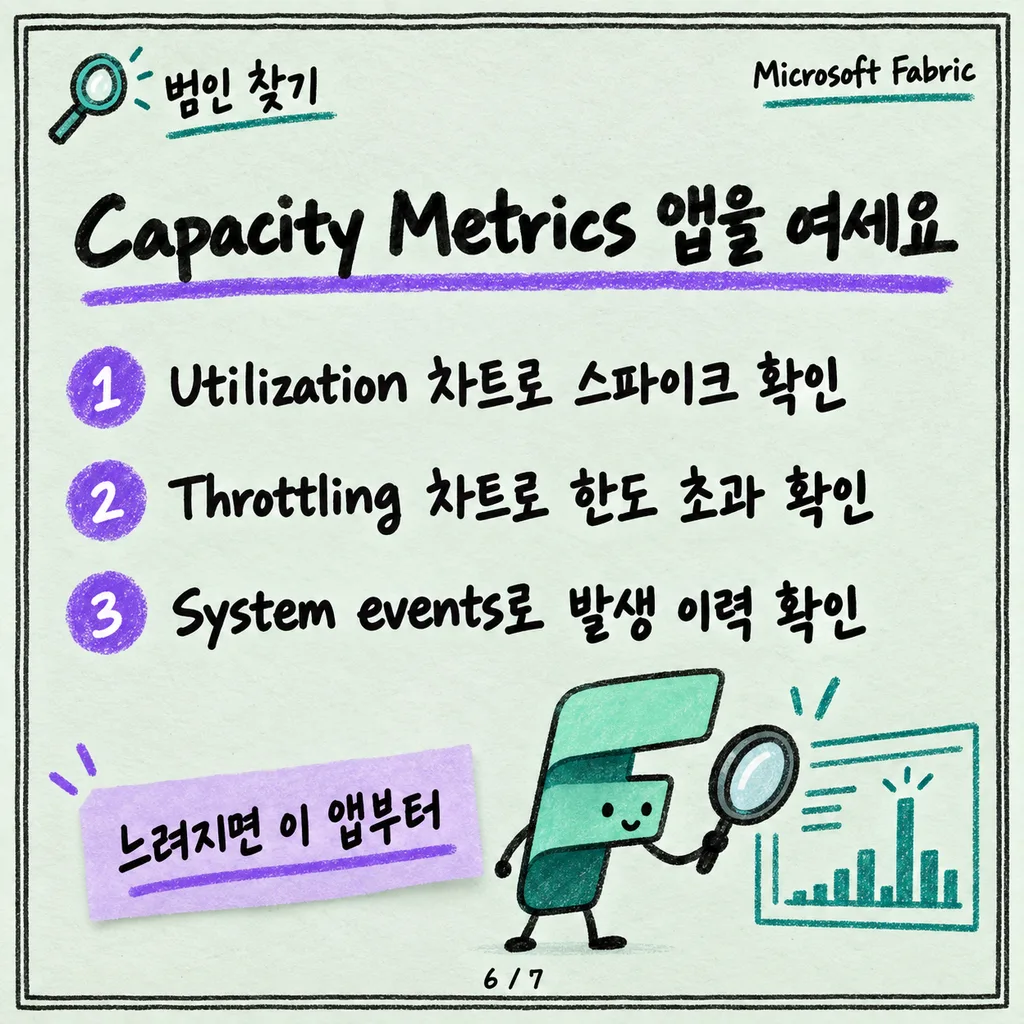
“어느 워크로드가 CU를 먹고 있나”를 알아내는 도구가 Microsoft Fabric Capacity Metrics 앱이에요.
- Utilization 차트로 기준선을 넘는 스파이크(overage)를 확인하고, 특정 타임포인트로 드릴스루해서 그 시점에 어떤 인터랙티브/백그라운드 작업이 몰렸는지 볼 수 있어요.
- Throttling 차트는 스무딩된 사용량이 10분·60분·24시간 한도 중 어디를 넘었는지 보여주고, burndown(초과분을 다 갚는 데 걸리는 시간) 추정치도 함께 제공해요.
- System events 테이블은 실제 스로틀링이 발생한 이력을 보여줘요.
- 스로틀링으로 거부된 요청은 실행되지 않았기 때문에 정보가 제한적이지만, 어떤 제품·사용자·요청 시각이었는지는 확인할 수 있어요.
스로틀링이 났을 때 할 수 있는 것
F SKU 기준으로 문서가 제시하는 대응은 이래요.
- 일시적으로 SKU를 올린다 — 타임포인트마다 여유 컴퓨트가 늘어나 캐리포워드를 더 빨리 갚을 수 있어요.
- Capacity를 일시 중지했다가 재개한다 — 재개 시점에는 미래 사용량이 0으로 초기화돼 바로 새 요청을 받을 수 있어요(단, 중지 중에는 콘텐츠가 이용 불가능해질 수 있으니 사용 중이 아닌지 먼저 확인해야 해요).
- Capacity overage를 켜서 초과 사용을 자동으로 정산할 수도 있지만, 이 경우 정상 요금의 3배가 청구돼요.
정리
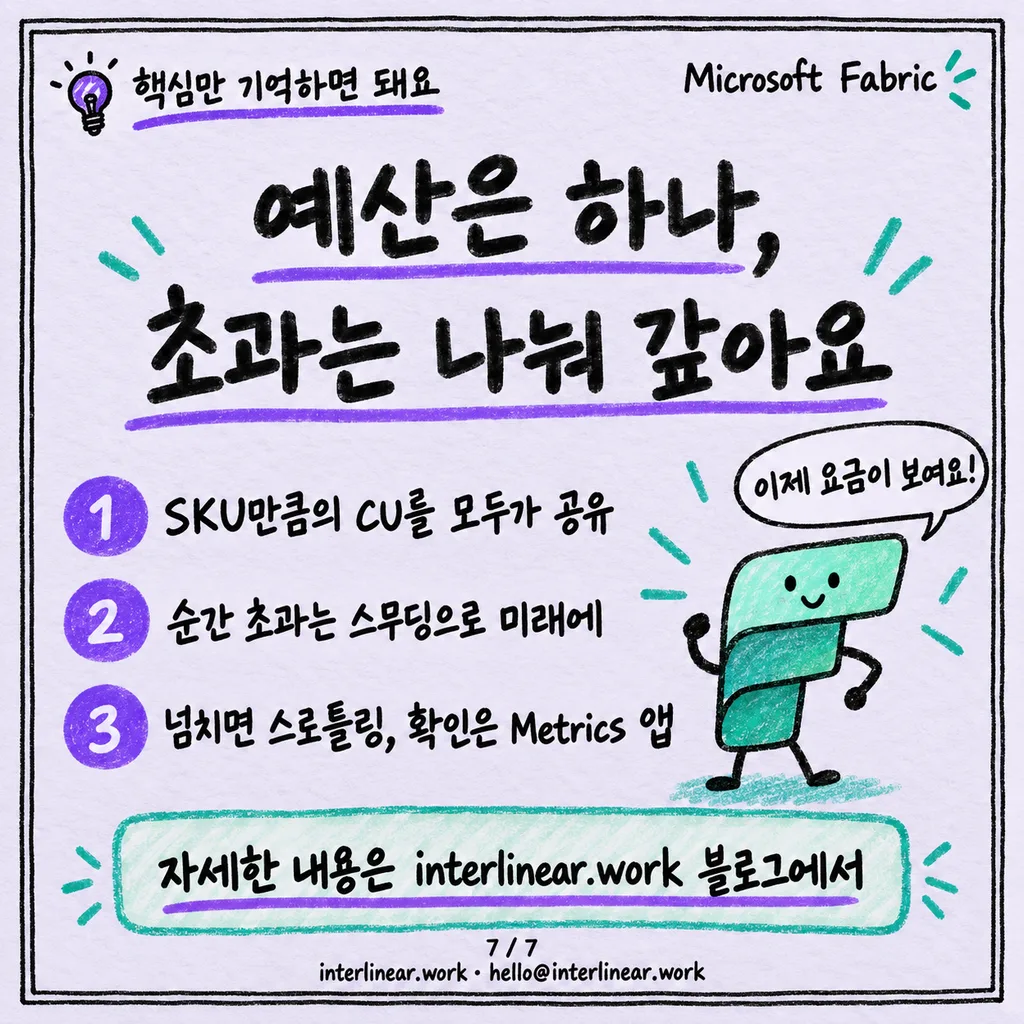
Fabric의 과금·성능 모델은 결국 “SKU만큼의 초당 CU 예산을 모든 워크로드가 나눠 쓰고, 순간 초과분은 스무딩으로 미래에 나눠 갚다가, 그마저 넘치면 단계적으로 스로틀링한다”는 한 문장으로 요약돼요. 쿼리가 갑자기 느려지거나 거부될 때는 Capacity Metrics 앱의 Utilization·Throttling 차트부터 열어보는 게 원인을 찾는 가장 빠른 길이에요.
어휘 주석
- Capacity: Fabric 워크스페이스가 물리는 컴퓨트 자원 풀. F SKU(F2, F64 등) 단위로 구매하며, 그 안의 모든 워크스페이스·아이템이 CU 예산을 공유해요.
- CU(Capacity Unit): Fabric의 컴퓨트 사용량을 세는 단위. SKU 번호가 곧 초당 제공되는 CU 수와 대략 일치해요(F2 → 2 CU/초).
- 타임포인트(timepoint): Fabric이 사용량을 계산하는 30초 단위 시간 구간. 스무딩·스로틀링 계산이 모두 이 단위로 이뤄져요.