Data agent 답이 자꾸 틀릴 때: 지침과 예시 쿼리로 잡는 법
Data agent 정확도는 스키마 이름만으로는 안 올라가요. 데이터 소스 지침, 스키마 설명, 예시 쿼리를 어디에 어떻게 적어야 하는지 Microsoft 공식 가이드 기준으로 정리했어요.
카드뉴스
1 / 7
원문: Best practices for improving data agent query generation 게시일: 2026-08-27 · 저자: Scott Polly
Fabric data agent를 만들어 봤다면 한 번쯤 겪었을 거예요. 테이블 이름도 멀쩡하고 컬럼도 다 있는데, 자꾸 엉뚱한 조인을 하거나 필터를 빠뜨린 쿼리를 만들어요. 원인은 대부분 “스키마 이름만으로는 설명이 안 되는 정보”가 어디에도 안 적혀 있어서예요. 테이블 이름과 스키마 메타데이터는 출발점일 뿐, 비즈니스 의미나 기대 값, 관계, 쿼리 로직까지 설명해 주진 않거든요. 이 글은 그 빈틈을 채우는 네 가지 설정 — 스키마 선택, 스키마 설명, 데이터 소스 지침, 예시 쿼리 — 을 언제 어떻게 쓰는지 정리한 글이에요.
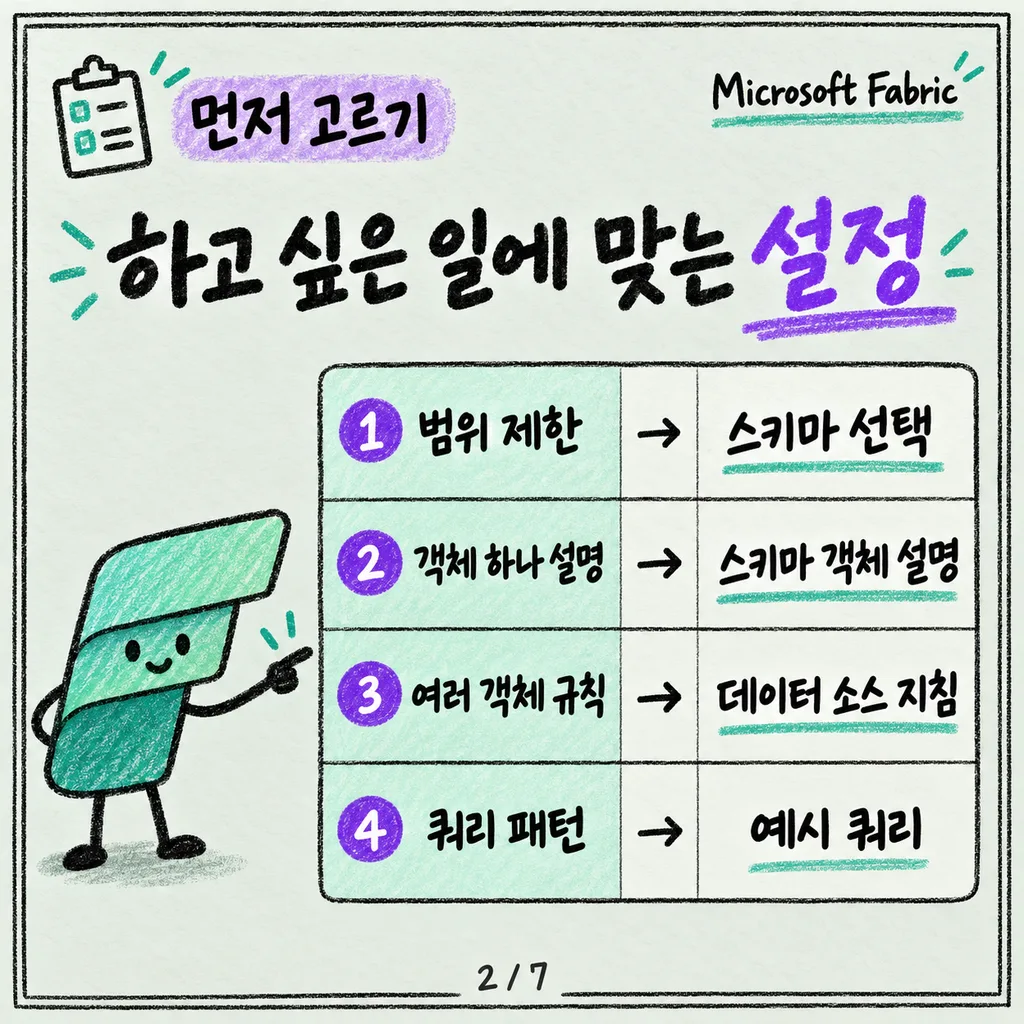
어떤 설정을 써야 할지부터 정해요
목적에 따라 손댈 설정이 달라요.
| 하고 싶은 일 | 쓸 설정 |
|---|---|
| 에이전트가 조회할 데이터 범위를 제한하고 싶다 | 스키마 선택 |
| 테이블·컬럼 하나의 의미를 설명하고 싶다 | 스키마 객체 설명 |
| 여러 객체에 걸친 비즈니스 규칙·관계를 정의하고 싶다 | 데이터 소스 지침 |
| 특정 질문의 쿼리 패턴을 직접 보여주고 싶다 | 예시 쿼리 |
스키마 이름과 범위부터 정리해요
이름을 직접 정할 수 있다면 CustomerOrders, order_submission_date처럼 설명적인 이름을 쓰는 게 Table1, date1보다 훨씬 유용한 신호가 돼요. 다만 이름이 아무리 명확해도 업무 맥락, 단위, 유효 값까지 전달하진 못하니 이름만 믿지 말고 설명과 지침으로 보완해야 해요.
선택한 스키마 범위도 좁힐수록 좋아요. 예를 들어 사용자가 “현재 고객 주문”을 묻는다면, 보관용 스테이징 테이블이나 무관한 재무 테이블은 아예 빼는 게 맞아요. 비슷한 데이터를 담은 객체가 두 개 있다면 어느 쪽이 “정본”인지, 언제 어느 쪽을 써야 하는지도 명시해 주세요.
스키마 객체 설명 — 이름만으로 안 될 때(미리보기)
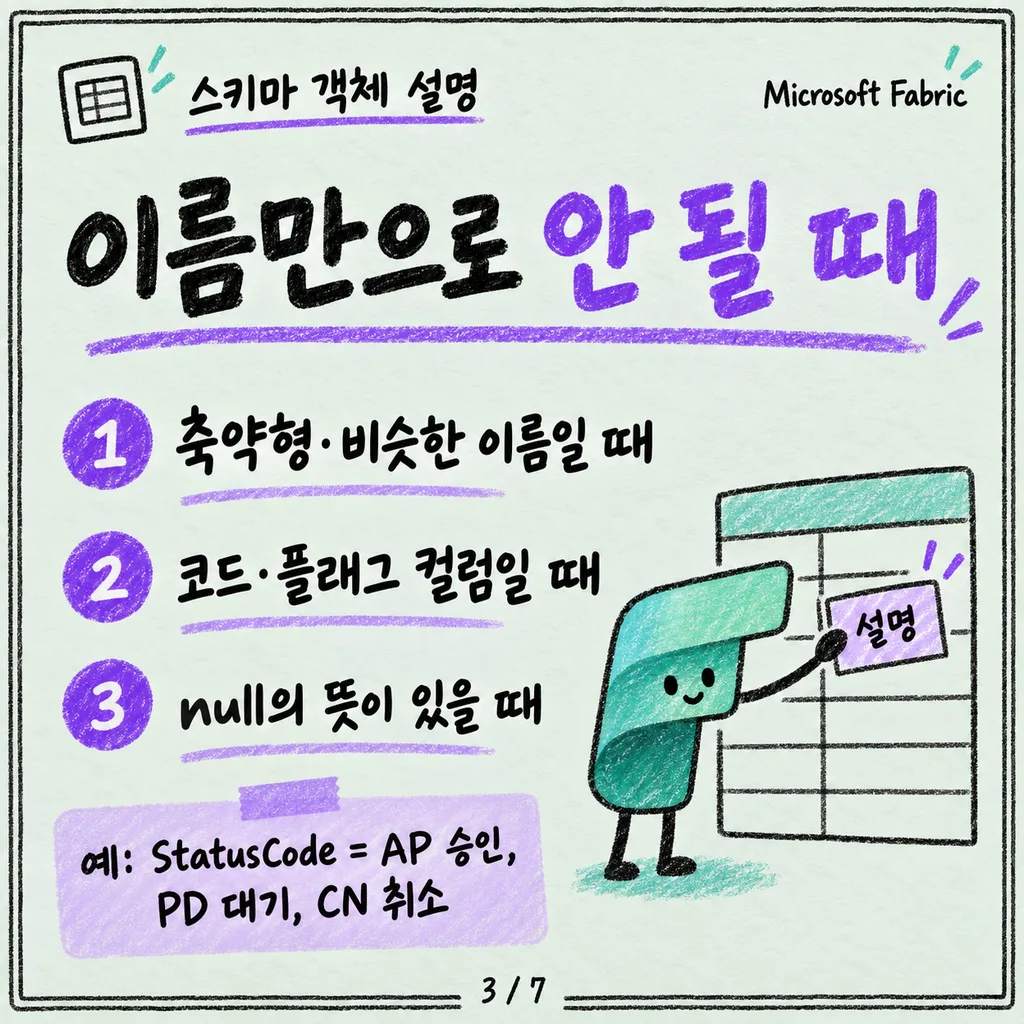
객체 이름이 축약형이거나 서로 비슷할 때, 코드·플래그 컬럼처럼 해석이 필요한 값이 있을 때는 스키마 객체 설명1을 씁니다. 이 기능은 data agent가 미리보기 런타임을 쓸 때만 사용할 수 있어요.
예시로 이런 식이에요.
| 스키마 객체 | 효과적인 설명 |
|---|---|
AdoptionEvents |
완료된 입양 건마다 한 행씩 담는다. 완료일은 AdoptionDate를 쓴다. |
StatusCode |
입양 진행 상태. 기대 값은 AP(승인), PD(대기), CN(취소)이다. |
Weight |
현재 동물 체중(kg). null이면 측정값이 없다는 뜻이다. |
이름만 반복하는 설명은 의미가 없어요. 유추하기 어려운 객체에 집중해서 설명을 붙이는 게 효율적이에요.
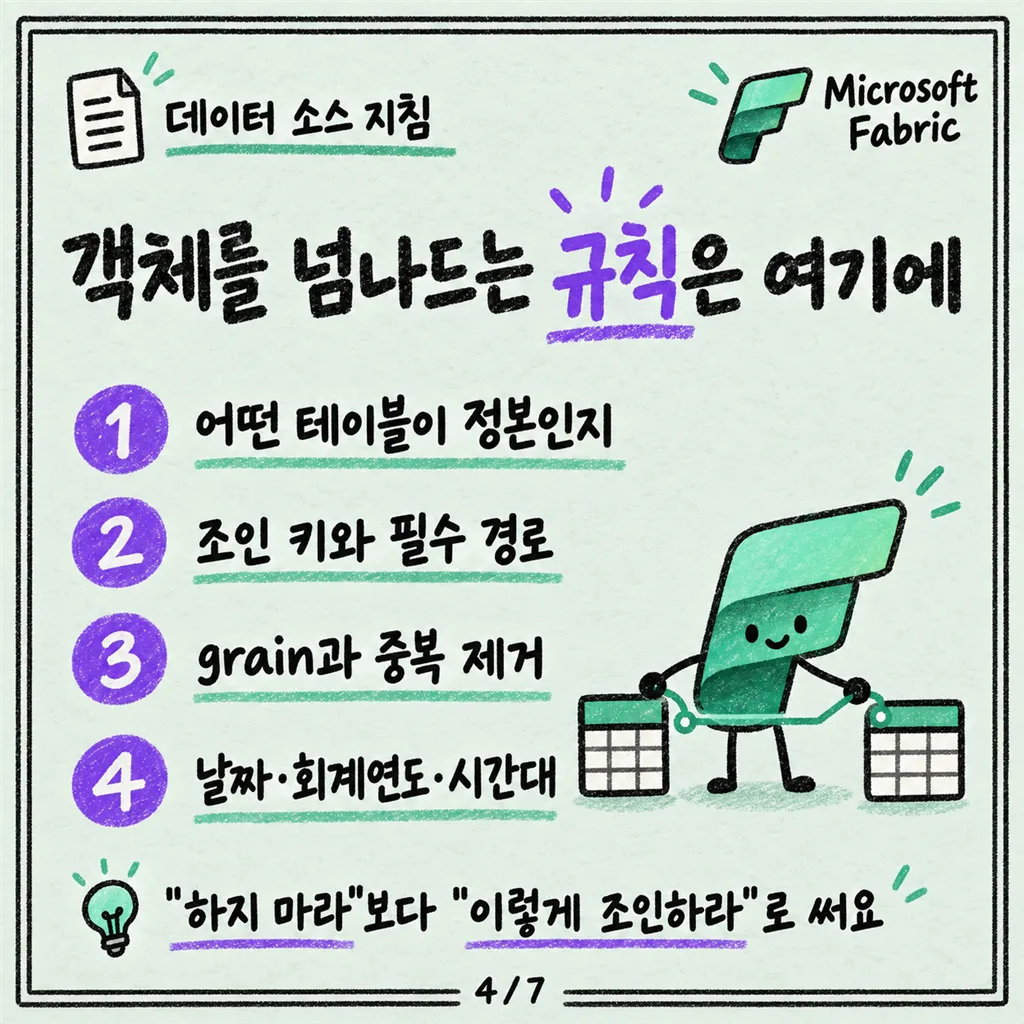
데이터 소스 지침 — 객체를 넘나드는 규칙
데이터 소스 지침2은 특정 소스 전체에 적용되는 쿼리 생성 규칙을 담는 자리예요. 여러 객체에 걸친 맥락이나 쿼리 구성 방식을 여기 적어요.
- 어떤 테이블이 특정 주제의 정본인지
- 조인 키와 필수 조인 경로
- 테이블의 grain(행 하나가 무엇을 의미하는지)과 중복 제거 규칙
- “현재·활성 레코드만 사용” 같은 기본 필터
- 날짜 로직, 회계연도, 시간대 가정
지침은 “직원 테이블을 잘못 조인하지 마라”처럼 하지 말아야 할 것을 나열하기보다, “EmployeeStatusFact를 EmployeeID로 EmployeeDim에 조인하라”처럼 해야 할 행동을 직접 지시하는 문장으로 쓰는 게 효과적이에요. 객체 하나에만 해당하는 정의는 지침이 아니라 스키마 객체 설명에 넣어서, 지침 공간을 모든 테이블의 용어집으로 낭비하지 않는 게 좋아요.
비즈니스 용어와 값의 의미를 정의해요
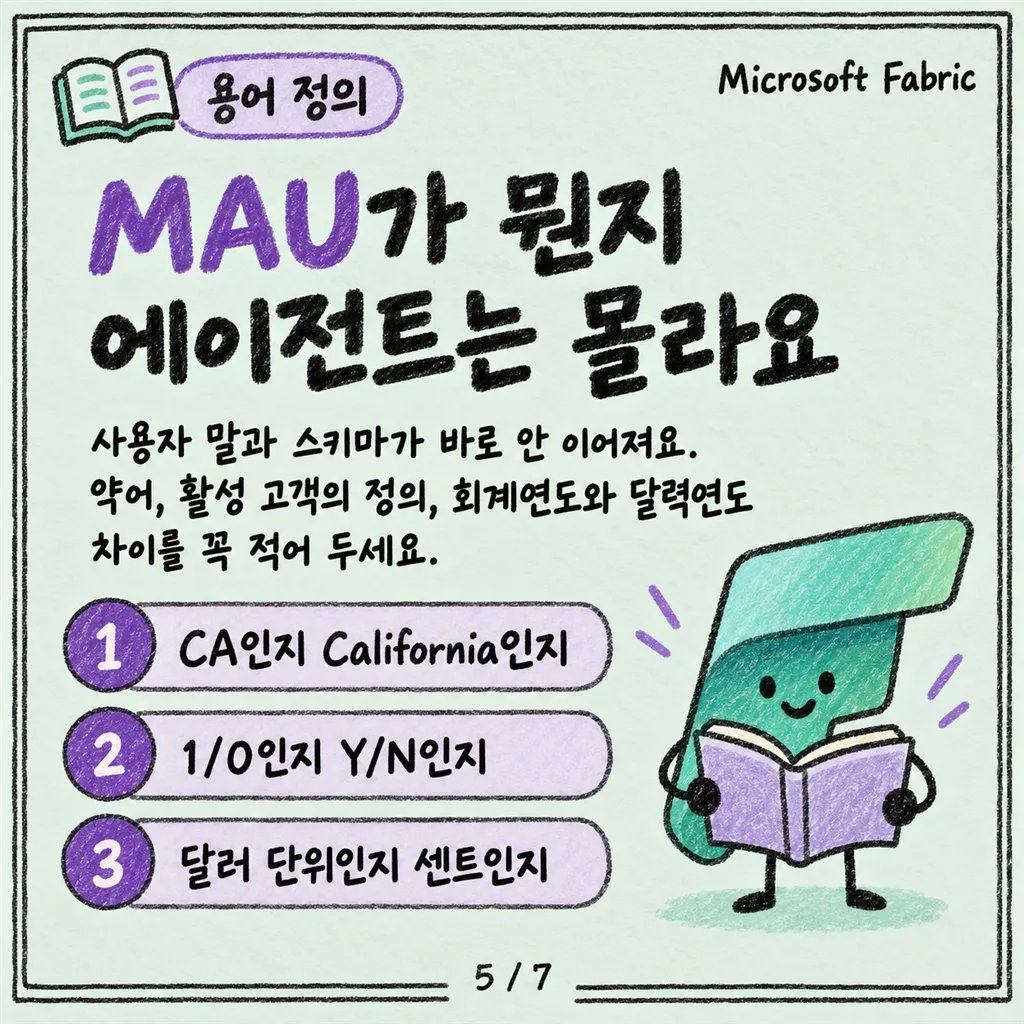
사용자가 질문에 쓰는 말이 스키마와 바로 매핑되지 않을 때가 많아요. “MAU” 같은 약어, 조직마다 다른 “활성 고객”의 정의, 회계연도와 달력연도의 차이 같은 게 대표적이에요. 다음도 꼭 문서화해 두세요.
- 상태 컬럼이
"CA"를 쓰는지"California"를 쓰는지 - 불리언 값이
1/0인지Y/N인지 텍스트인지 - 통화 값이 달러 단위인지 센트 단위인지
- 어떤 상태 값이 완료·취소·활성을 의미하는지
한 객체에만 해당하면 스키마 객체 설명에, 여러 객체·복합 쿼리 로직에 걸치면 데이터 소스 지침에 넣으세요.
조인·grain은 예시 쿼리로 보여주세요
정확한 조인은 컬럼 이름이 같다고 저절로 되는 게 아니에요. 중요한 테이블의 grain, 유효한 관계 경로, 메타데이터만으로 드러나지 않는 키를 짚어줘야 해요. 판매 테이블이 주문 하나당 한 행인지, 주문 라인마다 한 행인지, 일별 상품 합계인지에 따라 조인 방식이 완전히 달라지거든요.
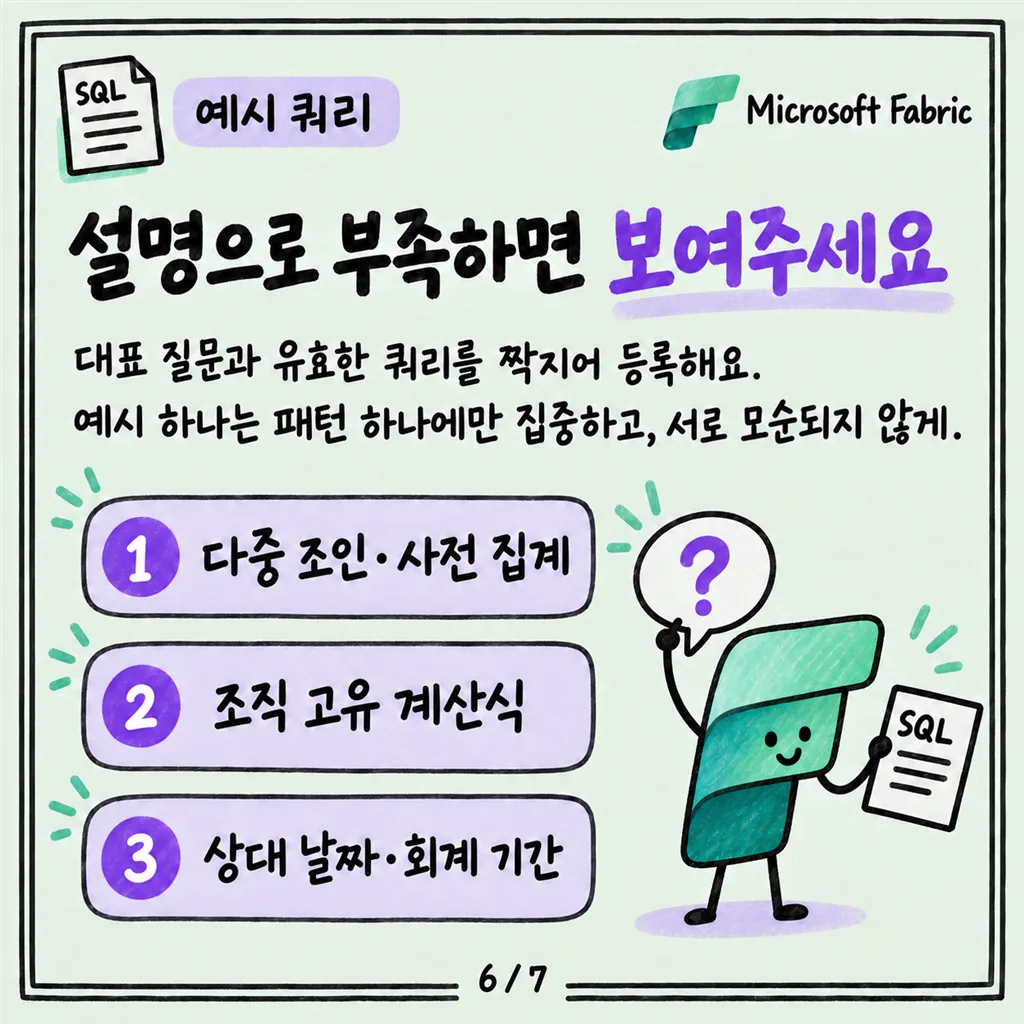
설명으로 부족하면 예시 쿼리로 직접 보여주는 게 나아요. 대표적인 자연어 질문과, 그 패턴을 보여주는 유효한 쿼리를 짝지어 등록하는 방식이에요. 우선순위를 둘 만한 케이스는 이래요.
- 다중 테이블 조인이나 사전 집계가 필요한 경우
- 조직 고유의 계산식
- 상대 날짜, 회계 기간, 스냅샷 로직
- 사용자 용어를 저장된 값으로 매핑하는 필터
- 순위·윈도 함수 같은 복잡한 패턴
예시 하나는 재사용 가능한 패턴 하나에만 집중하고, 서로 겹치거나 모순되는 예시는 피하며, 스키마가 바뀌면 예시도 최신 상태인지 다시 확인해야 해요.
테스트하고 다듬는 과정을 반복해요
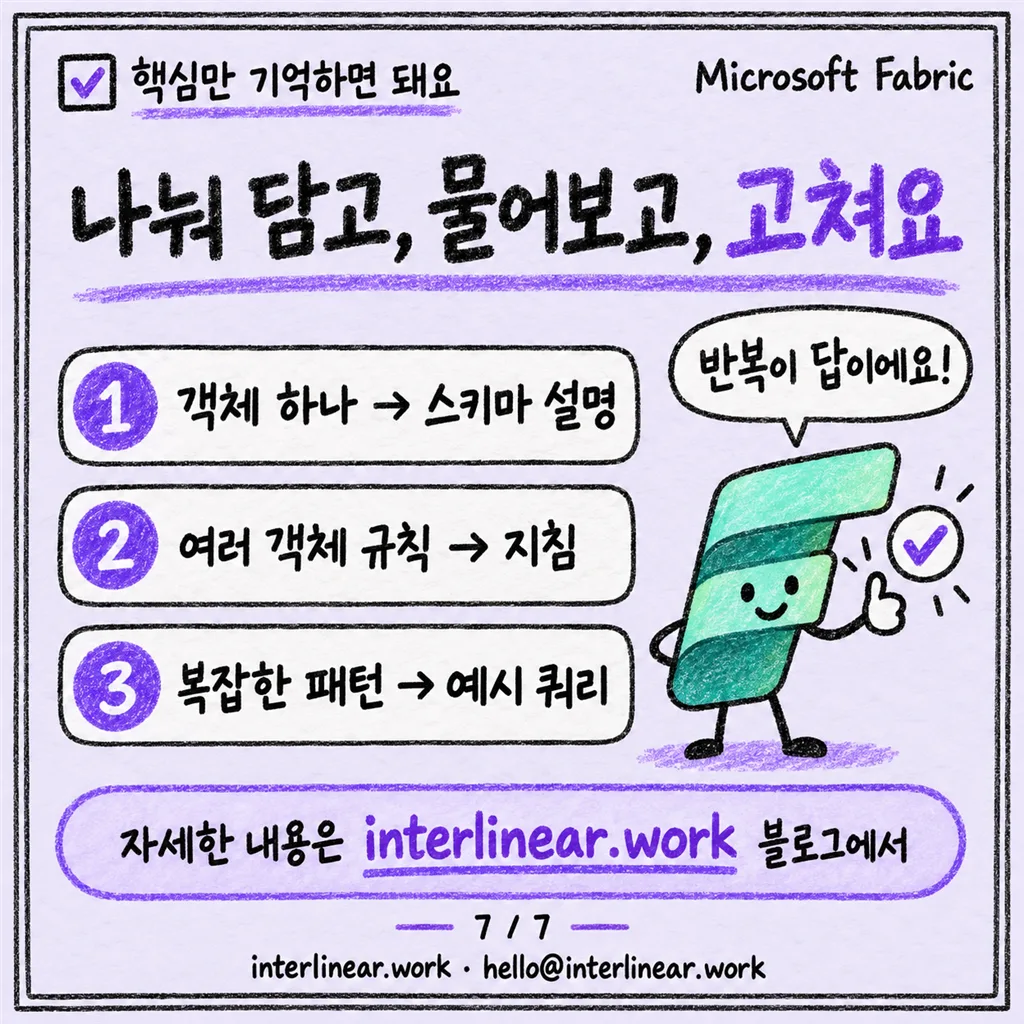
대표 질문을 실제로 던져보고 생성된 쿼리를 확인한 뒤, 어떤 맥락이 빠졌는지 파악해서 문제에 가장 가까운 설정을 고치세요. 무관한 객체는 스키마 선택에서 빼거나 추가하고, 한 객체의 의미가 불분명하면 스키마 설명을 다듬고, 여러 객체에 걸친 로직이 빠졌으면 데이터 소스 지침을 보강하고, 특정 쿼리 패턴을 못 배우면 예시 쿼리를 추가하는 식이에요. 스키마와 사용자 질문이 계속 바뀌는 만큼, 이 과정도 한 번으로 끝내지 말고 반복하는 게 맞아요.
정리
Data agent가 틀린 쿼리를 만드는 건 대부분 “이름만으로는 알 수 없는 정보”가 어딘가 빠져 있기 때문이에요. 객체 하나의 의미는 스키마 설명에, 여러 객체에 걸친 규칙은 데이터 소스 지침에, 복잡한 쿼리 패턴은 예시 쿼리에 나눠 담고, 실제 질문으로 테스트하며 가장 가까운 설정을 고쳐나가는 게 정확도를 올리는 가장 확실한 방법이에요.
어휘 주석
- 스키마 객체 설명(schema object descriptions): 테이블·컬럼 같은 개별 스키마 요소에 붙이는 설명. data agent가 미리보기 런타임을 쓸 때만 지원되는 기능이다.
- 데이터 소스 지침(data source instructions): 특정 데이터 소스 전체에 적용되는, 여러 객체에 걸친 비즈니스 규칙·조인 로직을 담는 설정.