Dataflow Gen2, Pipeline, Notebook — 뭐로 옮기고 뭐로 변환하나
Fabric의 데이터 이동·변환 도구 세 가지를 사용자·데이터 양·오케스트레이션 기준으로 나눠 봤어요. 첫 프로젝트에서 어떤 조합을 쓰면 되는지도 제안해요.
카드뉴스
1 / 7
원문: Fabric decision guide - copy activity, dataflow, Eventstream, or Spark 최종 업데이트: 2025-06-04 · Microsoft Fabric 설명서 팀
Fabric 워크스페이스를 처음 열면 데이터를 옮기고 바꿀 수 있는 방법이 한둘이 아니에요. Pipeline의 Copy activity, Dataflow Gen2, Notebook(Spark) — 다 “데이터를 여기서 저기로 보낸다”는 점은 같아 보이는데, 실제로는 대상 사용자와 데이터 양, 변환 복잡도가 꽤 다르게 설계돼 있어요. 공식 결정 가이드는 이 도구들을 사용자 페르소나·기술 스킬셋·데이터 양·변환 복잡도라는 몇 가지 기준으로 정리해요.
누가 쓰나 — 페르소나로 먼저 갈라보기
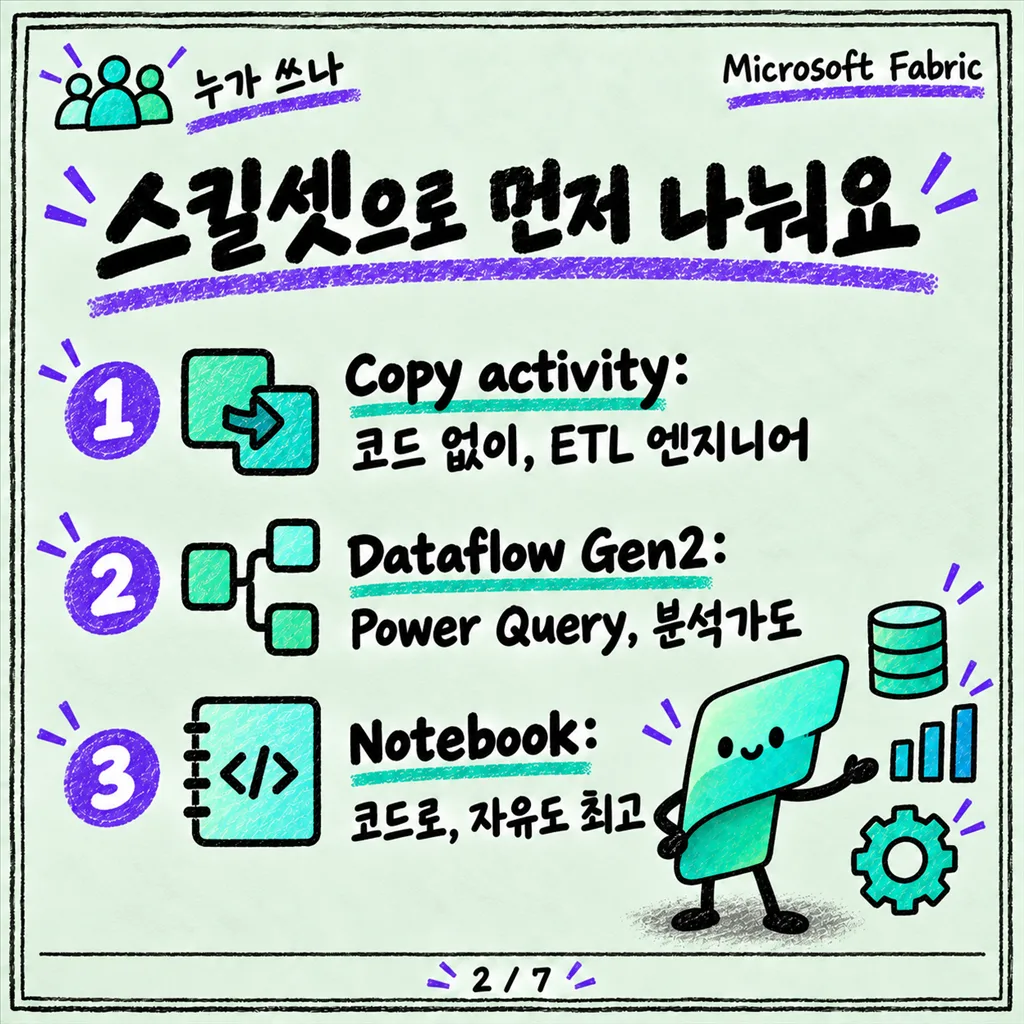
- Pipeline copy activity는 데이터 엔지니어·데이터 통합자를 위한 도구예요. ETL, SQL, JSON 정도의 스킬셋을 가정하고, 코드 없이(no-code, low-code) 캔버스와 마법사로 조작해요.
- Dataflow Gen2는 Power Query에 익숙한 사람을 겨냥해요. 데이터 엔지니어뿐 아니라 비즈니스 분석가도 대상 사용자에 포함돼요. Power Query(M 언어)와 SQL 정도의 스킬셋이면 충분하고, 개발 화면 자체가 Power Query 편집기예요.
- **Notebook(Spark)**은 코드를 직접 짤 수 있는 사람을 위한 도구예요. Scala, Python, Spark SQL, R 중 하나로 코드를 작성해야 하고, 그만큼 표현할 수 있는 변환의 자유도도 가장 높아요.
즉 “우리 팀에 Spark 짤 사람이 있는가”, “Power Query에 능숙한 분석가가 있는가”만 먼저 따져도 셋 중 후보가 확 좁혀져요.
데이터 양과 변환 복잡도
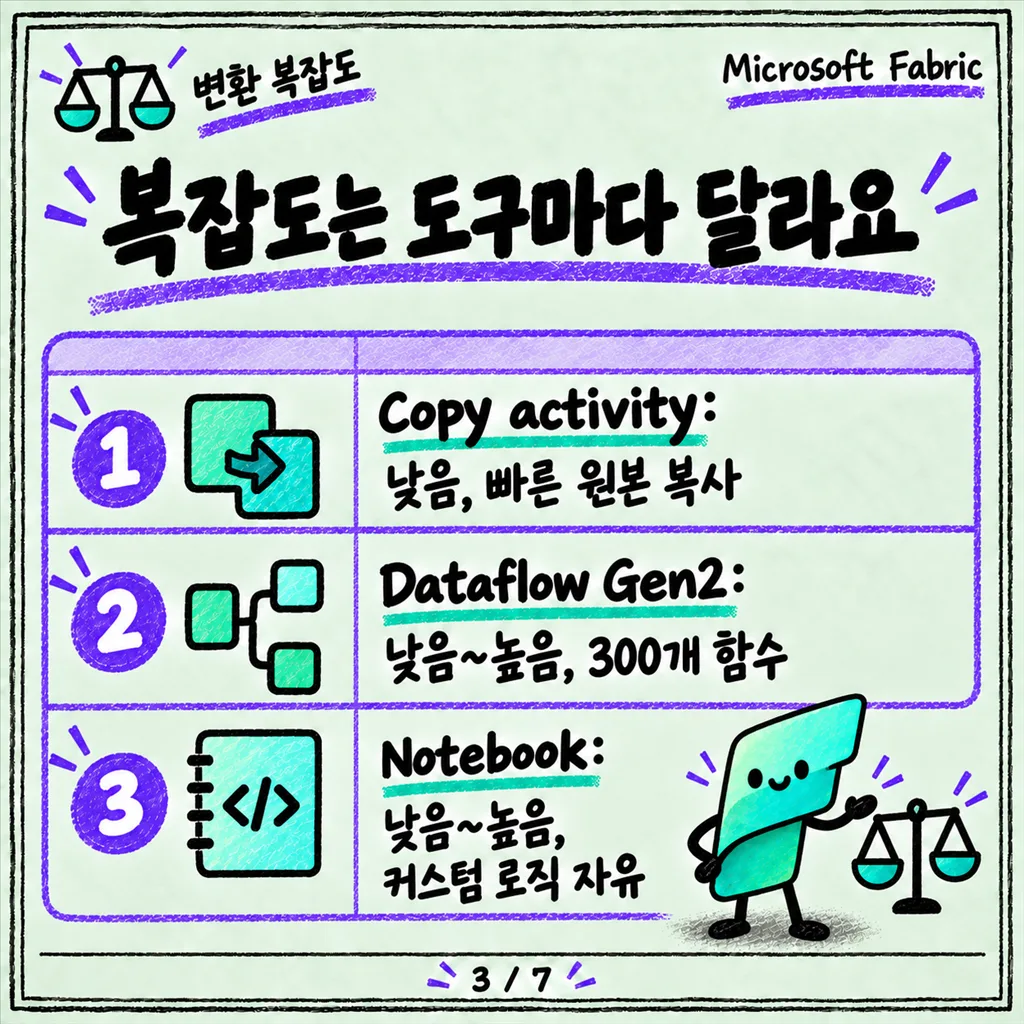
가이드의 비교표를 보면 셋 다 “낮음~높음(low to high)” 데이터 양을 처리할 수 있다고 나와 있지만, 변환 복잡도 쪽은 성격이 갈려요.
- Copy activity는 변환 복잡도가 낮아요. 타입 변환, 컬럼 매핑, 파일 합치기/나누기, 계층 구조 펼치기(flatten) 정도의 가벼운 변환만 지원해요. 대신 원본 그대로를 빠르고 안정적으로 옮기는 데는 강해요.
- Dataflow Gen2는 300개 이상의 변환 함수를 Power Query 인터페이스로 제공해서, 낮음부터 높음까지 폭넓은 변환 복잡도를 커버해요. 다만 볼륨이 낮음~중간일 때 원하는 성능을 내기 좋다고 안내돼요.
- **Notebook(Spark)**은 변환 복잡도가 낮음부터 높음까지 전부 가능하고, 오픈소스 Spark 라이브러리를 자유롭게 붙일 수 있어요. 대용량 병렬 처리와 커스텀 로직이 필요할 때 선택지가 돼요.
오케스트레이션이 필요한가
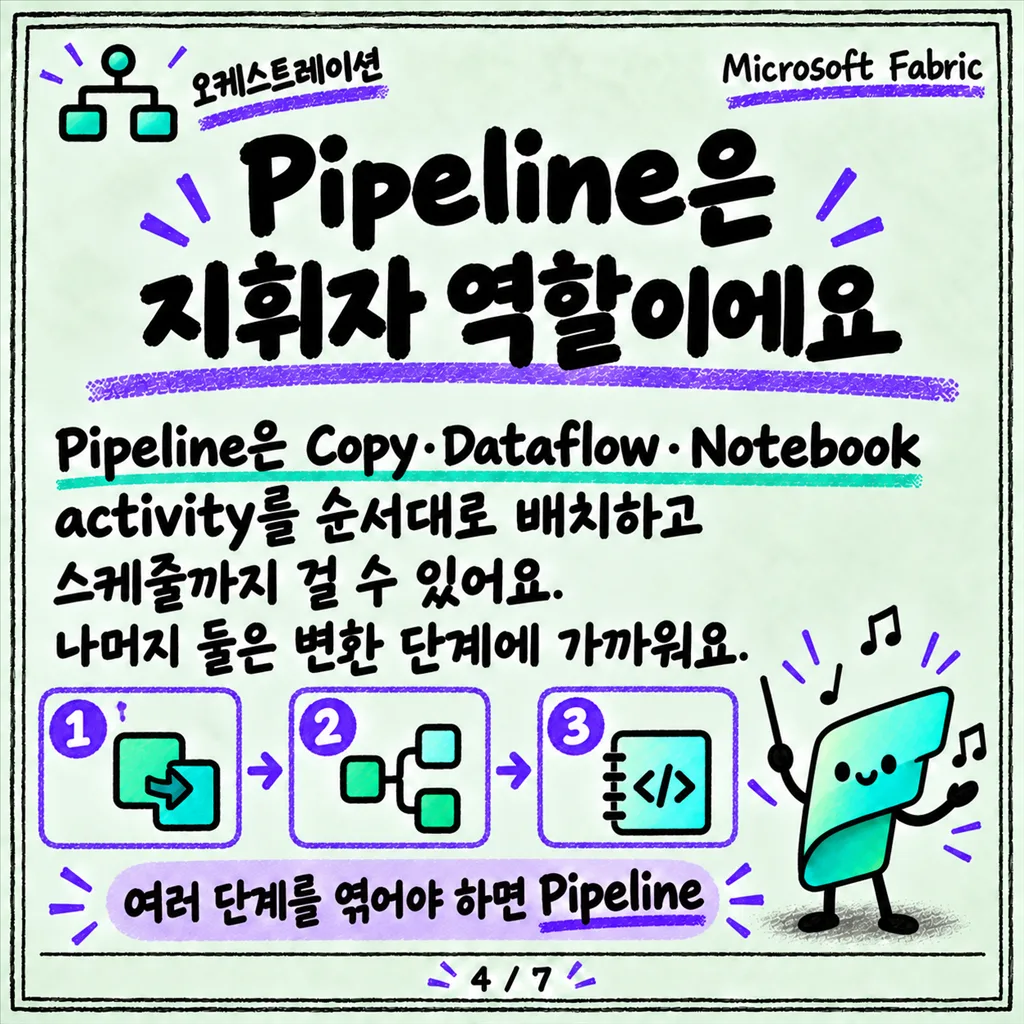
여기서 중요한 구분이 하나 더 있어요. Pipeline은 그 자체로 오케스트레이션 도구라는 점이에요. 캔버스 위에서 Copy activity, Dataflow activity, Notebook activity를 순서대로 배치하고 스케줄을 걸 수 있어요. 반면 Dataflow Gen2와 Notebook은 각각 하나의 변환 단계에 가깝고, 필요하면 Pipeline 안의 액티비티로 호출돼 더 큰 흐름의 한 부분이 돼요. “여러 단계를 스케줄대로 엮어야 하는가”가 Pipeline을 쓸지 말지를 가르는 또 다른 기준인 셈이에요.
시나리오로 보는 선택 기준
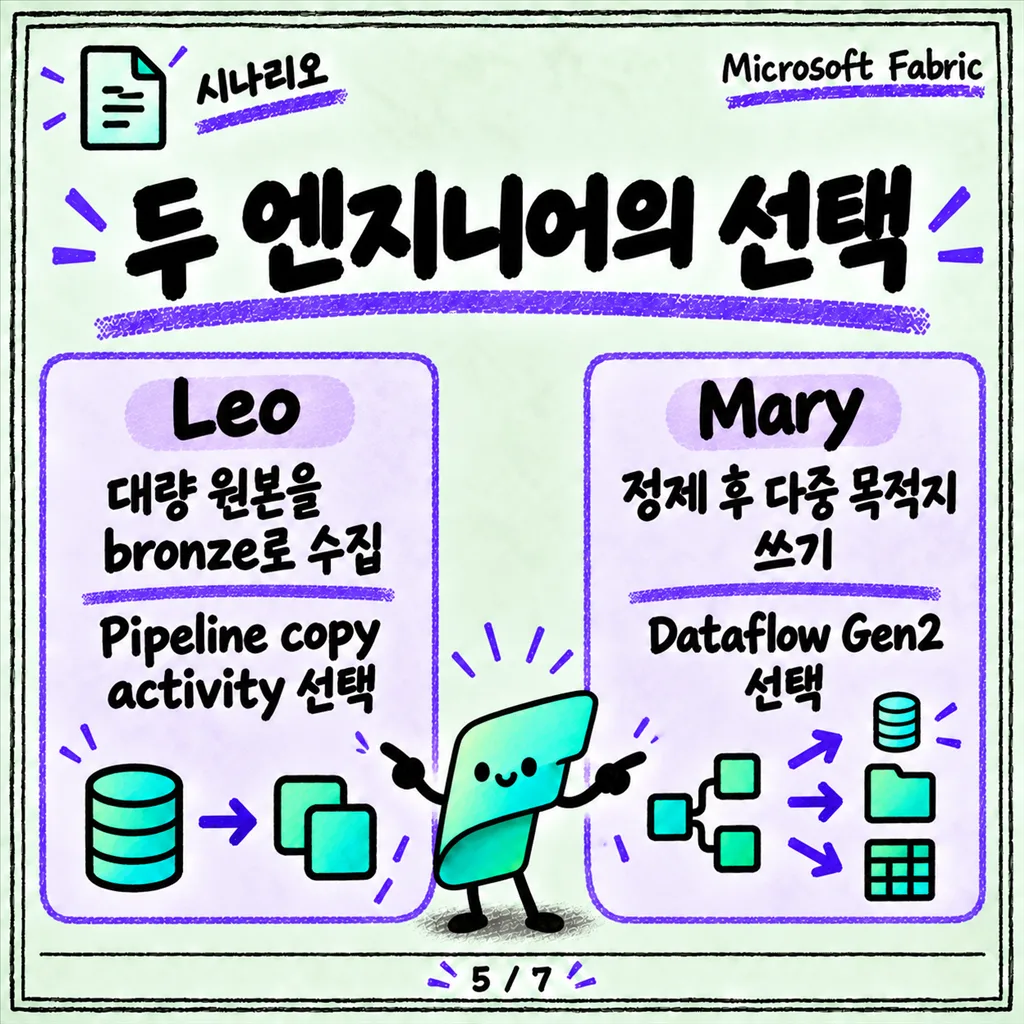
가이드에 실린 예시 시나리오 중 두 가지가 특히 실무 감각을 잘 보여줘요.
- **Leo(데이터 엔지니어)**는 온프레미스·클라우드를 가리지 않고 대량의 원본 데이터를 bronze 레이크하우스로 모아야 했어요. Spark 경험은 없고, 드래그 앤 드롭으로 최대한 코드 없이 처리하고 싶어 했죠. 그는 Pipeline copy activity를 선택했어요 — 페타바이트급 데이터도 low-code로 옮길 수 있고, 이력·증분 적재 패턴에 모두 맞았기 때문이에요.
- **Mary(데이터 엔지니어)**는 이미 bronze에 모인 데이터를 정제해서 비즈니스 로직을 적용하고, 여러 리포팅 대상(SQL database, ADX, 레이크하우스)에 나눠 써야 했어요. Power Query에 능숙하고 데이터 양이 낮음~중간이었던 그는 Dataflow Gen2를 골랐어요 — 300개 넘는 변환 옵션과 다중 목적지 쓰기를 시각적으로 처리할 수 있었기 때문이에요.
첫 프로젝트라면 이렇게 조합해보기
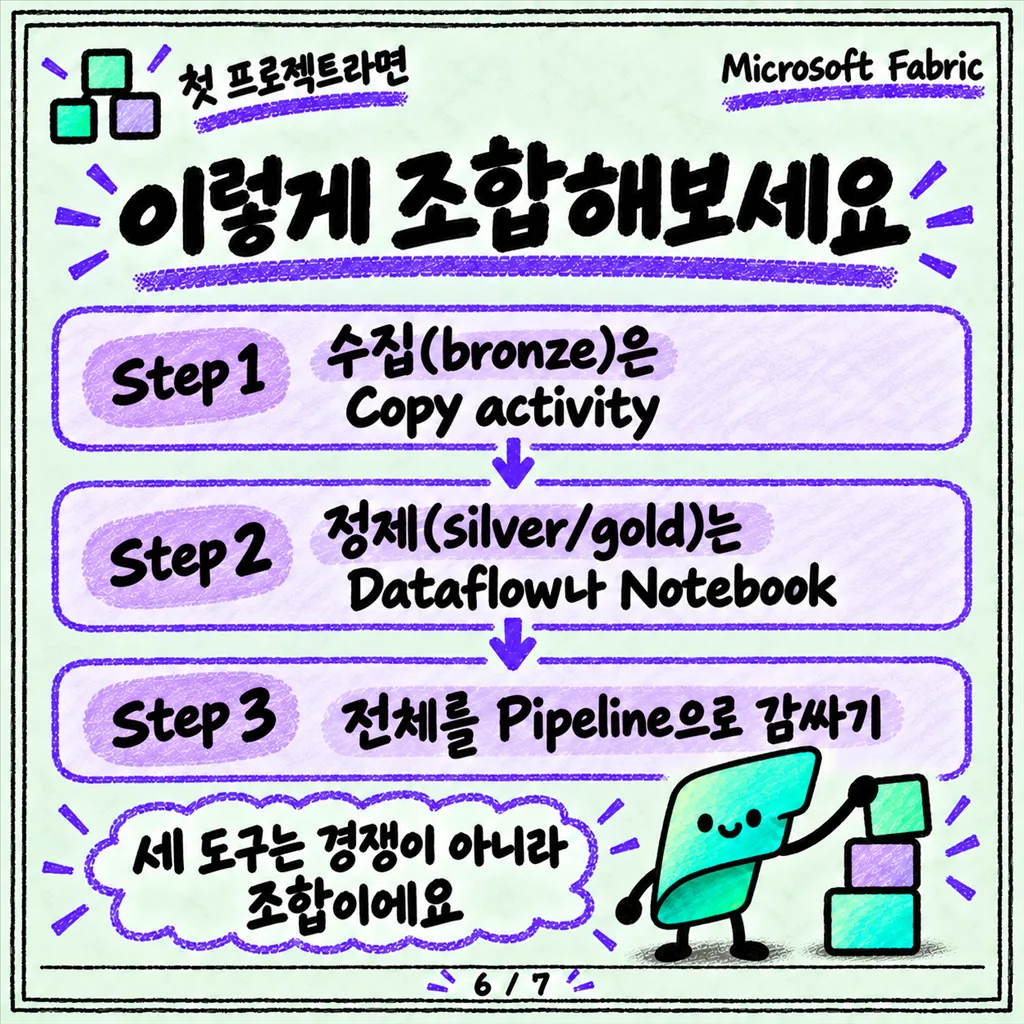
세 도구는 경쟁 관계가 아니라 한 파이프라인 안에서 역할을 나눠 갖는 경우가 더 많아요.
- **원본 수집(bronze)**은 Pipeline의 Copy activity로 시작하세요. 온프레미스든 클라우드든 커넥터가 많고, 원본을 있는 그대로 빠르게 가져오는 데 최적화돼 있어요.
- **정제·비즈니스 로직 적용(silver/gold)**은 팀에 Power Query 경험자가 있다면 Dataflow Gen2로, 대용량이거나 커스텀 로직·오픈소스 라이브러리가 필요하다면 Notebook(Spark)으로 처리하세요.
- 이 단계들을 정해진 순서·스케줄로 묶어야 한다면, 전체를 Pipeline 하나로 감싸고 그 안에서 Copy activity → Dataflow activity → Notebook activity를 차례로 호출하세요.
정리
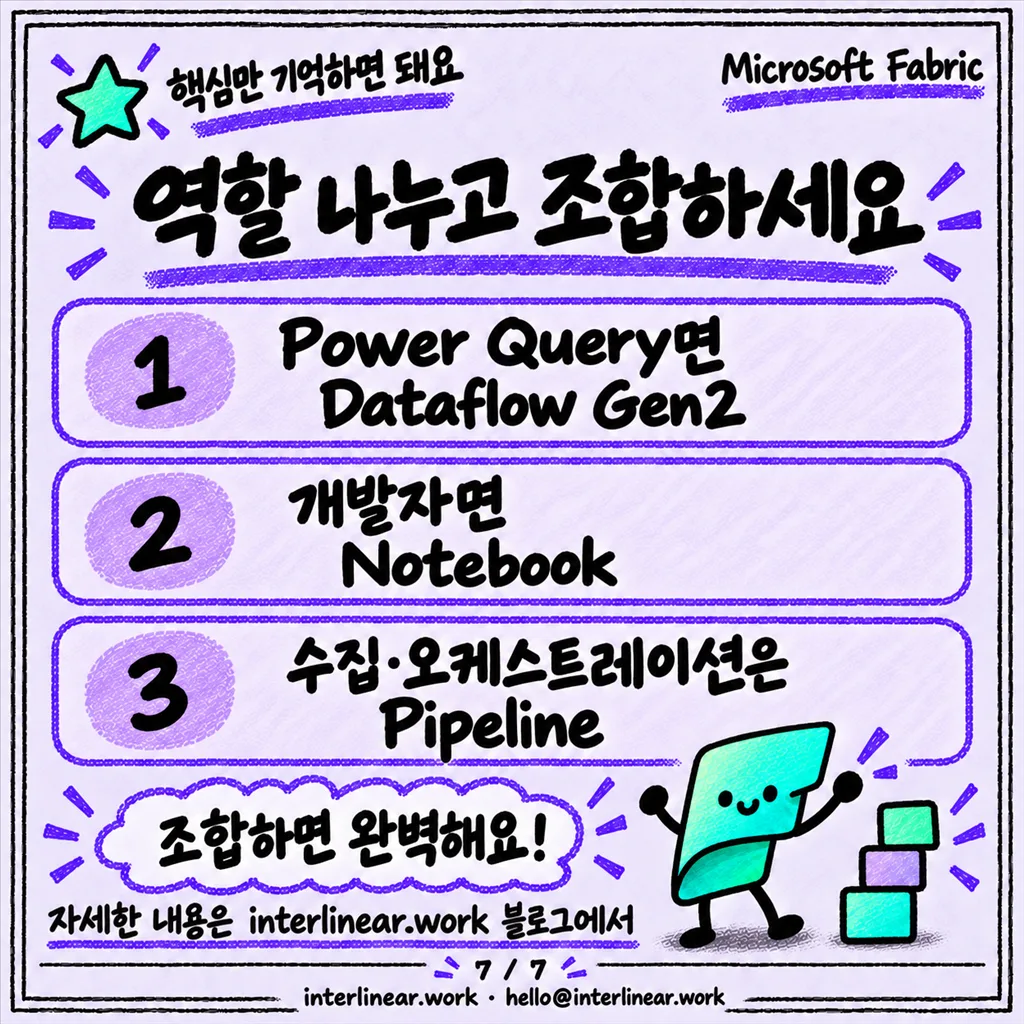
세 도구는 “누가 만드는가”와 “얼마나 복잡한 변환이 필요한가”로 먼저 나뉘어요. Power Query 사용자면 Dataflow Gen2, 개발자면 Notebook, 오케스트레이션과 대량 원본 수집이 필요하면 Pipeline의 Copy activity를 기본으로 두고, 실제로는 이 셋을 한 Pipeline 안에서 조합해 쓰는 경우가 가장 흔해요.
어휘 주석
- 메달리온 아키텍처(medallion architecture): 원본 데이터를 bronze(원본 그대로) → silver(정제) → gold(집계·비즈니스 로직 적용) 세 계층으로 단계적으로 다듬어가는 레이크하우스 설계 패턴.