Lakehouse냐 Warehouse냐, 처음 고를 때 보는 기준
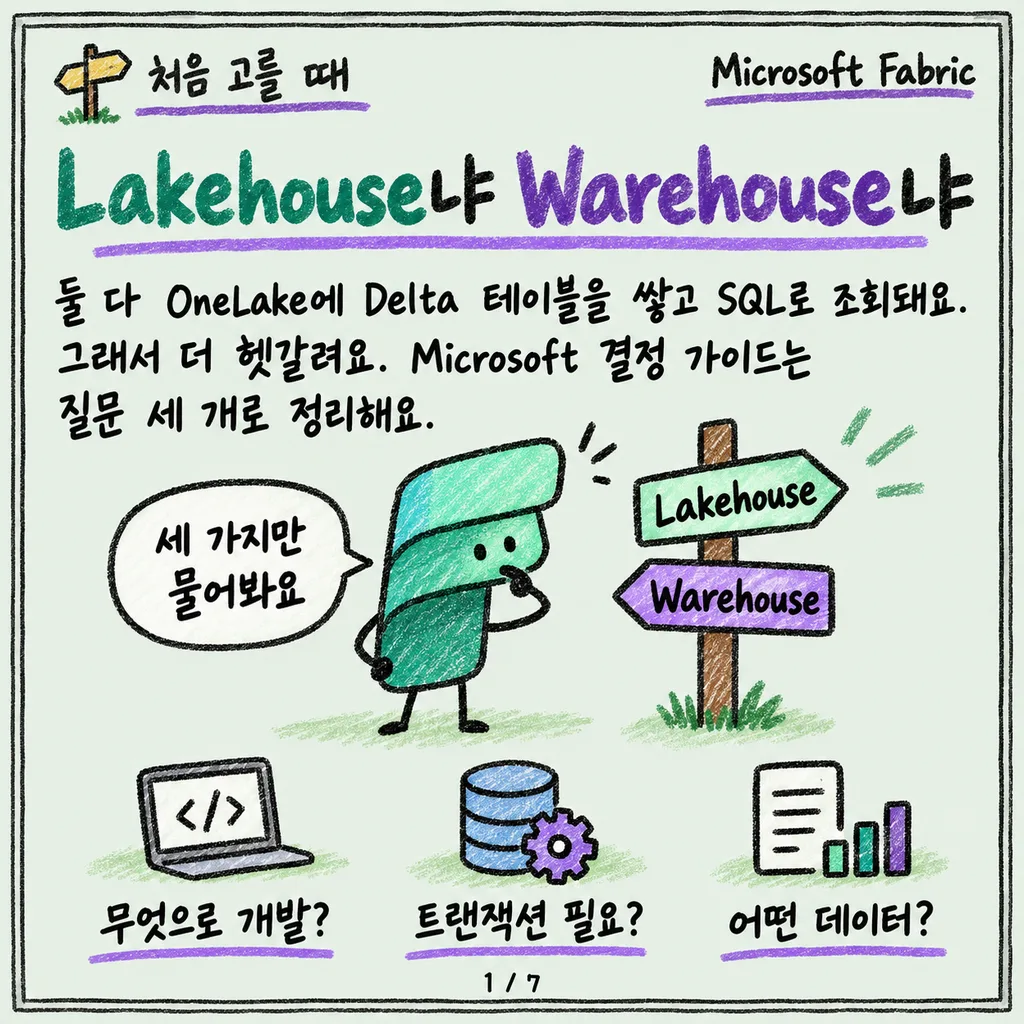
둘 다 OneLake에 Delta 테이블을 쌓지만 쓰기 주체와 트랜잭션 지원이 달라요. Microsoft 공식 결정 가이드를 기준으로 SQL 개발자와 Spark 경험자가 각각 어디로 가야 하는지 정리했어요.
카드뉴스
1 / 7
원문: Microsoft Fabric decision guide: choose between Warehouse and Lakehouse 게시일: 2024-08-20 · 저자: William D. Assaf
Fabric을 처음 켜고 새 아이템을 만들려고 하면 목록에 Lakehouse와 Warehouse가 나란히 떠요. 둘 다 OneLake 위에 Delta 포맷으로 데이터를 저장하고, 둘 다 SQL analytics endpoint로 조회할 수 있어요. 그래서 더 헷갈려요 — 겉보기엔 비슷한데 뭘 기준으로 골라야 할까요?
Microsoft가 낸 공식 결정 가이드는 질문 세 개로 정리해요. 이 글은 그 기준을 SQL DBA 출신과 Spark 경험자 각각의 시선으로 풀어볼게요.
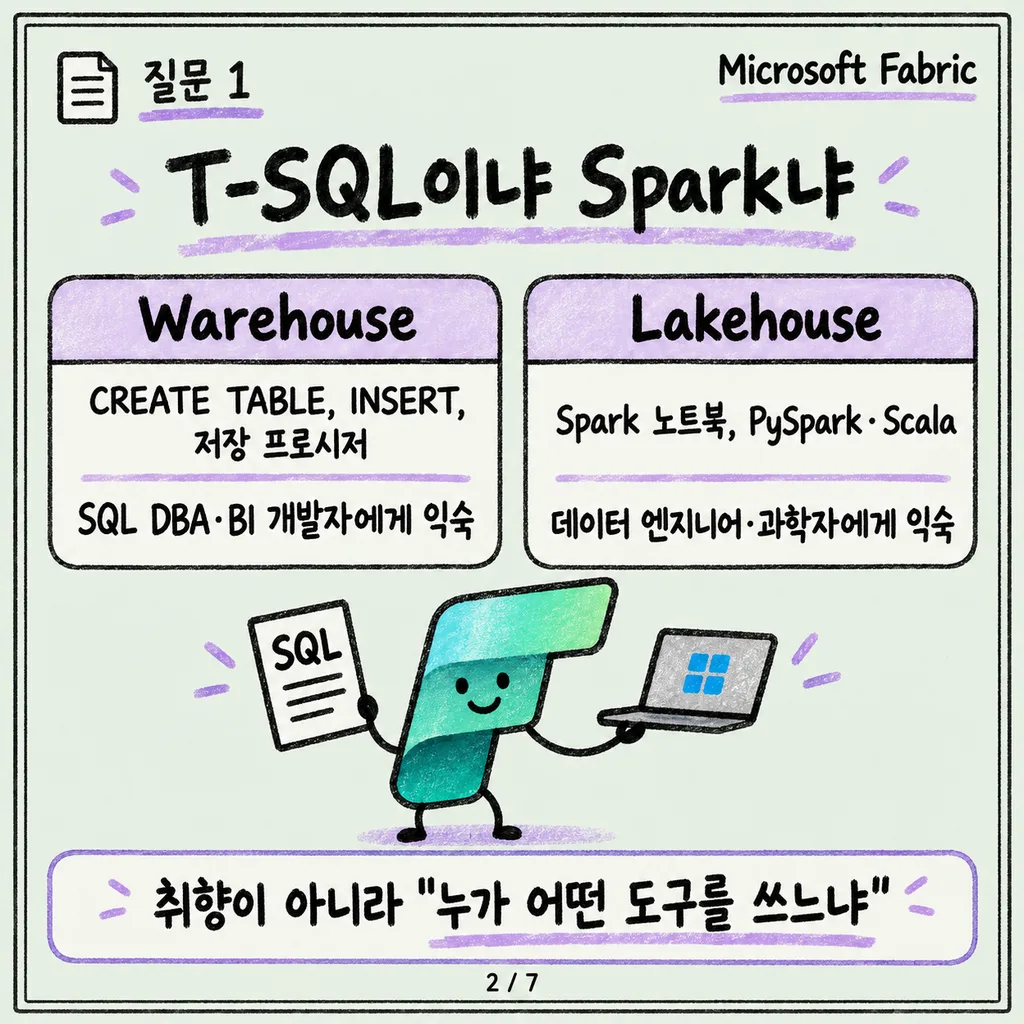
첫 번째 질문: 무엇으로 개발할 건가요 — T-SQL이냐 Spark냐
가이드의 첫 갈림길이 가장 근본적이에요.
- T-SQL로 테이블을 만들고 데이터를 적재하고 변환하고 싶다면 Warehouse예요.
- Spark(노트북, 파이프라인)로 개발하고 싶다면 Lakehouse예요.
이건 단순한 취향 문제가 아니라 실제로 “누가 쓸 수 있는 도구가 무엇인가”의 문제예요. SQL DBA나 BI 개발자 출신이라면 이미 익숙한 CREATE TABLE, INSERT, 저장 프로시저 문법으로 웨어하우스를 그대로 다룰 수 있어요. 반대로 Spark 경험이 있는 데이터 엔지니어·데이터 과학자라면 Lakehouse에서 노트북으로 데이터를 적재·변환하는 흐름이 훨씬 자연스러워요.
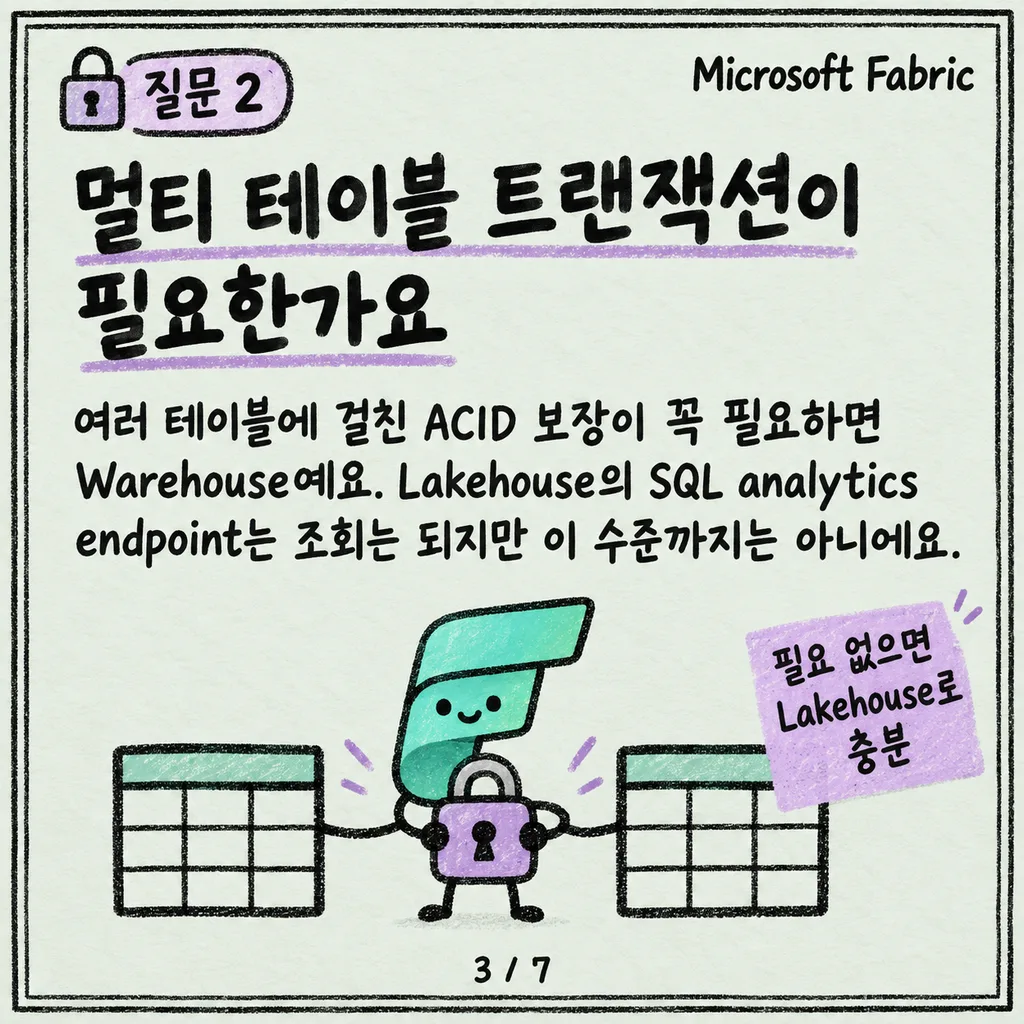
두 번째 질문: 멀티 테이블 트랜잭션이 필요한가요
두 번째 기준은 트랜잭션 보장 수준이에요.
- 여러 테이블에 걸친 트랜잭션(멀티 테이블 트랜잭션)이 필요하면 Warehouse예요.
- 필요 없다면 Lakehouse로도 충분해요.
Warehouse는 SQL 엔진이 제공하는 완전한 멀티 테이블 트랜잭션 보장을 갖고 있어서, ACID를 엄격하게 지켜야 하는 데이터 웨어하우징 워크로드에 맞아요. Lakehouse의 SQL analytics endpoint는 조회는 되지만 이 수준의 트랜잭션 보장까지는 제공하지 않아요.
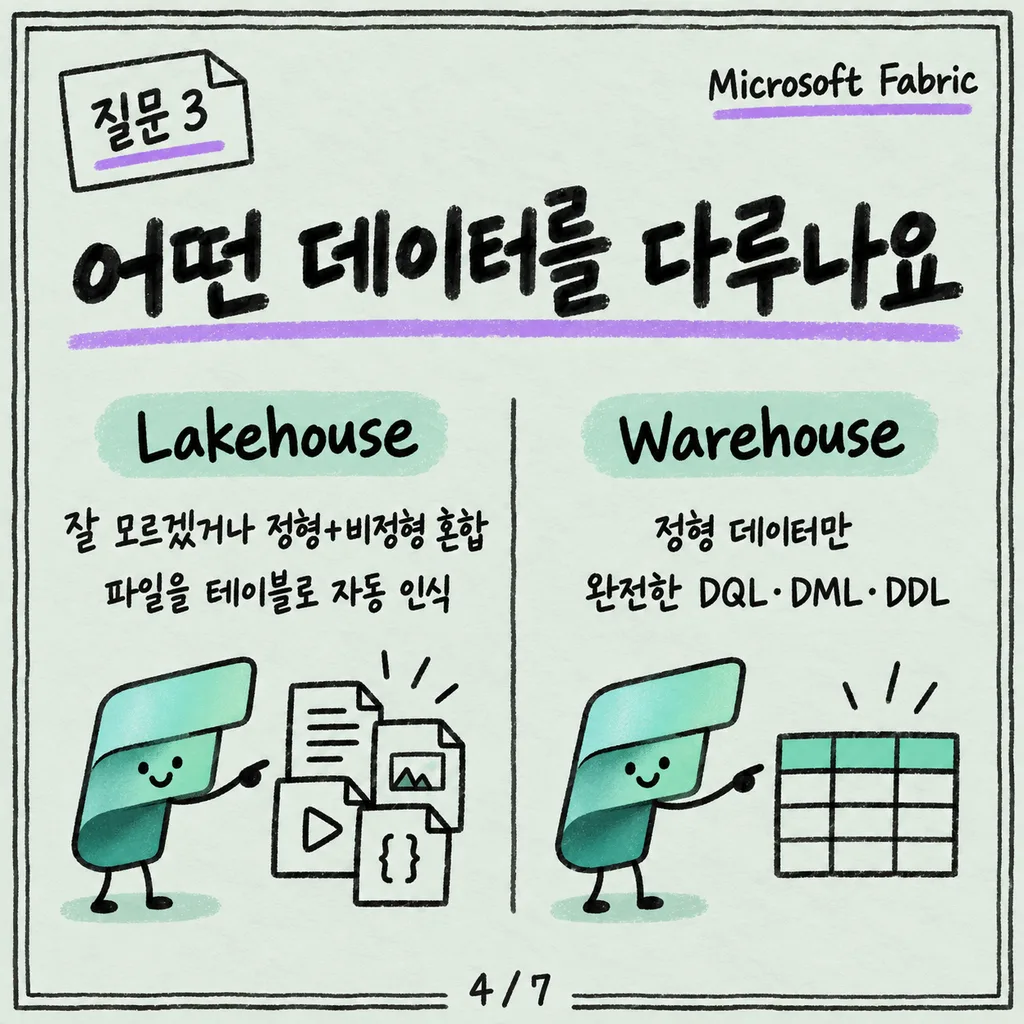
세 번째 질문: 어떤 데이터를 다루나요
- 어떤 데이터인지 잘 모르겠거나, 비정형·정형이 섞여 있다면 Lakehouse예요.
- 정형 데이터만 다룬다면 Warehouse예요.
Lakehouse는 구조화·비구조화 데이터를 한 곳에 저장·관리·분석하도록 설계된 데이터 아키텍처 플랫폼이에요. 다양한 소스에서 들어온 데이터를 손쉽게 수집해 통합 Delta 포맷으로 바꿔주고, 파일을 테이블로 자동 인식·등록해줘요. 반면 Warehouse는 컴퓨트·스토리지 설정 없이 바로 쓸 수 있는 엔터프라이즈급 SQL 웨어하우스로, 정형 데이터 분석과 SQL 기반 BI에 특화돼 있어요.
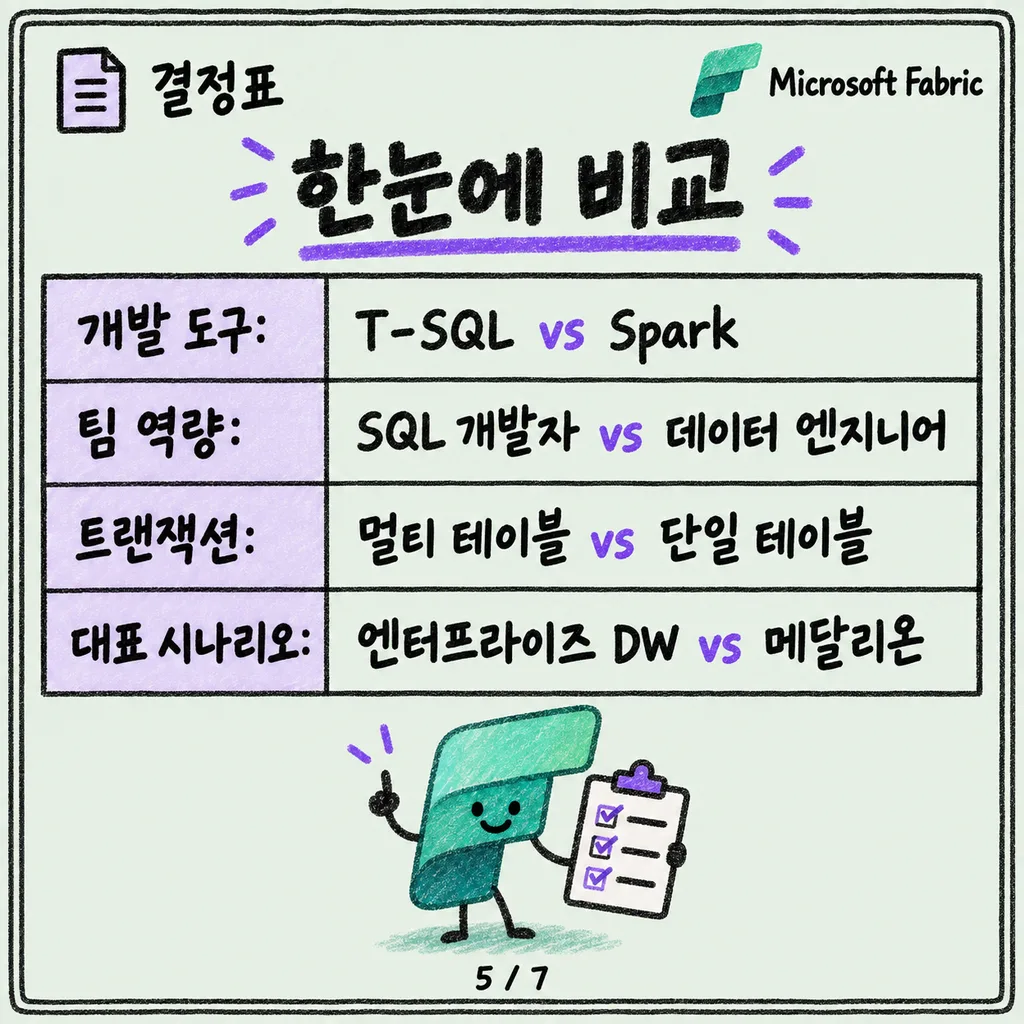
SQL 개발자 출신 vs Spark 경험자, 결정 표로 보면
| 기준 | Warehouse가 자연스러운 경우 | Lakehouse가 자연스러운 경우 |
|---|---|---|
| 개발 도구 | T-SQL, 저장 프로시저, 뷰 | Spark 노트북, PySpark/Scala |
| 팀 역량 | SQL 개발자, 시민 개발자(citizen developer) | 데이터 엔지니어, 데이터 과학자 |
| 트랜잭션 | 멀티 테이블 트랜잭션 필요 | 단일 테이블 단위로 충분 |
| 데이터 형태 | 정형 데이터만 | 정형 + 비정형 |
| 쓰기 지원(SQL analytics endpoint 기준) | Warehouse 자체는 완전한 DQL/DML/DDL 지원 | endpoint는 조회 전용(DML 불가) |
| 대표 시나리오 | 부서·조직 단위 엔터프라이즈 데이터 웨어하우징 | 브론즈·실버·골드 메달리온 아키텍처1, 탐색·스테이징 |
원문에는 Warehouse와 “Lakehouse의 SQL analytics endpoint”를 나란히 비교한 표도 있어요. 몇 가지만 짚으면, Warehouse는 SQL/파이프라인/데이터플로우로 데이터를 적재하고 Delta 테이블을 읽고 쓸 수 있는 반면, Lakehouse의 SQL analytics endpoint는 Spark·파이프라인·데이터플로우·shortcut으로 적재된 데이터를 T-SQL로 “읽기”만 할 수 있어요. T-SQL 기능 지원 범위도 Warehouse는 DQL·DML·DDL을 완전히 지원하지만, endpoint 쪽은 DQL만 완전 지원하고 DML은 지원하지 않고 DDL도 뷰·테이블 반환 함수 정도로 제한돼요.
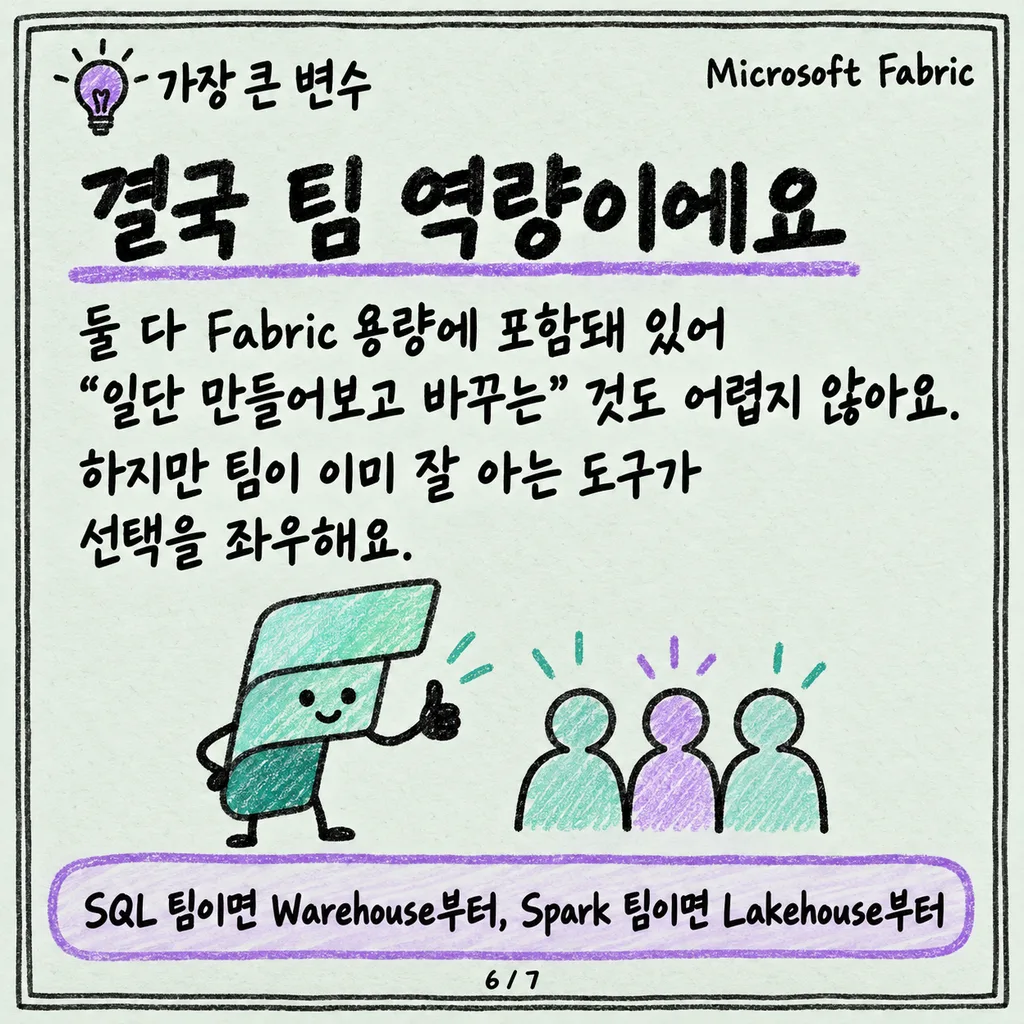
결국 팀 역량이 가장 큰 변수예요
두 아이템 다 Power BI Premium이나 Fabric 용량에 포함돼 있어서, “일단 만들어보고 바꾸는” 것도 어렵지 않아요. 하지만 실무에서는 팀이 이미 잘 아는 도구가 무엇이냐가 선택을 좌우하는 경우가 많아요. SQL 기반 BI 팀이 많다면 Warehouse로 시작해서 T-SQL로 적재·모델링·서빙까지 끝내는 편이 익숙하고, Spark·노트북에 익숙한 데이터 엔지니어링 팀이라면 Lakehouse로 시작해 필요할 때 Warehouse를 골드 레이어로 얹는 조합(가이드에서 말하는 “Warehouse와 짝지어 쓰는” 패턴)도 흔해요.
정리
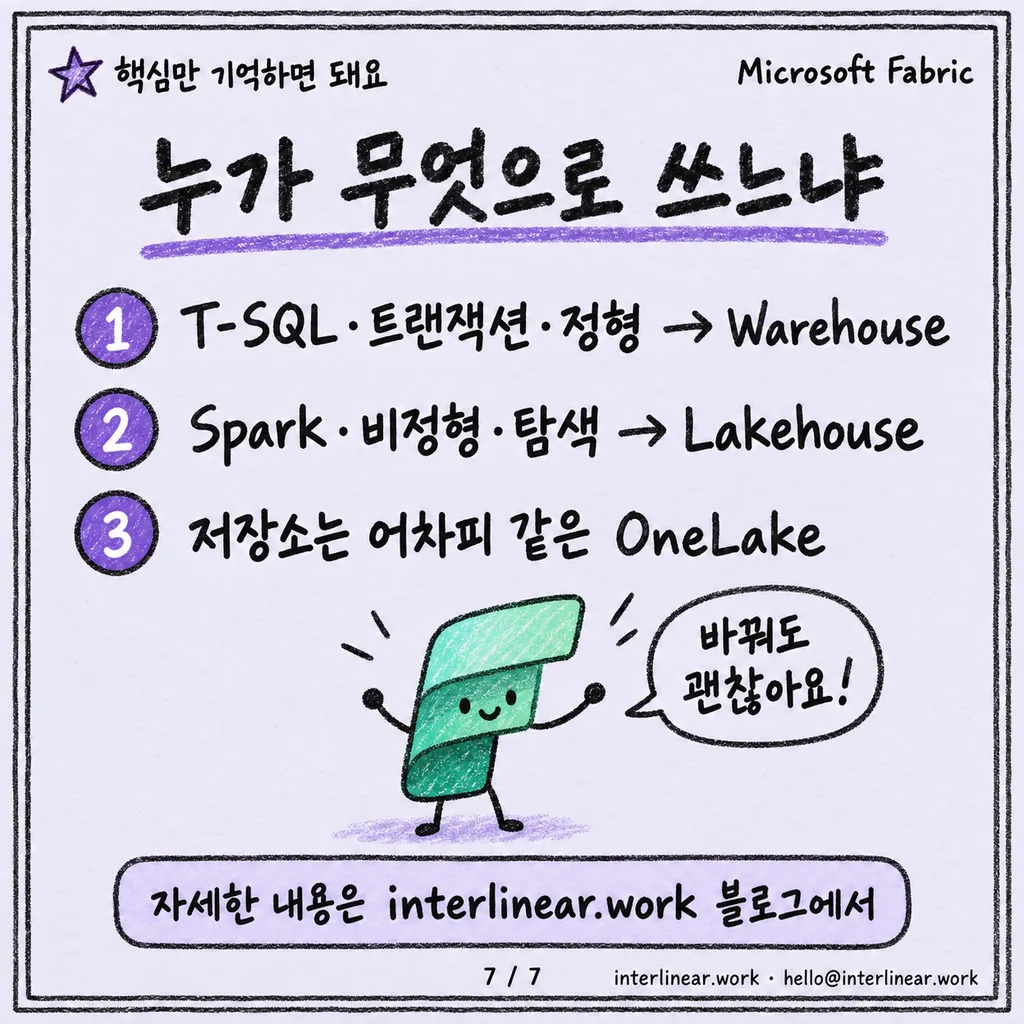
Lakehouse와 Warehouse는 둘 다 OneLake의 Delta 포맷을 저장소로 쓰지만, 결정 기준은 “누가 무엇으로 쓰느냐”예요. T-SQL·멀티 테이블 트랜잭션·정형 데이터 중심이면 Warehouse, Spark·비정형 데이터·탐색 중심이면 Lakehouse가 자연스러워요. 팀의 기존 역량과 워크로드 성격을 먼저 확인하고 고르면, 나중에 방향을 바꾸더라도 같은 OneLake 위에서 큰 재작업 없이 옮겨갈 수 있어요.
어휘 주석
- 메달리온 아키텍처(medallion architecture): 데이터를 브론즈(원본)·실버(정제)·골드(집계·서빙) 세 단계로 나눠 순차적으로 품질을 높여가는 데이터 레이크 설계 패턴이에요.