Bronze·Silver·Gold, 메달리온 구조를 Fabric에서 어떻게 나누나
메달리온 아키텍처를 Fabric에서 구현할 때 Lakehouse를 몇 개로 나눌지, 워크스페이스는 언제 분리할지 실무 권장안을 정리했어요.
카드뉴스
1 / 7
원문: Implement Medallion Lakehouse Architecture in Fabric 게시일: 2026-02-12 · 저자: kgremban (Microsoft)
Lakehouse를 처음 만들 때 자주 부딪히는 질문이 있어요. “폴더 하나로 다 나눌까, 아니면 계층마다 별도 Lakehouse를 만들까?” 메달리온 아키텍처1는 Fabric에서 권장하는 데이터 정리 방식이지만, 원문에도 나오듯 이 패턴을 “어떤 단위로” 나눌지는 팀의 상황에 따라 다른 답이 나와요. Fabric 공식 문서가 제시하는 배치 원칙을 정리해봤어요.
메달리온 아키텍처가 뭔가
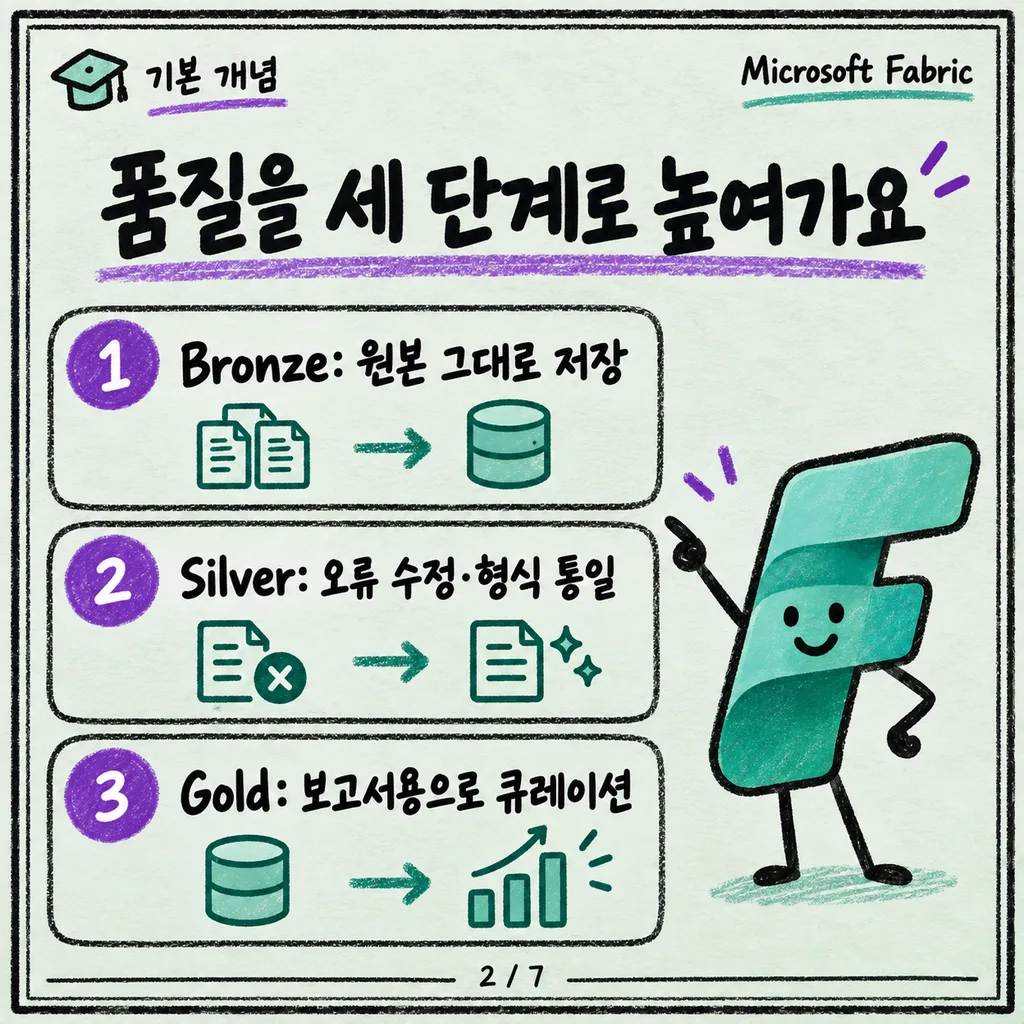
- 데이터 품질을 세 단계로 점진적으로 높여가는 설계 패턴이에요. **Bronze(원본)**는 도착한 그대로 저장하고 변경하지 않아요. **Silver(정제)**는 오류를 고치고 형식을 통일하고 중복을 제거해요. **Gold(큐레이션)**는 보고서·대시보드용으로 정리된 데이터예요.
- OneLake가 Fabric의 데이터 레이크이기 때문에, 메달리온 아키텍처는 OneLake 안에 Lakehouse를 만드는 방식으로 구현돼요.
- 원본 소스가 관계형 데이터베이스라면 Bronze 계층도 보통 Delta 테이블로 저장하는 게 좋고, Silver·Gold 계층은 Delta 테이블을 쓰는 게 기본이에요.
예시로 보면
원문이 드는 이커머스 회사 예시를 보면 각 계층의 역할이 더 분명해져요.
- Bronze: 웹사이트에서 온 원시 판매 데이터(JSON), 창고의 원시 재고 데이터(CSV), CRM에서 내보낸 원시 고객 데이터(SQL export)를 그대로 저장해요.
- Silver: 모든 소스의 날짜 형식을 통일하고, 통화를 전부 USD로 환산하고, 테스트성 거래를 제거하고, 시스템마다 흩어진 고객 레코드를 매칭해요.
- Gold: 일별 매출 대시보드용 테이블, 고객 생애가치(LTV) 테이블, 재고 예측용 테이블처럼 곧바로 소비할 수 있는 형태로 만들어요.
Lakehouse 하나 vs 계층별 분리 — 두 가지 패턴
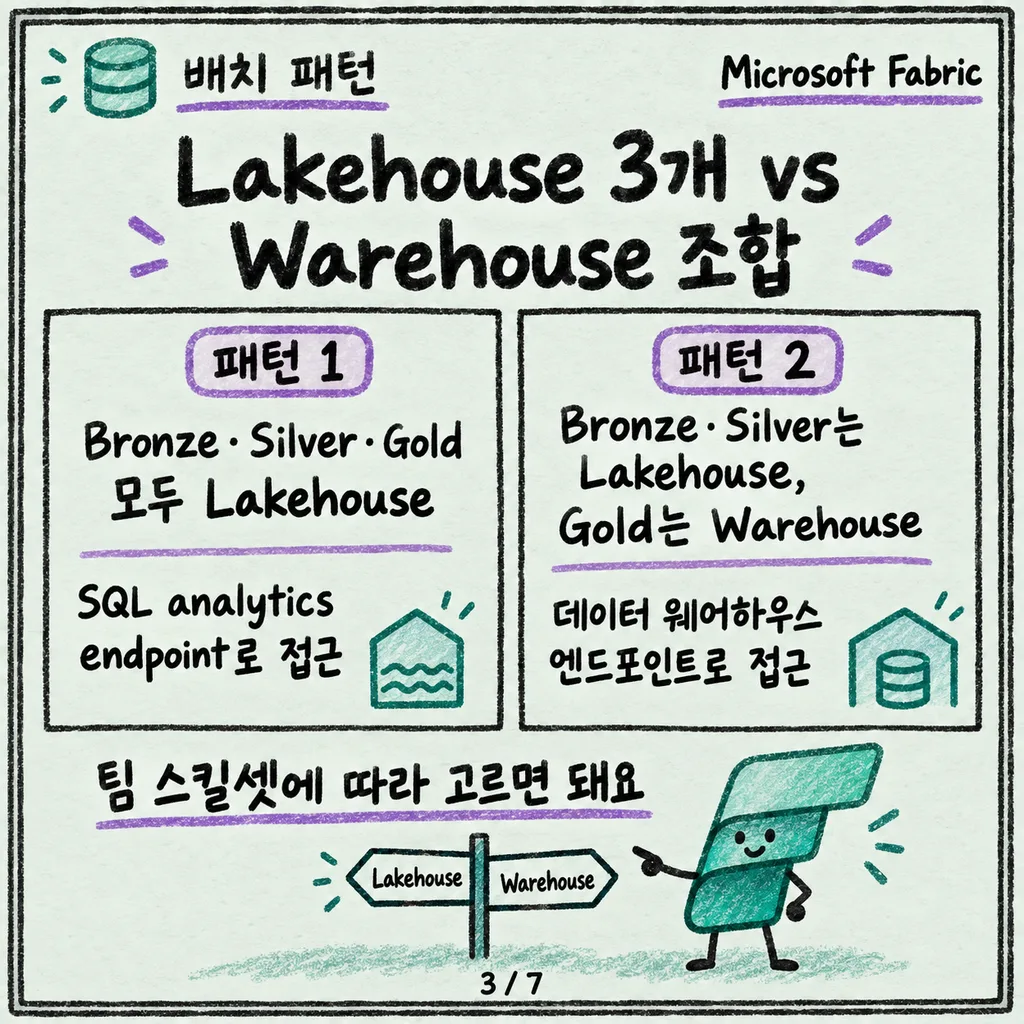
원문은 계층마다 별도의 Lakehouse 또는 Warehouse에 담을 것을 권장하면서, 구체적으로 두 가지 배치 패턴을 제시해요.
- 패턴 1: Bronze·Silver·Gold를 각각 별도 Lakehouse로 만들어요. 이 경우 비즈니스 사용자는 SQL analytics endpoint를 통해 데이터에 접근해요.
- 패턴 2: Bronze와 Silver는 Lakehouse로, Gold는 Warehouse로 만들어요. 이 경우 비즈니스 사용자는 데이터 웨어하우스 엔드포인트를 통해 접근해요.
어느 패턴을 고를지는 팀의 취향과 보유한 기술 스택(SQL 중심 팀인지, Spark 중심 팀인지)에 따라 결정하면 돼요. Fabric은 같은 OneLake 데이터 위에서 여러 분석 엔진을 붙여 쓸 수 있게 설계돼 있어서, 어느 쪽을 골라도 같은 사본의 데이터를 쓰게 돼요.
워크스페이스는 언제 나누나
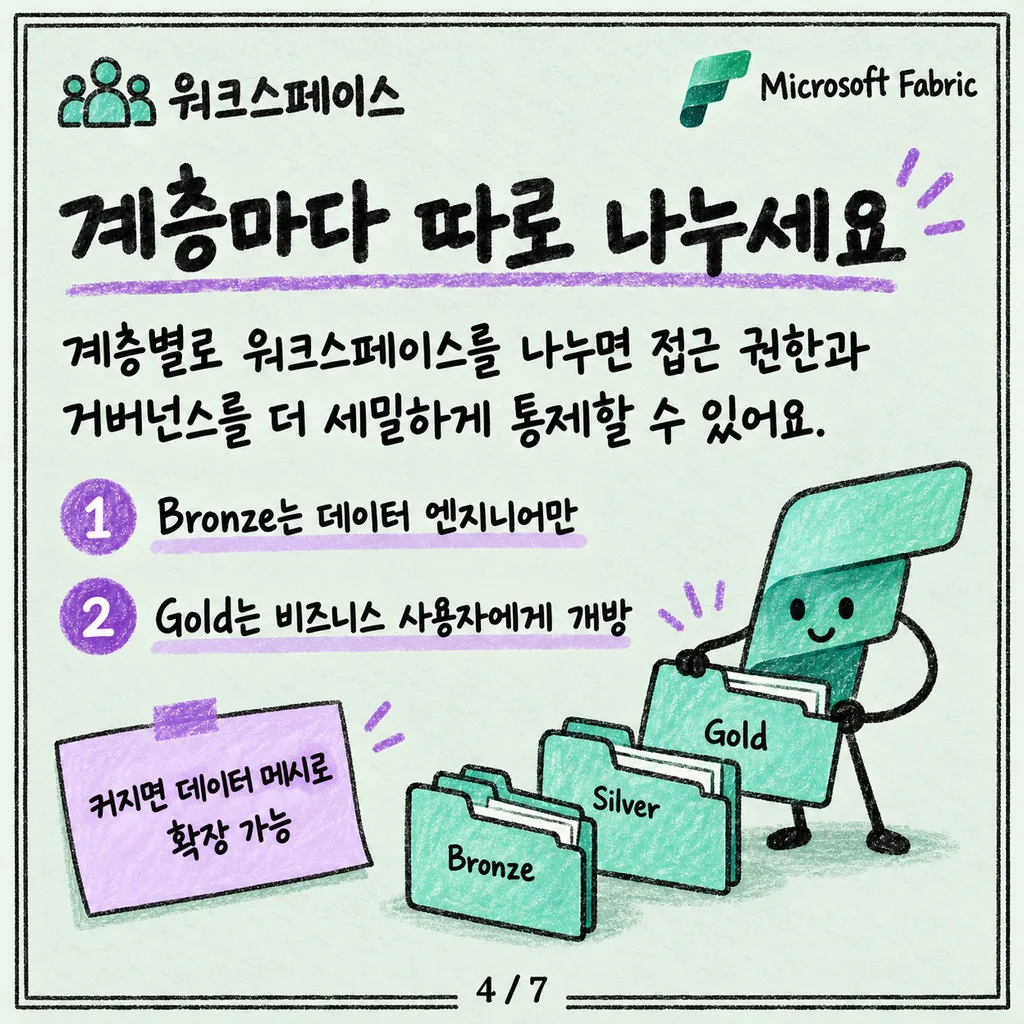
- 모든 계층의 Lakehouse를 워크스페이스 하나에 만들 수도 있지만, 원문은 계층마다 별도의 워크스페이스를 만들 것을 권장해요.
- 이렇게 나누면 계층 단위로 접근 권한과 거버넌스를 더 세밀하게 통제할 수 있어요. 예를 들어 Bronze 워크스페이스는 데이터 엔지니어만 쓰고, Gold 워크스페이스는 비즈니스 사용자에게 더 넓게 열어주는 식이에요.
- 조직 규모가 커지면 이 구조를 더 확장해서, 마케팅·영업·인사처럼 비즈니스 도메인별로 데이터 도메인을 나누고 각 도메인 안에 메달리온 계층을 두는 데이터 메시2 구조로 갈 수도 있어요.
Bronze 계층 — 원본 형식 유지, 가능하면 Shortcut
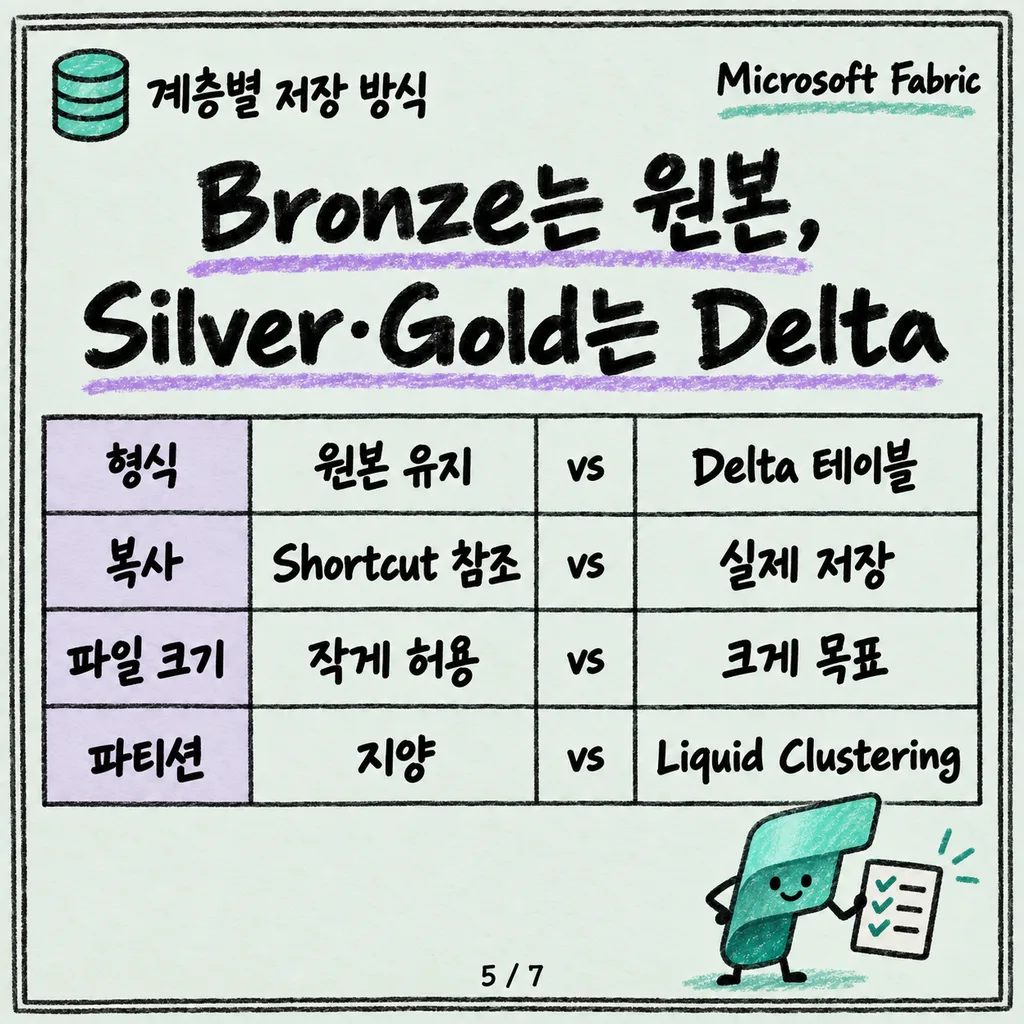
- Bronze는 되도록 원본 형식 그대로 저장하는 게 원칙이에요. Parquet나 Delta Lake로 바꿔도 되지만, 가능하면 원본 형식을 유지해요.
- 원본이 OneLake, ADLS Gen2, Amazon S3, Google 스토리지에 이미 있다면 데이터를 복사하지 말고 Shortcut3을 만들어서 참조만 하는 걸 권장해요.
- 저장 위치 관점에서 Lakehouse는 두 물리 영역으로 나뉘어요. Tables는 Spark가 다루는 표 형식 데이터(CSV, Parquet, Delta), Files는 형식에 상관없는 파일이에요. Files 영역의 데이터를 테이블처럼 쓰고 싶으면 해당 폴더를 가리키는 Shortcut을 만들면 돼요.
Silver·Gold 계층 — Delta 테이블과 V-Order
- Silver·Gold 계층은 Delta 테이블을 쓰는 걸 권장해요. Fabric의 모든 엔진이 기본적으로 Delta 형식으로 쓰기 때문에 별다른 설정 없이도 통일이 돼요.
- Fabric 엔진들은 쓰기 시점에 V-Order라는 Parquet 최적화를 적용해서, Power BI·SQL·Spark 등 여러 컴퓨팅 엔진에서 더 빠르게 읽을 수 있게 해줘요.
- 계층마다 권장하는 파일 크기도 달라요. 일반적으로 128MB~1GB 크기를 목표로 하되, Bronze는 원본 데이터의 특성상 작은 파일이 허용되고, Silver는 읽기·쓰기 성능의 균형을, Gold는 조회 성능을 위해 더 큰 파일 크기를 지향해요.
- 파티션 구조도 계층별로 달라요. Bronze에서는 파티셔닝이 허용되지만 새 구현에서는 권장하지 않고, Silver·Gold는 파티셔닝 대신 Liquid Clustering을 쓰는 게 조회 성능에 유리해요.
계층 간 이동은 수동 파이프라인이 아니어도 된다
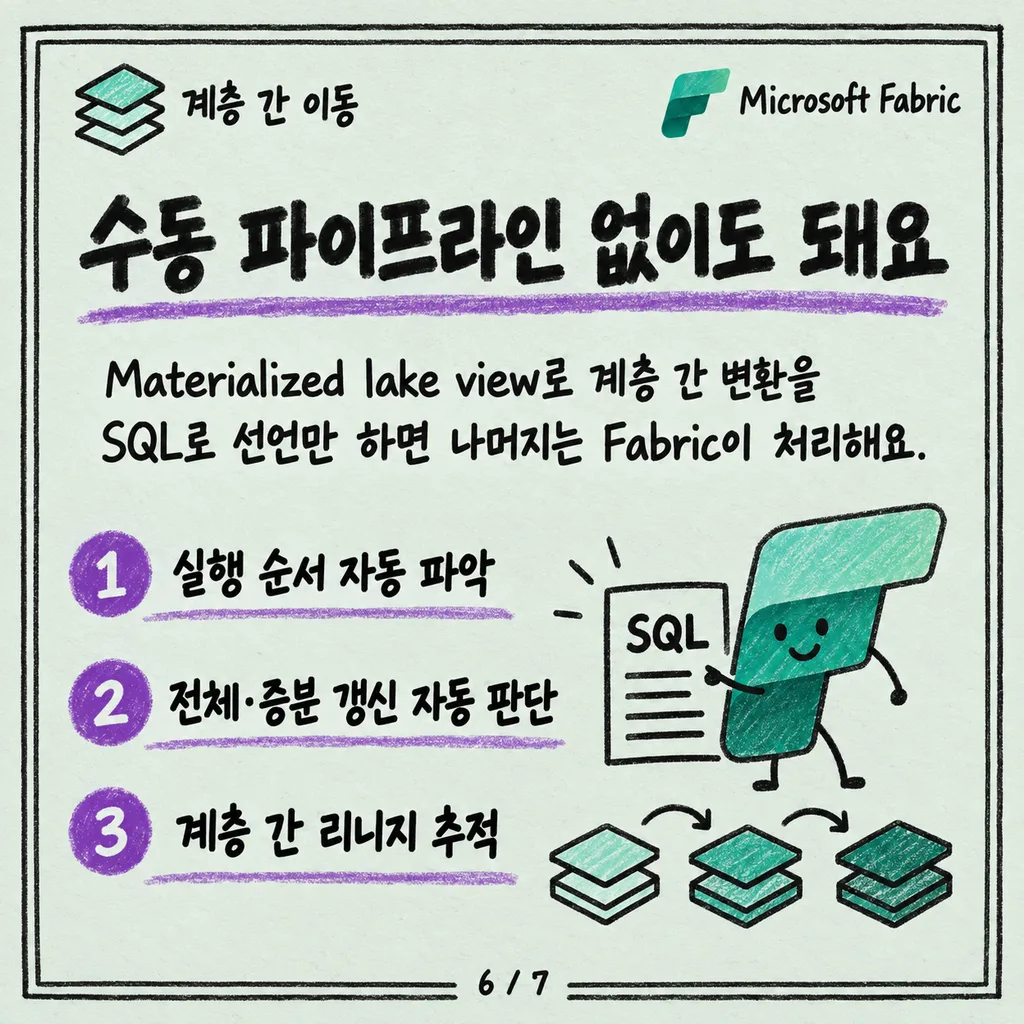
Bronze에서 Silver, Silver에서 Gold로 데이터를 옮기는 로직을 매번 직접 파이프라인으로 짤 필요는 없어요. Fabric의 materialized lake view4를 쓰면 계층 간 변환을 SQL 문으로 선언만 해두고, 나머지는 Fabric이 처리하게 할 수 있어요.
- 뷰 사이의 의존 관계를 Fabric이 자동으로 파악해서 실행 순서를 정해줘요.
- 데이터 품질 규칙을 뷰 정의에 내장해서, 계층을 넘어갈 때마다 강제할 수 있어요.
- 매번 전체를 다시 계산할지, 증분만 갱신할지, 아니면 갱신이 필요 없는지를 시스템이 자동으로 판단해요.
- 계층을 가로지르는 데이터 리니지5를 한눈에 보고 실행 상태를 추적할 수 있어요.
예를 들어 Bronze 테이블을 정제·조인하는 Silver 뷰를 만들고, 그 Silver 데이터를 집계하는 Gold 뷰를 이어 만들면, 갱신 오케스트레이션은 시스템이 알아서 처리해요.
정리
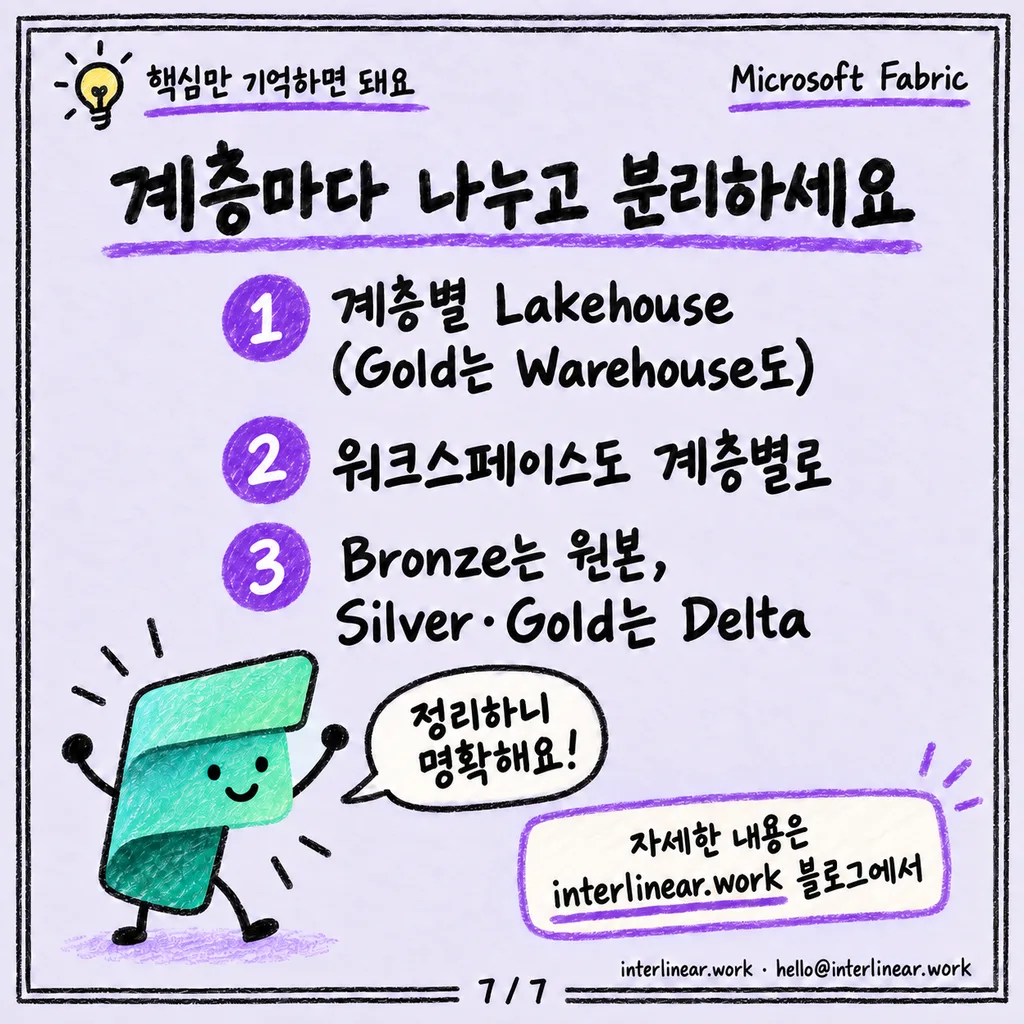
메달리온 아키텍처를 Fabric에 구현할 때는 “계층마다 별도 Lakehouse(또는 Gold만 Warehouse)“가 기본 권장안이고, 여기에 더해 계층마다 워크스페이스까지 분리하면 접근 통제와 거버넌스가 쉬워져요. Bronze는 원본 형식을 유지하며 가능하면 Shortcut으로 참조하고, Silver·Gold는 Delta 테이블로 통일하되 계층별로 파일 크기·파티션 전략을 다르게 가져가는 것이 핵심이에요.
어휘 주석
- 메달리온 아키텍처(medallion architecture): 데이터를 Bronze(원본)-Silver(정제)-Gold(큐레이션) 세 단계로 나눠 품질을 점진적으로 높여가는 데이터 레이크 설계 패턴이에요.
- 데이터 메시(data mesh): 데이터를 중앙 팀 하나가 관리하지 않고, 비즈니스 도메인별로 나눠 각 도메인이 자기 데이터를 상품처럼 책임지고 제공하는 분산 거버넌스 구조예요.
- Shortcut: 데이터를 복사하지 않고 다른 위치(다른 Lakehouse, ADLS Gen2, S3 등)에 있는 파일을 OneLake 안에서 바로 참조할 수 있게 해주는 가상 연결 기능이에요.
- Materialized lake view: 계층 간 데이터 변환을 파이프라인 코드 대신 SQL 뷰 정의로 선언하면, 실행 순서·갱신 방식을 Fabric이 자동으로 관리해주는 기능이에요.
- 데이터 리니지(data lineage): 데이터가 어느 원본에서 시작해 어떤 변환을 거쳐 지금 형태에 이르렀는지 추적한 흐름 정보예요.