Mirroring: 운영 DB를 파이프라인 없이 OneLake에 복제하기
Azure SQL·Snowflake·Cosmos DB 같은 운영 데이터베이스를 ETL 없이 OneLake에 근실시간 복제하는 Mirroring의 구조와 비용, 제약을 정리했어요.
카드뉴스
1 / 7
← → 한 장씩 이동 · 아래에서 본문이 이어집니다
원문: Mirroring - Microsoft Fabric 게시일: 2026-08-28 · 저자: whhender (Microsoft)
운영 데이터베이스에 있는 데이터를 분석용으로 쓰려면 보통 파이프라인을 짜서 주기적으로 복사해야 해요. 이 파이프라인을 만들고, 스케줄을 관리하고, 실패하면 다시 돌리고 — 이 과정 자체가 만만치 않은 작업이에요. Mirroring은 이 ETL 과정 없이 운영 DB를 OneLake에 근실시간으로 복제해 주는 기능이에요.
Mirroring이 해결하는 문제
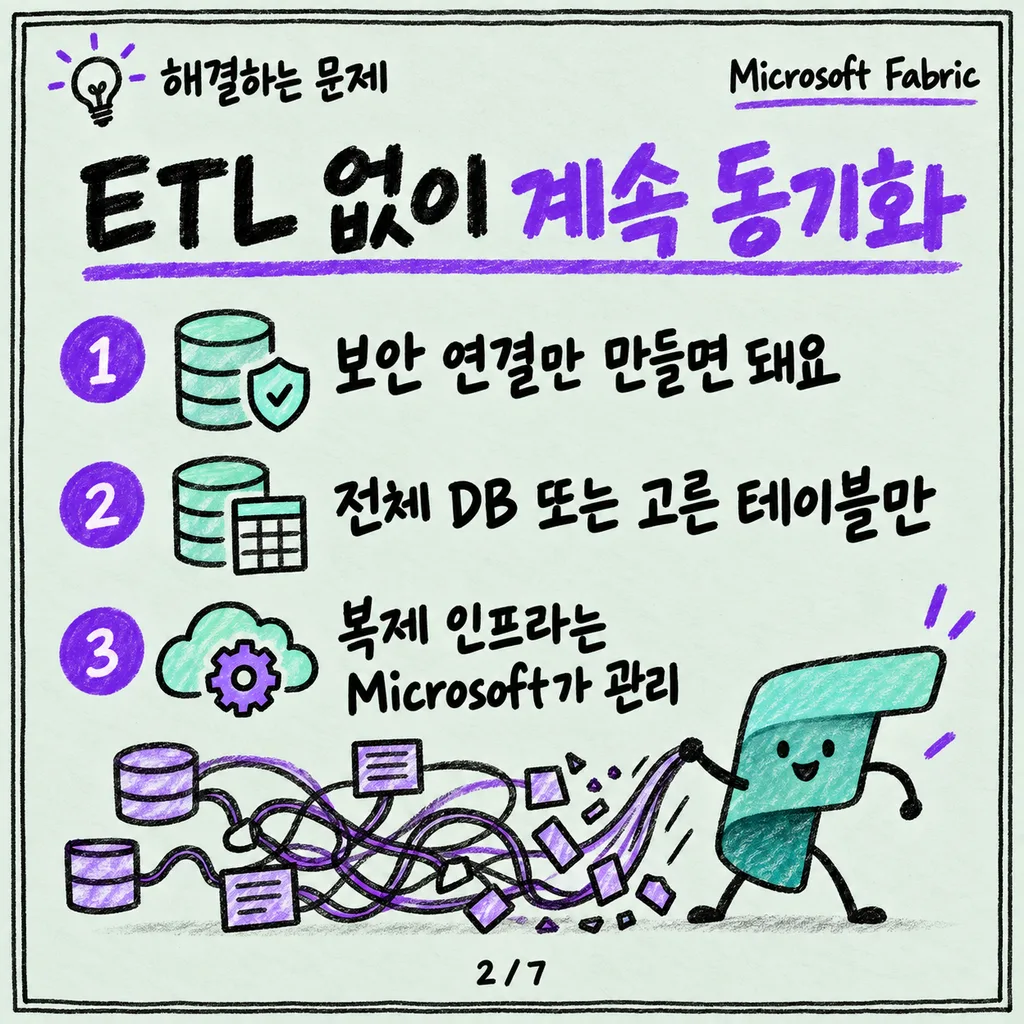
- 조직마다 중요한 운영·분석 데이터가 여러 시스템에 흩어져 있어요. 이 데이터를 쓰려면 복잡한 ETL 파이프라인이 필요하고, 그 과정에서 접근 제한, 긴 대기 시간, 부서 간 마찰 같은 문제가 생겨요.
- Mirroring은 원본 데이터 소스에 보안 연결을 만들기만 하면, 전체 데이터베이스 또는 선택한 테이블을 OneLake에 지속적으로 동기화해 줘요. ETL 파이프라인을 직접 짜거나 별도 컴퓨팅 자원을 할당할 필요가 없어요.
- 완전 관리형 서비스라서, 복제 인프라의 호스팅·유지보수를 Microsoft가 대신해요.
세 가지 방식
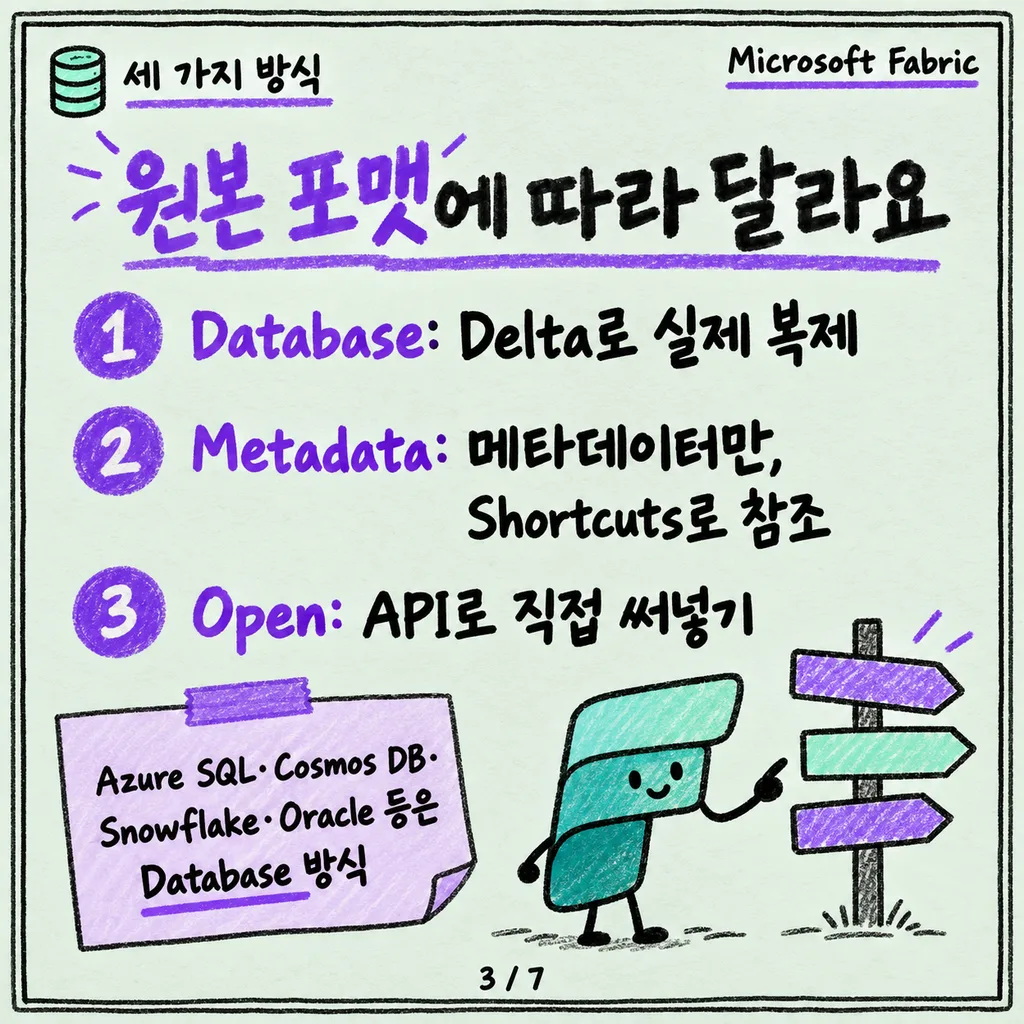
Mirroring은 원본의 저장 방식에 따라 서로 다른 메커니즘을 써요.
- Database mirroring(데이터베이스 미러링): 전체 데이터베이스와 테이블을 OneLake에 Delta 형식으로 실제로 복제해요. 원본이 독자적인 포맷을 쓸 때 이 방식을 써요. Azure SQL Database, Azure SQL Managed Instance, Azure Database for PostgreSQL, Azure Cosmos DB, SQL Server, Snowflake, Oracle, SAP, Google BigQuery, SharePoint 목록 등이 여기 해당해요.
- Metadata mirroring(메타데이터 미러링): 데이터 자체를 옮기지 않고 카탈로그 이름·스키마·테이블 같은 메타데이터만 동기화해요. 원본이 OneLake가 직접 읽을 수 있는 개방형 포맷을 쓸 때(Azure Databricks Unity Catalog, Snowflake 카탈로그, Dremio 등) Shortcuts1를 통해 원본 위치의 데이터를 그대로 참조해요. 데이터 복사가 없어서 테넌트 경계를 넘는 크로스 테넌트 공유도 지원해요.
- Open mirroring(오픈 미러링): 공개 API와 오픈 Delta Lake 포맷을 기반으로, 개발자가 직접 자신의 애플리케이션 변경 데이터를 미러링된 데이터베이스 항목에 써넣을 수 있게 해줘요. 랜딩존 URL에 규격에 맞는 데이터를 놓으면 복제가 자동으로 병합해서 반영해요.
얼마나 빠르게 반영되나
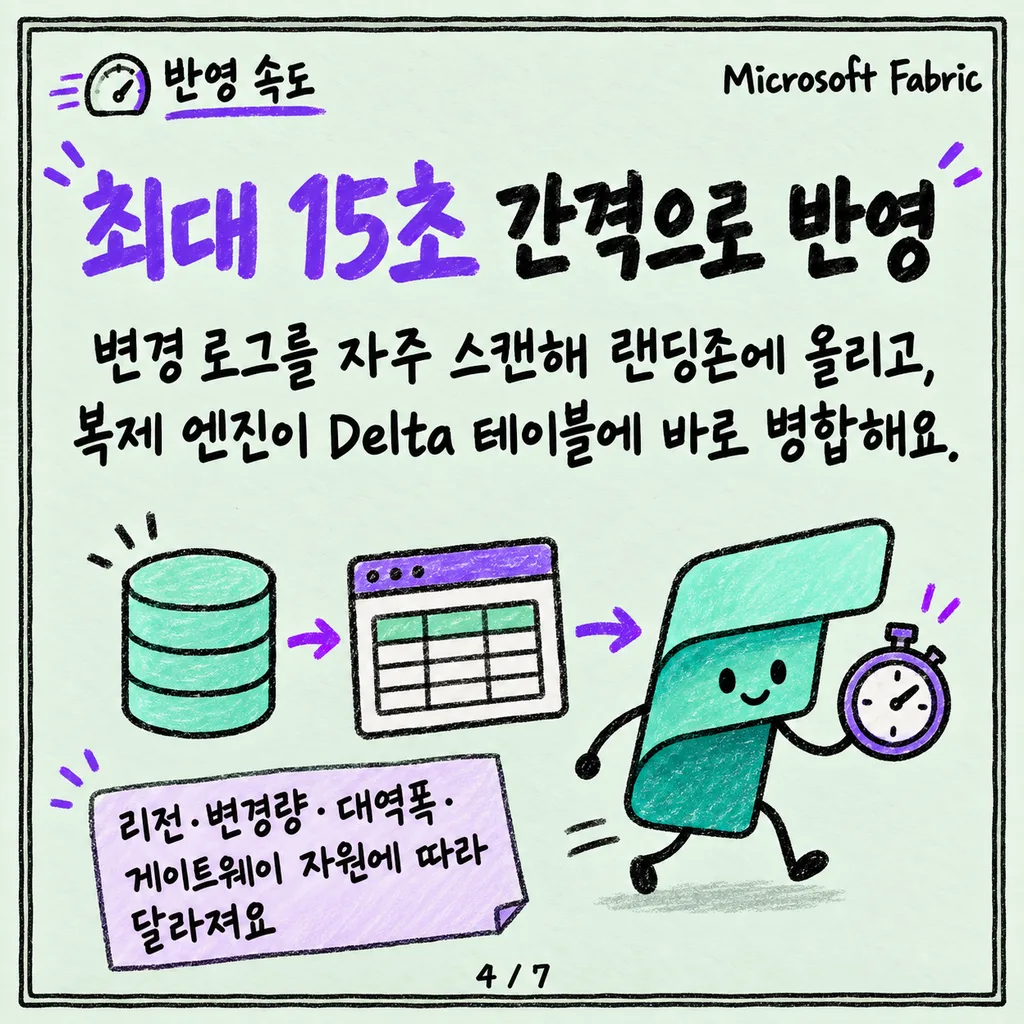
- 데이터베이스 미러링은 원본의 변경 로그를 높은 빈도로 스캔해서 변경분을 Fabric 랜딩존에 파일로 퍼블리시하고, Fabric 안의 복제 엔진이 이를 즉시 대상 Delta 테이블에 병합해요. 변경 사항은 최대 15초 간격으로 반영될 수 있어요.
- 실제 반영 속도는 원본·대상의 리전, 변경량과 변경 빈도, 네트워크 대역폭, 온프레미스 데이터 게이트웨이의 컴퓨팅 자원 같은 여러 요인에 따라 달라져요.
- 메타데이터 미러링은 데이터를 복제하지 않고 Shortcuts로 원본을 그대로 참조하기 때문에, 지연 시간은 복제 속도가 아니라 원본 시스템 접근 속도와 Shortcut 성능에 좌우돼요.
비용 — 무료 미러링 저장소
- 데이터베이스 미러링과 오픈 미러링은 Fabric 컴퓨팅과 OneLake 저장소를 일정 한도까지 무료로 제공해요.
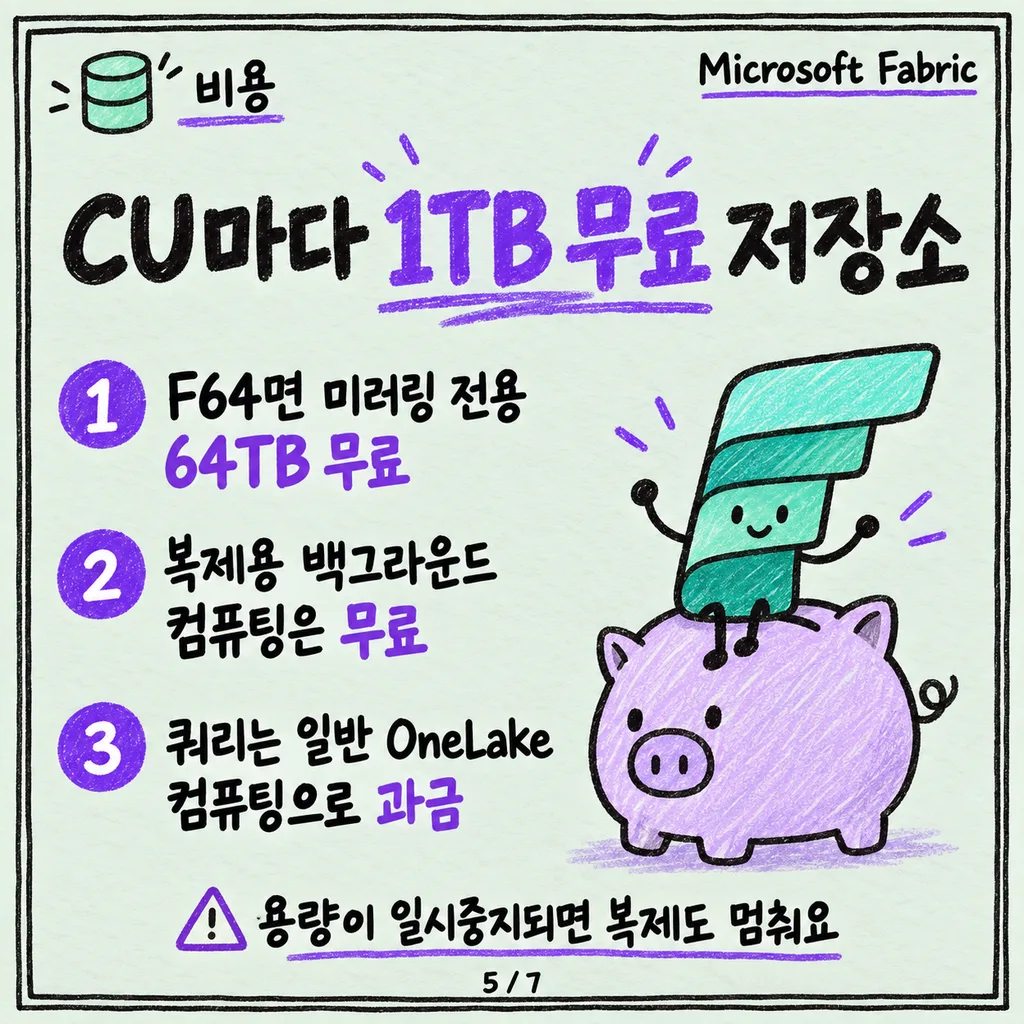
- 구매한 용량 단위(CU)마다 1테라바이트의 무료 미러링 전용 저장소가 주어져요. 예를 들어 F64 용량을 구매했다면 미러링 전용으로 64테라바이트를 무료로 쓸 수 있어요. 이 한도를 넘거나, 용량이 일시중지된 상태라면 초과분에 대해 일반 OneLake 저장소 요금이 부과돼요.
- 데이터를 OneLake로 복제하는 데 쓰이는 백그라운드 컴퓨팅 자체는 무료이고 용량을 소비하지 않아요. 다만 미러링된 데이터에 직접 요청을 보내는 것(SQL·Power BI·Spark로 쿼리하는 것)은 일반 OneLake 컴퓨팅 소비와 똑같이 과금돼요.
- Mirroring이 동작하려면 실행 중인 Fabric 용량이 필요해요. 용량이 일시중지되거나 삭제되면 복제가 멈춰요.
실무에서 알아둘 점
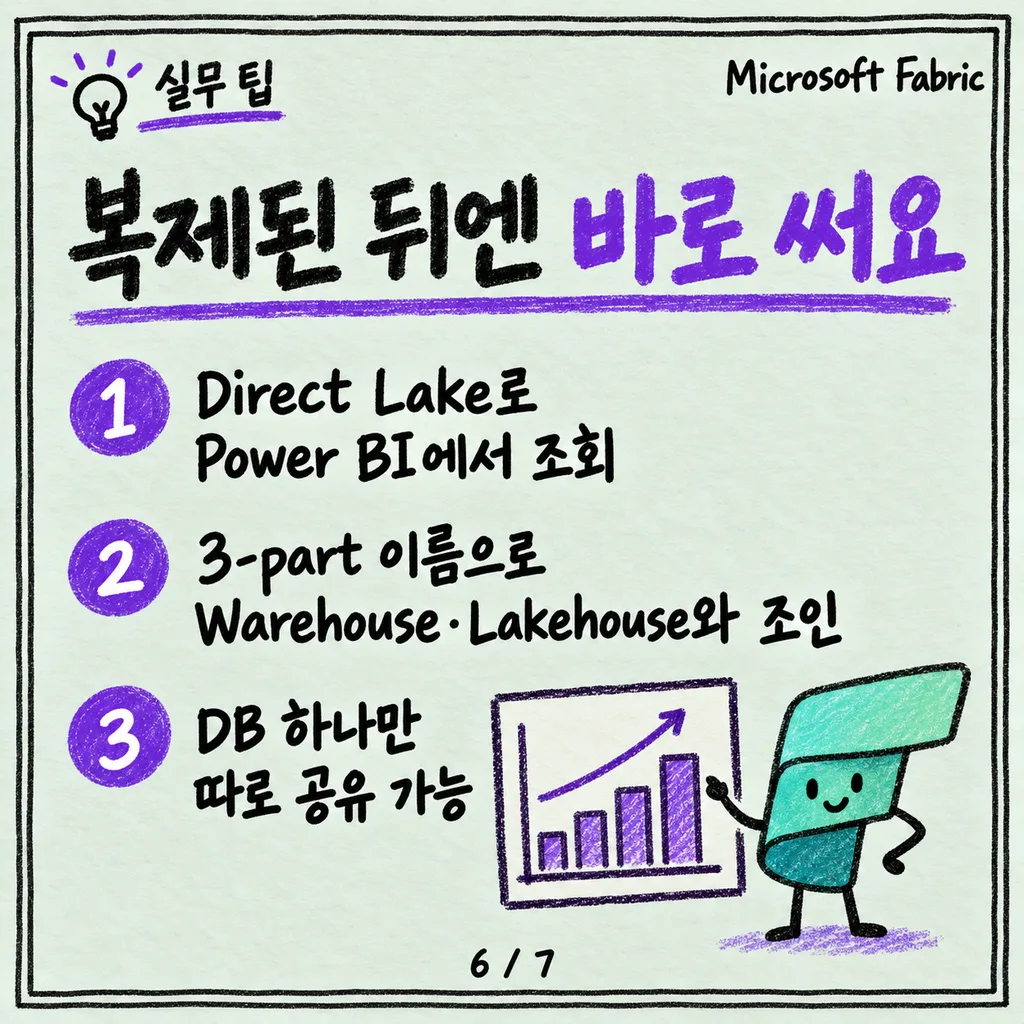
- 미러링된 데이터는 OneLake에 Delta 형식으로 저장되기 때문에, 별도 데이터 이동 없이 Direct Lake2 모드로 Power BI에서 바로 조회할 수 있어요.
- 크로스 데이터베이스 쿼리로 미러링된 데이터베이스, Warehouse, Lakehouse의 SQL analytics endpoint를 3-part 이름으로 한 번에 조인할 수 있어요.
- Delta 로그에서 더 이상 참조되지 않는 오래된 파일은 자동으로 vacuum3 처리돼요. 보존 기간은 설정에서 조정할 수 있고, 2025년 중반 이후 새로 만든 미러링된 데이터베이스는 기본 보존 기간이 하루, 그 이전에 만든 것은 7일이에요.
- 공유(sharing) 기능으로 워크스페이스 전체가 아니라 미러링된 데이터베이스 하나만 다른 사용자에게 공유할 수 있고, 이때 SQL analytics endpoint 접근 권한도 함께 부여돼요.
정리
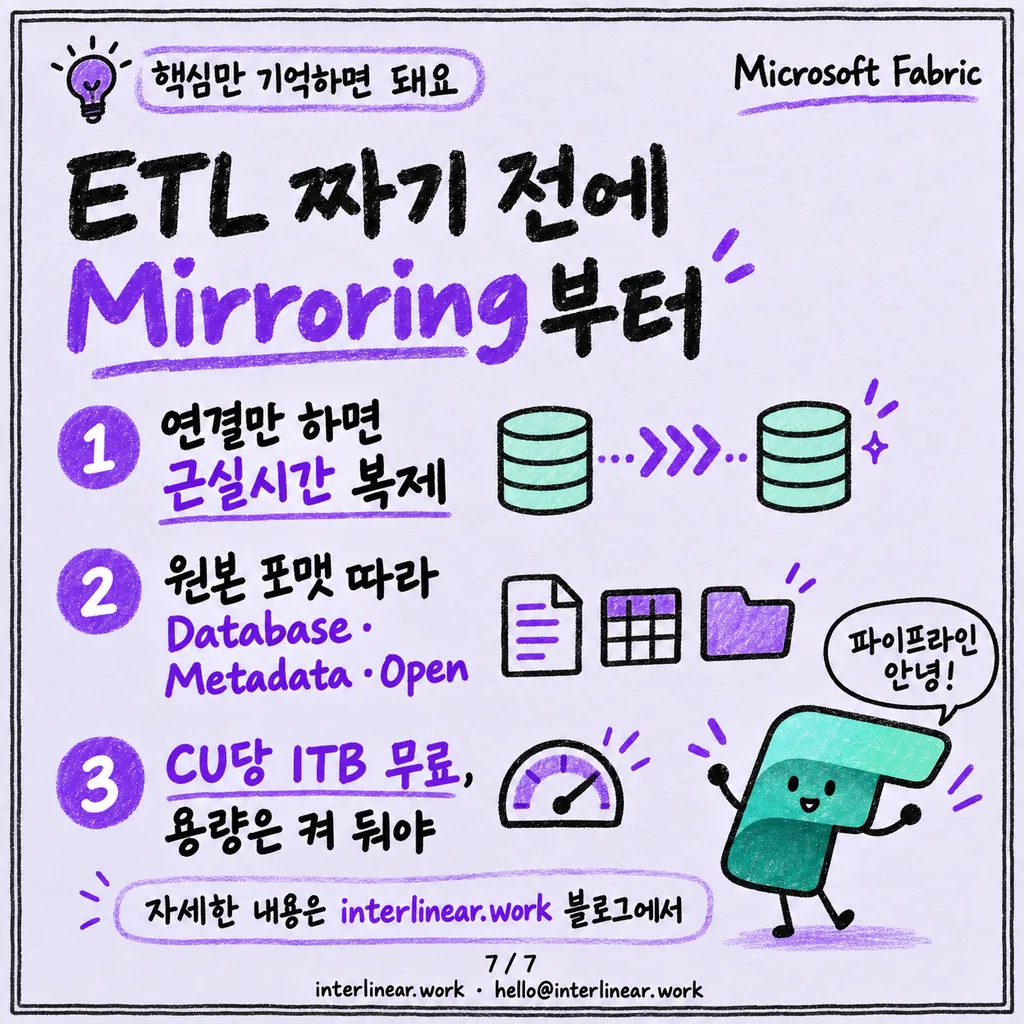
Mirroring은 Azure SQL, Snowflake, Cosmos DB 같은 운영 데이터베이스를 파이프라인 코드 없이 OneLake에 근실시간으로 복제해 주는 완전 관리형 기능이에요. 원본 포맷에 따라 실제로 복제하는 데이터베이스 미러링과, 데이터는 그대로 두고 메타데이터만 동기화하는 메타데이터 미러링으로 나뉘고, 저장소는 구매한 용량만큼 무료 한도가 주어져요. ETL을 새로 짜기 전에 원본이 지원 목록에 있는지부터 확인해 보면 좋아요.
어휘 주석
- Shortcuts: 데이터를 복사하지 않고 다른 위치에 있는 파일이나 테이블을 OneLake 안에서 바로 참조하는 가상 연결 기능이에요.
- Direct Lake: Power BI가 데이터를 별도로 가져오거나 복사하지 않고, OneLake의 Delta 파일을 직접 읽어 빠르게 시각화하는 조회 모드예요.
- vacuum: Delta 테이블에서 더 이상 필요 없는 오래된 데이터 파일을 정리해 저장 공간을 회수하는 작업이에요.