OneLake는 왜 "데이터 하나만 두자"고 말할까
테넌트당 하나뿐인 OneLake와 모든 엔진이 공유하는 Delta Parquet 한 벌. SQL·Power BI에서 늘 겪던 복사본 난립 문제가 Fabric에서 어떻게 달라지는지 정리했어요.
카드뉴스
1 / 7
원문: OneLake, the unified data lake 게시일: 2026-03-09 · 저자: Microsoft Fabric 문서 팀
SQL DBA나 Power BI 개발자로 일해봤다면 이 패턴이 낯설지 않을 거예요. 재무팀 데이터마트가 하나, 마케팅팀 데이터마트가 하나, 거기에 Power BI용으로 다시 뽑아낸 익스트랙트가 하나. 원본은 같은 매출 테이블인데, 조직 안에 사본이 서너 벌씩 떠다니고 있죠. 어느 게 최신인지, 어느 게 “진짜”인지는 항상 헷갈리는 문제였어요.
Microsoft Fabric의 OneLake는 이 문제를 저장소 구조 자체로 없애겠다고 나선 서비스예요. 핵심 문장은 하나예요. “한 벌의 데이터를 여러 분석 엔진이 복제 없이 함께 쓴다(one copy of data to use with multiple analytical engines without duplication).”
테넌트에 OneLake는 딱 하나예요
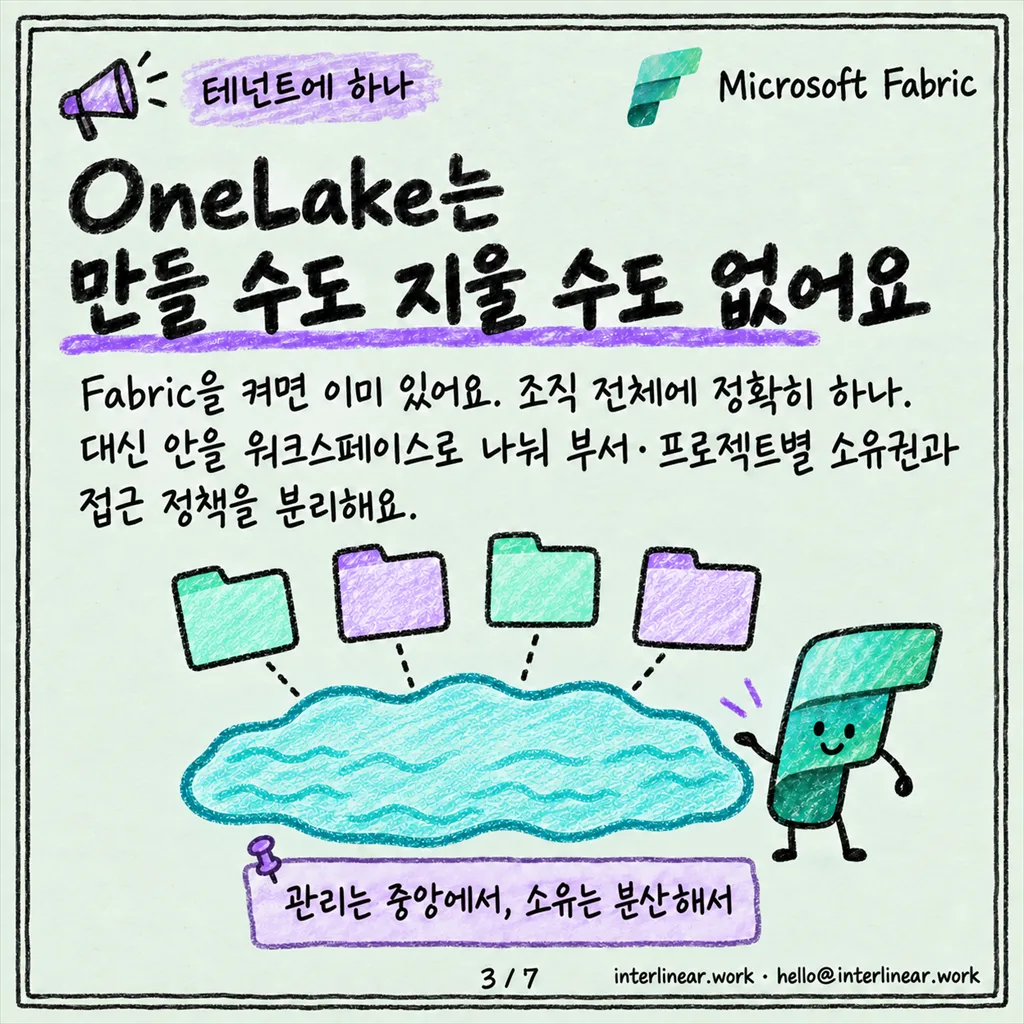
Fabric을 처음 켜면 별도로 프로비저닝할 필요 없이 OneLake가 이미 있어요. 조직 전체에 걸쳐 정확히 하나만 존재하고, 삭제하거나 두 번째 OneLake를 만들 수도 없어요. 대신 그 안을 워크스페이스1로 나눠서 부서·프로젝트별로 소유권과 접근 정책을 분리해요.
이전 방식과 비교하면 차이가 뚜렷해요. OneLake 이전에는 조직마다 팀별로 별도 데이터 레이크를 여러 개 만드는 게 흔했는데, 그러면 리소스 관리 부담이 늘고 팀 간 협업이 어려워지고 데이터가 중복될 위험도 커졌어요. OneLake는 이런 사일로 대신 조직 전체가 접근하는 중앙 지점 하나를 두고, 그 안에서 도메인·서브도메인·워크스페이스로 소유권을 나누는 방식을 택했어요. 관리는 중앙에서, 소유는 분산해서 하는 구조예요.
’한 벌 복사(one copy)’가 실제로 뜻하는 것
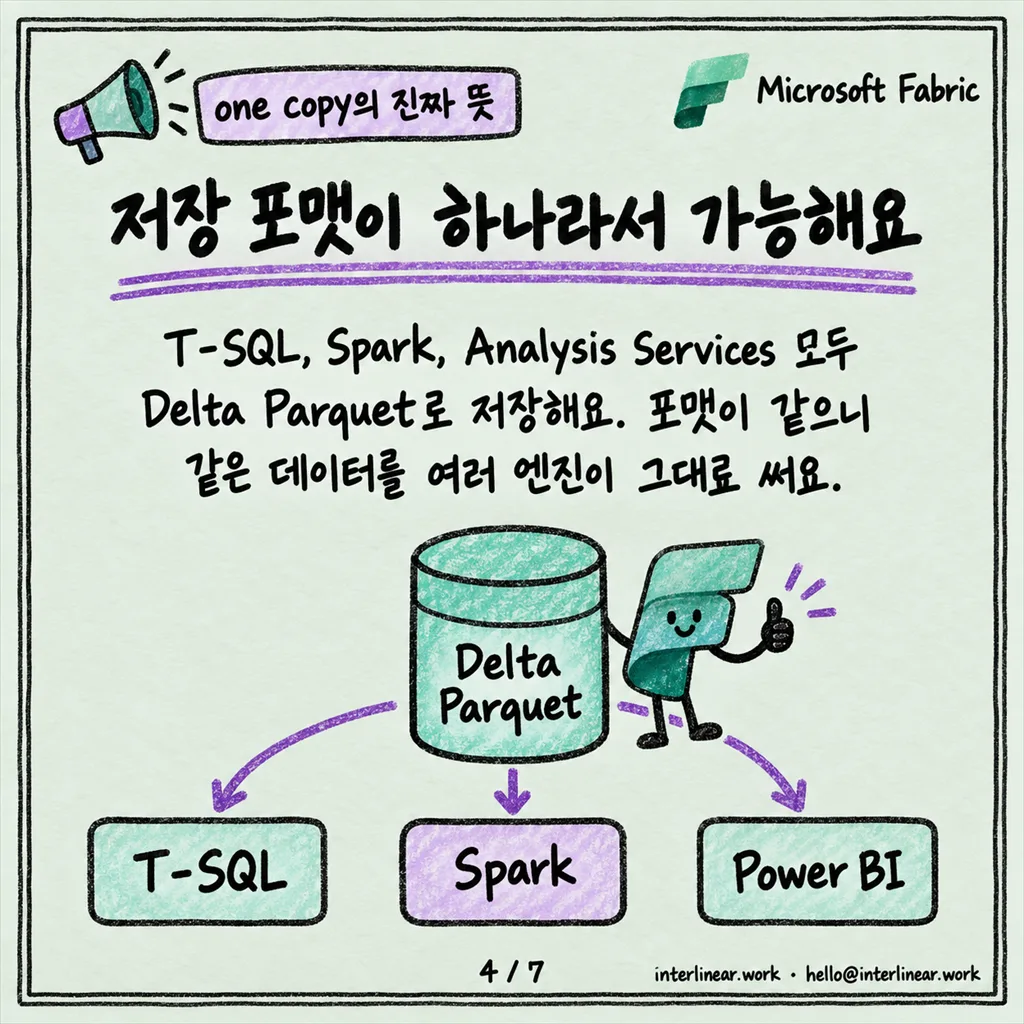
OneLake의 모든 분석 엔진 — T-SQL, Apache Spark, Analysis Services 등 — 은 데이터를 열린 표준 포맷인 Delta Parquet2로 저장해요. 포맷이 하나로 통일되어 있으니까, 같은 데이터를 여러 엔진에서 그대로 쓸 수 있어요.
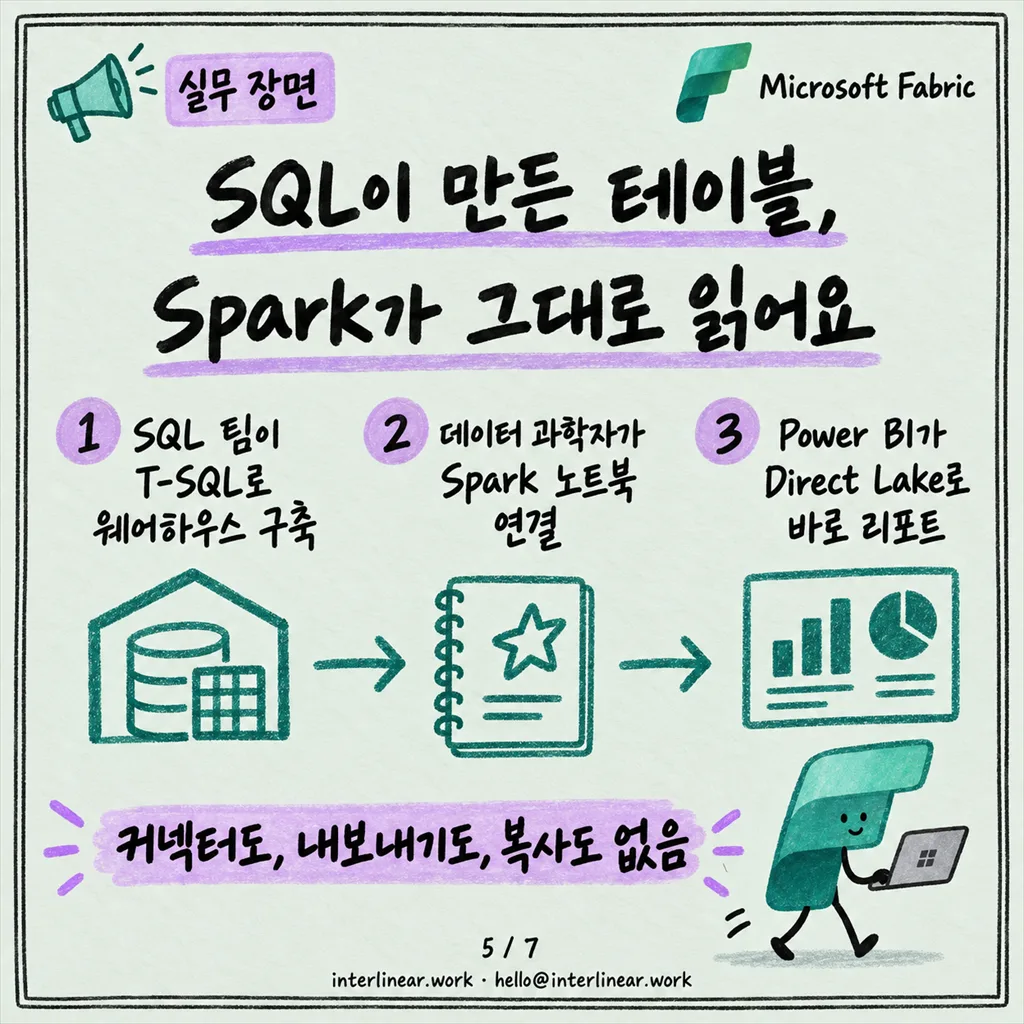
원문이 드는 예시가 실무 감각을 잘 보여줘요. SQL 엔지니어 팀이 T-SQL로 완전한 트랜잭션 방식 데이터 웨어하우스를 만들었다고 해봐요. 여기에 데이터 과학자가 끼어들고 싶으면, Spark 노트북을 OneLake에 연결해서 그 테이블을 바로 읽으면 돼요. 별도 커넥터도, 데이터 내보내기도 필요 없어요. 테이블이 Delta 포맷으로 저장되어 있기 때문이에요. SQL 쿼리와 Spark 잡이 정확히 같은 한 벌의 데이터 위에서 동작하는 거죠.
Power BI 쪽도 마찬가지예요. Analysis Services 엔진의 Direct Lake3 모드를 쓰면, 대용량 데이터를 별도로 복사하지 않고도 빠르게 불러와 리포트를 만들 수 있어요. SQL로 적재한 데이터를 Spark가 읽고, 그 위에 Power BI가 바로 올라가는 흐름이 전부 같은 저장소 안에서 일어나는 거예요.
예전에 왜 복사본이 늘어났었나
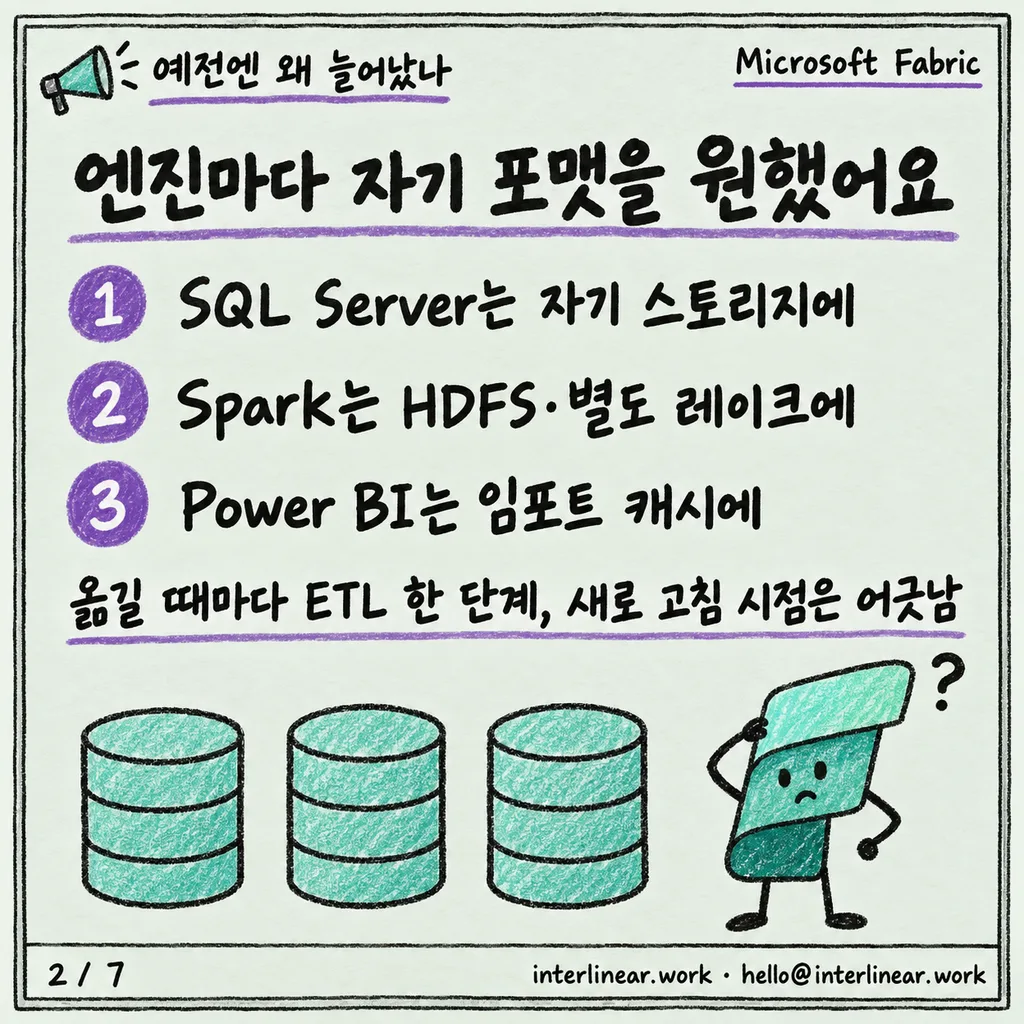
SQL·Power BI 환경에서 복사본이 늘어난 이유는 대개 단순했어요. 엔진마다 자기 포맷을 요구했기 때문이에요. SQL Server는 자기 스토리지에, Spark 클러스터는 HDFS나 별도 데이터 레이크에, Power BI는 자체 캐시(임포트 모드)에 데이터를 담아뒀어요. 엔진을 바꿔 쓰려면 데이터를 내보내고 다시 불러오는 ETL이 한 단계 더 필요했고, 그 단계마다 새로 고침 시점이 어긋나거나 스키마가 달라지는 문제가 생겼어요.
Fabric은 이 반복을 없애려고 애초에 “엔진은 여러 개, 저장 포맷은 하나”로 설계했어요. 데이터를 다른 엔진에서 쓰겠다고 복사할 필요도 없고, 데이터가 있는 곳 때문에 특정 엔진에 발이 묶일 이유도 없어졌어요.
Shortcut과 Mirroring도 결국 “복사 없이 잇는다”는 같은 원칙
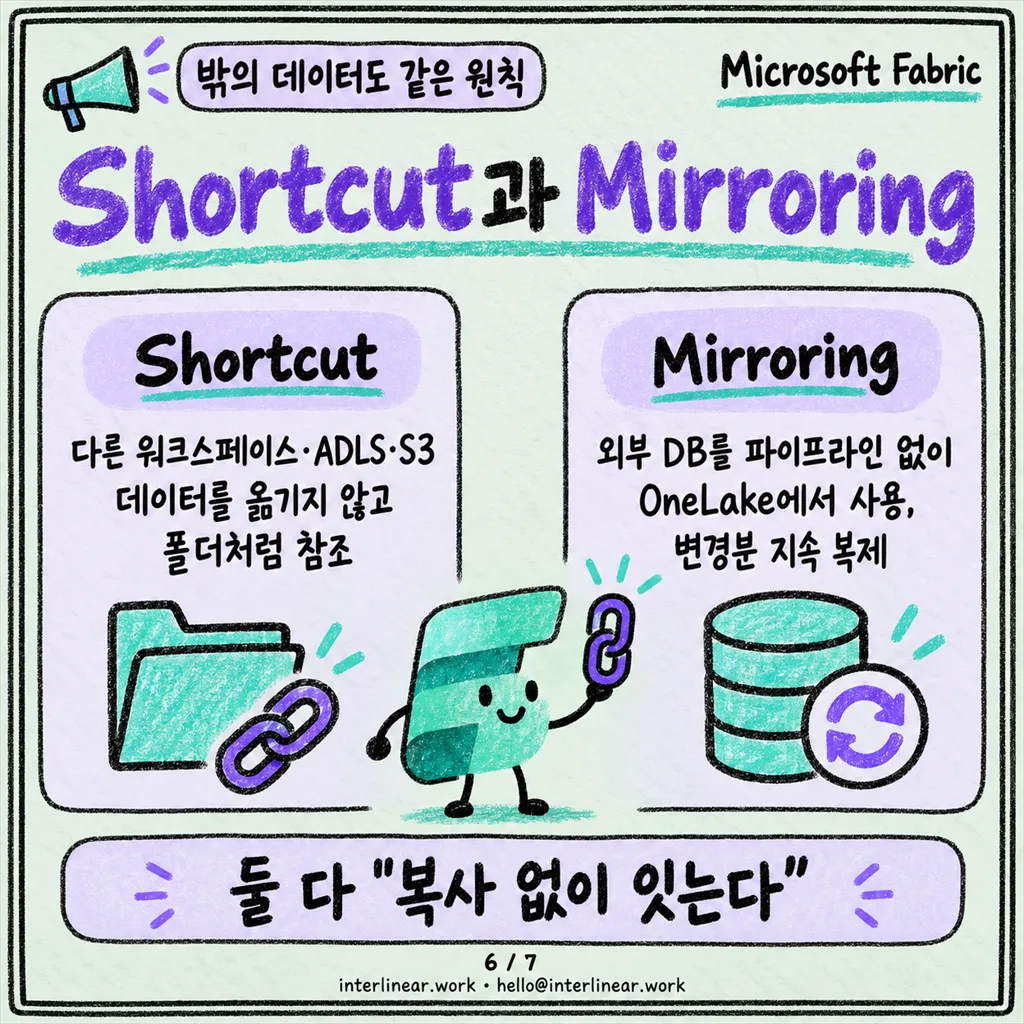
OneLake 밖에 있는 데이터도 이 원칙 안으로 끌어들이는 두 가지 장치가 있어요.
- Shortcut은 다른 위치(같은 워크스페이스, 다른 워크스페이스, 또는 OneLake 바깥의 ADLS·S3 등)에 있는 데이터를 실제로 옮기지 않고 폴더처럼 참조만 해요.
- Mirroring은 외부 운영 데이터베이스나 카탈로그를 파이프라인을 직접 만들지 않고도 OneLake에서 쓸 수 있게 해줘요. Database mirroring은 소스 변경분을 지속적으로 복제해 Delta 테이블로 만들고, Metadata mirroring은 외부 카탈로그 메타데이터만 동기화한 뒤 shortcut으로 원본 데이터를 그 자리에서 읽어요.
두 기능 모두 목적은 같아요. 데이터를 옮기거나 중복시키지 않고 조직 전체 관점에서 하나로 묶어 보는 것. Shortcut의 인증·캐시·비용 같은 구체적인 이야기는 분량이 있어서 다음 글에서 따로 다룰게요.
정리
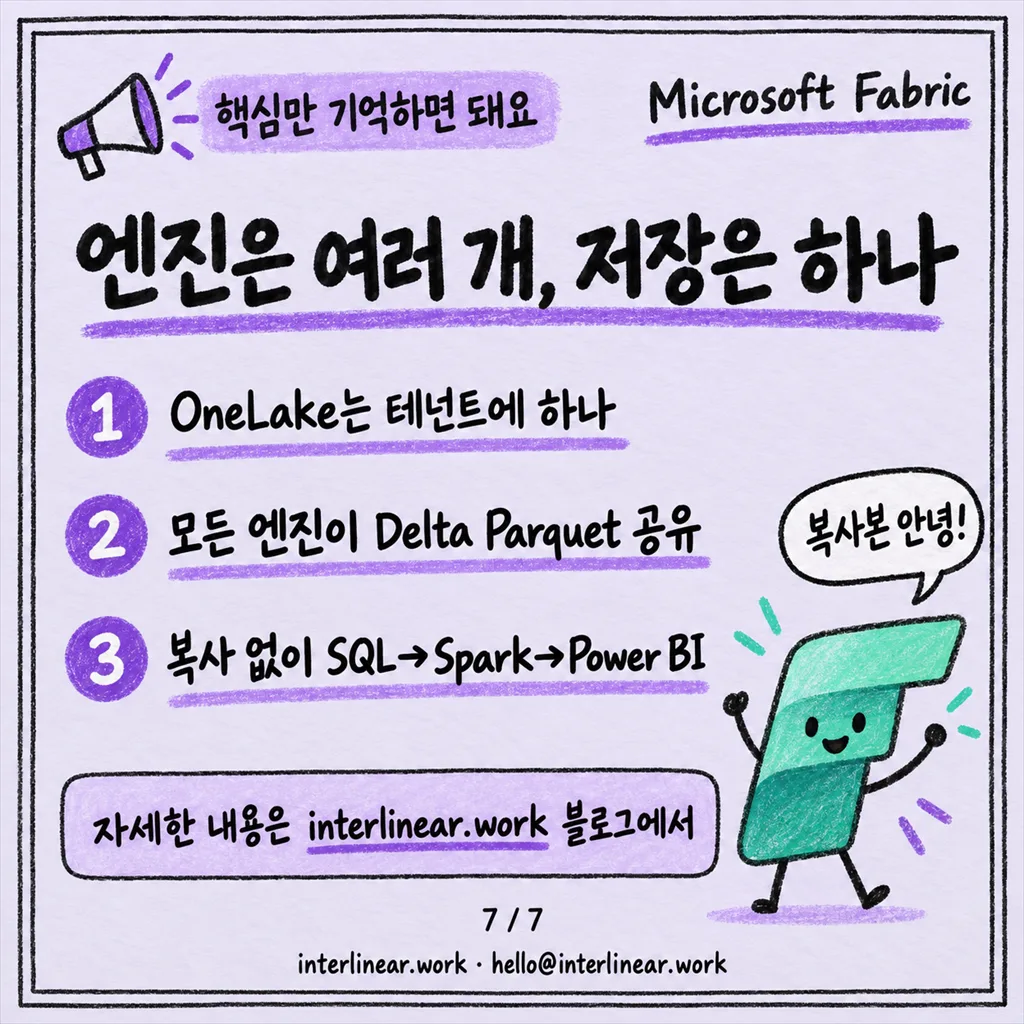
OneLake는 테넌트마다 하나뿐인 저장소이고, 모든 Fabric 엔진이 Delta Parquet라는 같은 포맷으로 데이터를 저장·공유해요. 그 결과 SQL로 적재한 테이블을 Spark가 그대로 읽고, Power BI가 Direct Lake로 복사 없이 리포트를 그릴 수 있어요. “엔진을 바꾸려면 데이터를 복사해야 한다”는 오래된 전제가 저장소 설계 단계에서부터 사라진 셈이에요.
어휘 주석
- 워크스페이스(workspace): Fabric에서 데이터·아이템을 묶어 관리하는 협업 단위. 각각 별도의 용량(capacity)과 권한 경계를 가져요.
- Delta Parquet: 컬럼 기반 저장 포맷인 Parquet에 트랜잭션 로그를 더해 ACID 트랜잭션·스키마 변경 이력까지 지원하는 오픈소스 테이블 포맷. Fabric의 기본 저장 포맷이에요.
- Direct Lake: Power BI가 데이터를 별도로 임포트하지 않고 OneLake의 Delta 테이블을 직접 읽어 리포트를 구성하는 데이터 접근 모드예요.