Spark 없이 가볍게: Fabric Python Notebook
데이터가 작으면 Spark 클러스터가 오히려 손해예요. 단일 노드에서 pandas·DuckDB·Polars로 돌아가는 Fabric Python Notebook의 구조와 Lakehouse 연동법을 정리했어요.
카드뉴스
1 / 7
원문: Use Python experience on Notebook 게시일: 2026-07-24 · 저자: Sneha Gunda(Microsoft, Fabric 데이터 엔지니어링 팀)
Fabric에서 노트북을 처음 열면 기본으로 Spark 세션이 떠요. 몇 GB짜리 CSV 하나 훑어보려는데도 클러스터가 뜨는 데 시간이 걸리고, 실행 중에는 코어 여러 개를 붙잡고 있어요. 데이터가 수백만 행 정도라면 이건 낭비예요. Spark는 애초에 여러 노드에 데이터를 흩뿌려 처리하려고 만든 엔진인데, 흩뿌릴 데이터가 별로 없으면 오히려 오버헤드만 남아요.
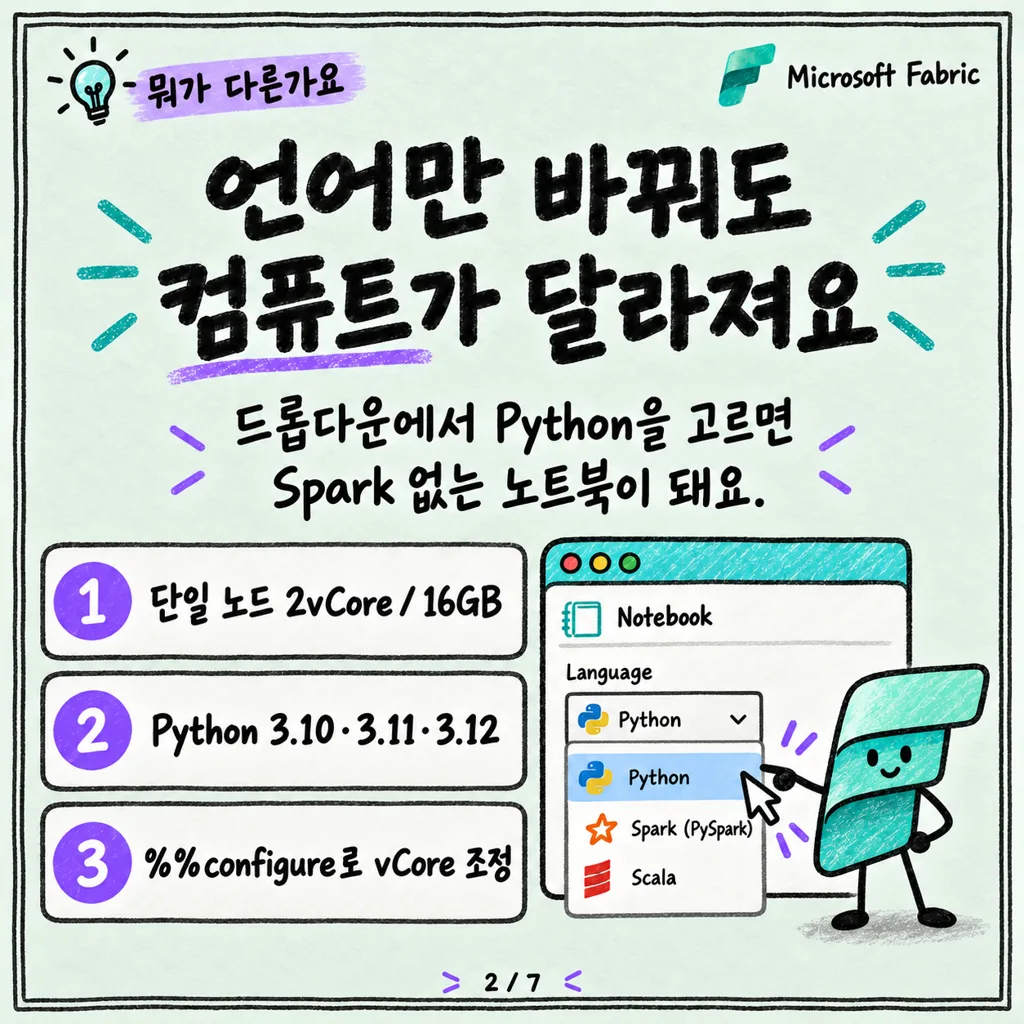
이 문제를 정면으로 겨냥한 게 Python Notebook이에요. Fabric 노트북에서 언어를 Spark 계열(PySpark 등) 대신 Python으로 바꾸면, Spark 없이 순수 Python 커널만으로 돌아가는 노트북이 돼요.
Spark Notebook과 뭐가 다른가요
- 단일 노드로 돌아요. 기본 컴퓨트는 2vCore/16GB 메모리예요. 여러 노드에 나눠 계산하는 대신 한 컴퓨터 안에서 끝내는 방식이라, 작은 데이터에서는 세션 준비도 빠르고 리소스도 덜 써요.
- Python 커널을 그대로 써요. 3.10·3.11·3.12 세 버전 중 골라 쓰고 기본값은 3.12예요.
%%configure매직 명령으로 세션의 vCore 수(4/8/16/32/64), 마운트 포인트, 기본 Lakehouse를 직접 조정할 수도 있어요. - Spark DataFrame 문법(
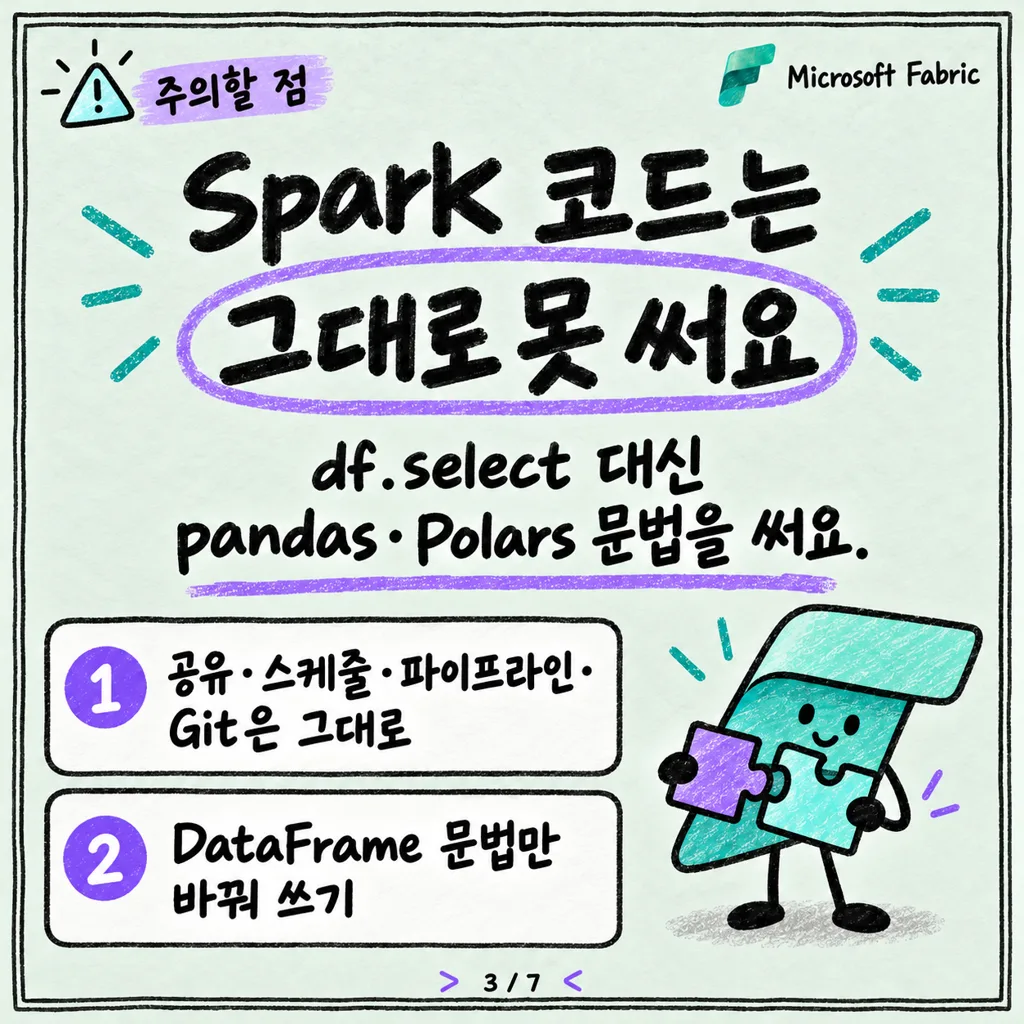
df.select,df.groupBy등)이 아니라 pandas·Polars 같은 순수 Python 라이브러리 문법을 써요. Spark 코드를 그대로 옮겨 쓸 수는 없어요.
즉 “노트북 언어 드롭다운에서 Python을 고르면 컴퓨트 자체가 달라지는” 구조예요. 노트북 공유, 스케줄 실행, 파이프라인 연동, Git 통합 같은 Fabric 노트북 공통 기능은 그대로 유지돼요.
미리 깔려 있는 라이브러리
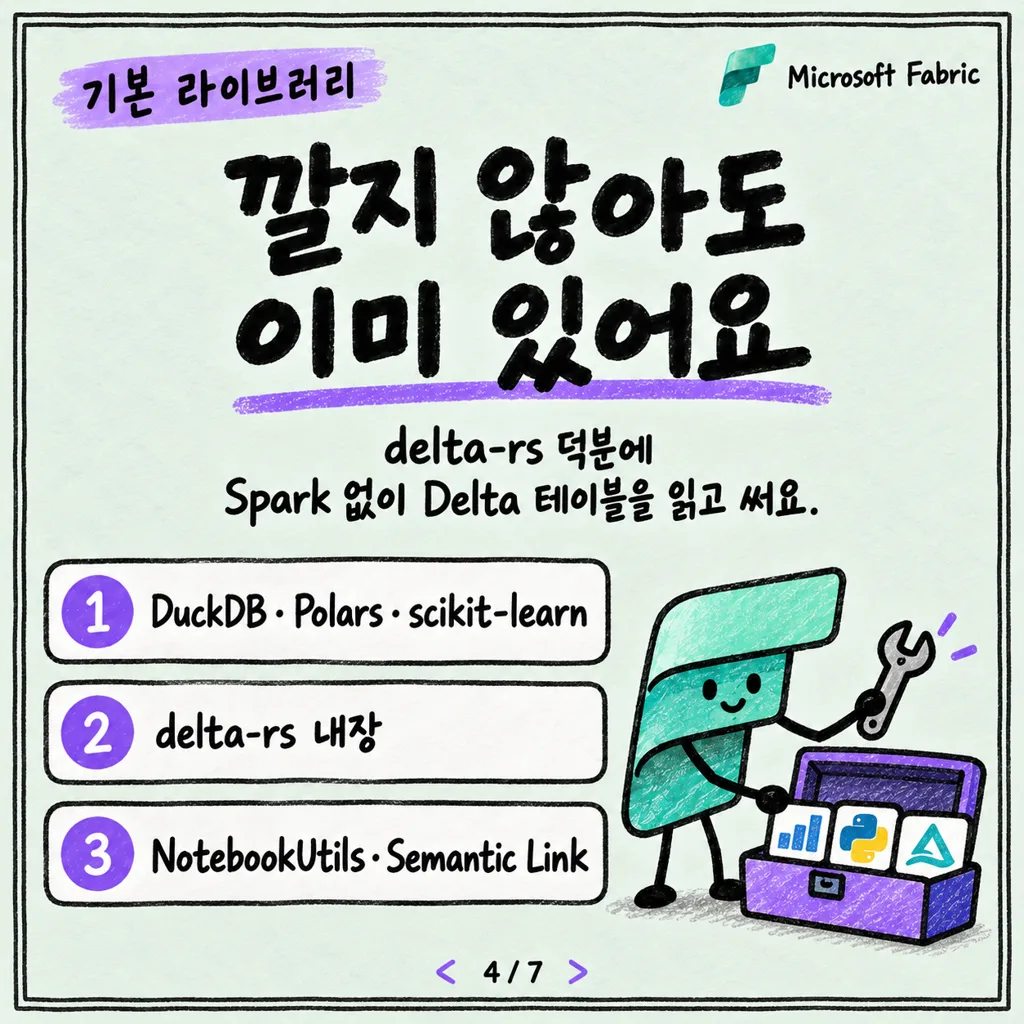
Python Notebook에는 DuckDB1, Polars2, scikit-learn 같은 라이브러리가 기본으로 설치돼 있어요. 여기에 더해 런타임 자체에 delta-rs3와 duckdb가 내장돼 있어서 별도 Spark 세션 없이도 Delta Lake 테이블을 읽고 쓸 수 있어요. NotebookUtils, Semantic Link(SemPy) 같은 Fabric 전용 유틸리티도 그대로 지원돼요.
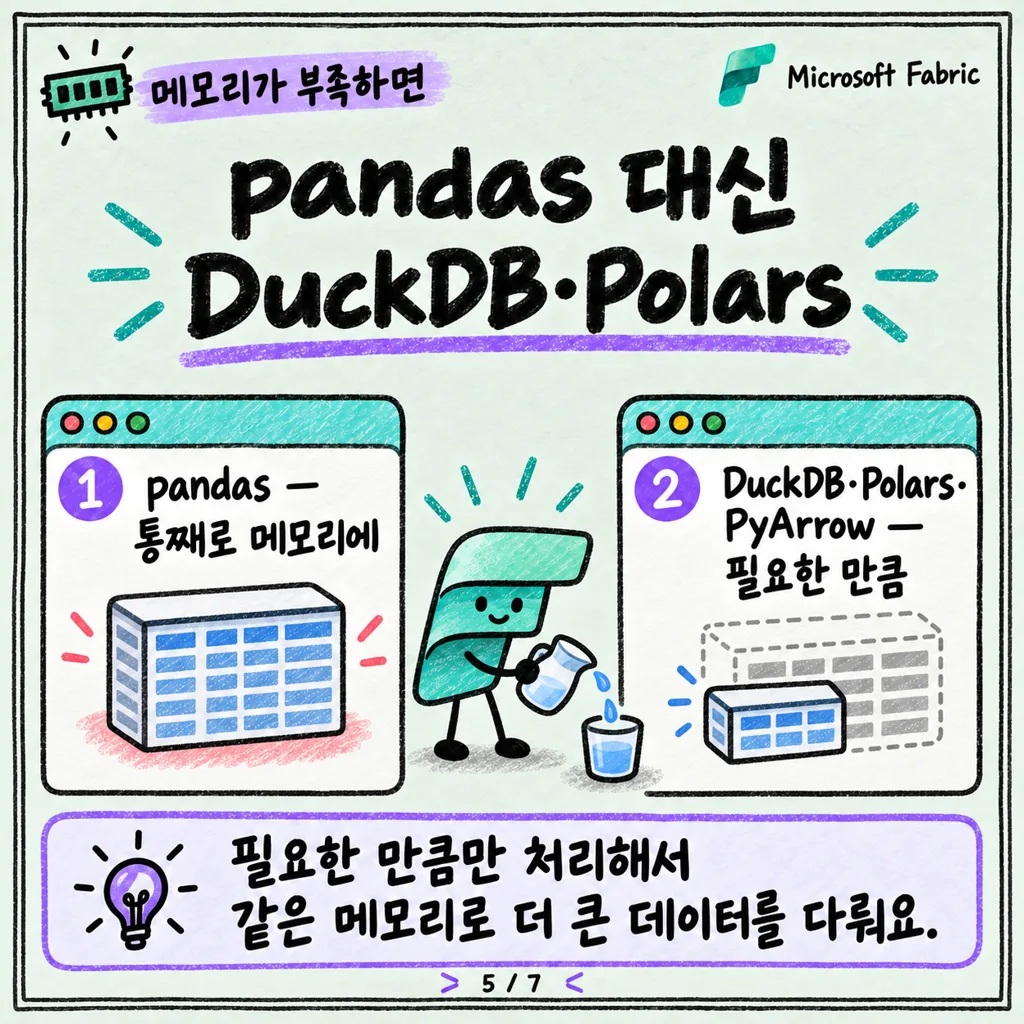
메모리가 부족해서 OOM(메모리 부족 오류)이 뜨면, pandas 대신 DuckDB·Polars·PyArrow 데이터프레임을 써보라는 게 공식 가이드의 조언이에요. pandas는 데이터를 통째로 메모리에 올리는 반면, DuckDB나 Polars는 쿼리를 실행할 때 필요한 만큼만 처리하도록 설계돼 있어서 같은 메모리에서 더 큰 데이터를 다룰 수 있거든요.
Lakehouse는 어떻게 읽고 쓰나요
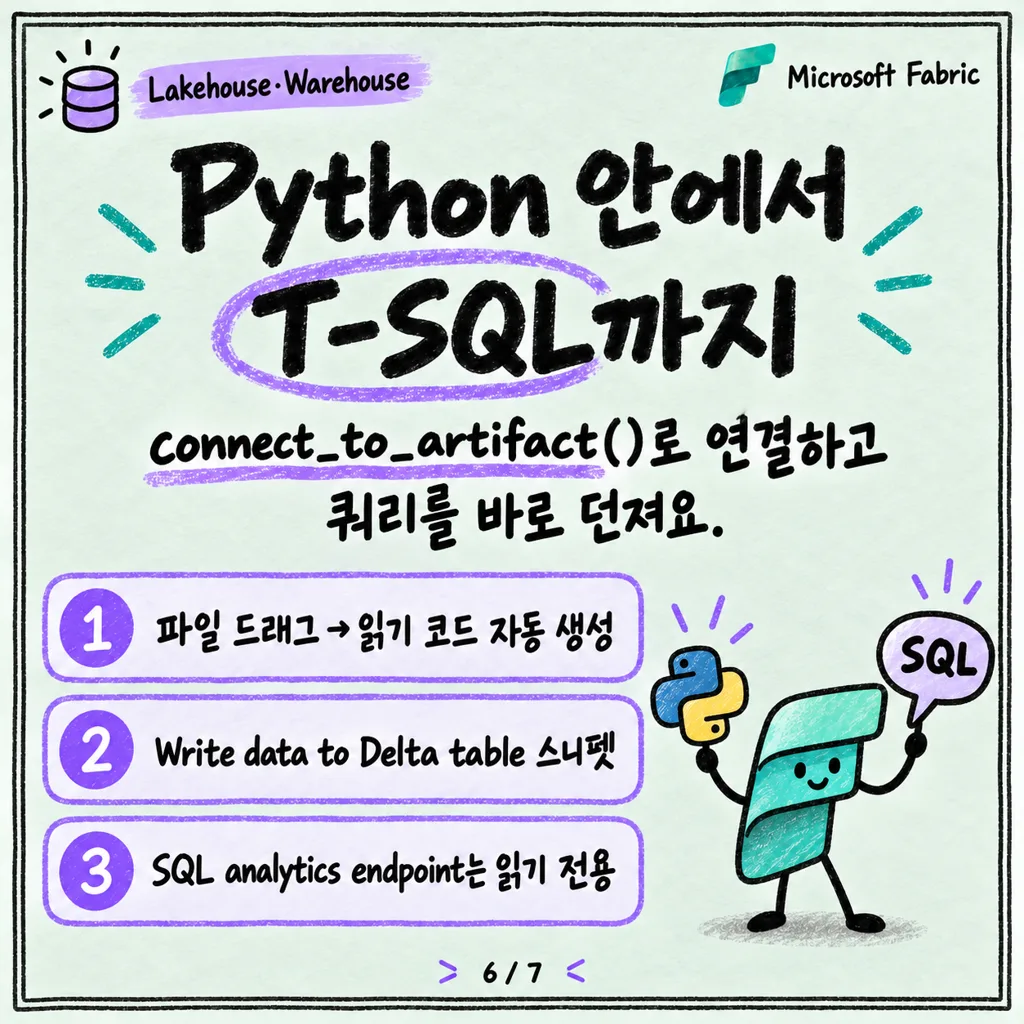
- Lakehouse를 노트북에 기본으로 붙여두면(또는 여러 개를 탐색기에 추가하면), 파일이나 Delta 테이블을 노트북 캔버스로 드래그 앤 드롭하는 것만으로 읽기 코드 스니펫이 자동 생성돼요.
- 쓰기는 Browse code snippet → Write data to Delta table 메뉴에서 코드 조각을 받아 시작하면 돼요.
- Warehouse나 SQL analytics endpoint와도 연결돼요.
notebookutils.data.connect_to_artifact()로 커넥션을 만든 뒤 T-SQL 쿼리를 그대로 던질 수 있어요. 단 SQL analytics endpoint는 읽기 전용이에요.
conn = notebookutils.data.connect_to_artifact("lakehouse_name_or_id")
df = conn.query("SELECT * FROM sys.schemas;")
Spark를 쓰지 않아도 Python 코드 안에서 T-SQL을 섞어 쓸 수 있다는 뜻이에요. Lakehouse·Warehouse를 넘나드는 소규모 집계·검증 작업이라면 이 한 줄짜리 흐름으로 충분히 끝나는 경우가 많아요.
언제 Python Notebook을 고르나요
- 탐색적 데이터 분석, 시각화, 소규모 머신러닝처럼 “빅데이터·분산 처리가 필요 없는” 작업.
- Lakehouse에서 몇백만 행 이하를 꺼내 pandas·Polars로 가공하고 다시 저장하는 정도의 파이프라인 스텝.
- 반대로 원본이 수억 행 이상이거나 여러 테이블을 조인하며 셔플이 많이 발생하는 변환이라면 여전히 Spark Notebook이 맞아요. Python Notebook은 단일 노드라 애초에 분산 처리를 하지 않으니까요.
파이프라인 안에서 Notebook 활동으로 오케스트레이션할 때도 언어만 다를 뿐 호출 방식은 같아서, 기존 Spark Notebook 활동을 Python Notebook으로 바꿔치기하는 것도 어렵지 않아요.
정리
Python Notebook은 “Fabric 노트북인데 Spark가 빠진 버전”이 아니라, 작은 데이터를 위한 별도 컴퓨트 경로예요. 단일 노드 2vCore/16GB 위에서 pandas·DuckDB·Polars로 움직이고, delta-rs 덕분에 Spark 없이도 Delta 테이블을 직접 읽고 써요. 데이터 크기가 애매하게 작다면 Spark 세션을 켜기 전에 이쪽을 먼저 시도해 볼 만해요.
어휘 주석
- DuckDB: 파일 하나로 동작하는 인메모리 분석용 SQL 엔진. 서버 설치 없이 라이브러리처럼 불러와 대용량 CSV·Parquet·Delta 파일에 SQL을 바로 실행할 수 있어요.
- Polars: Rust로 만든 고성능 Python 데이터프레임 라이브러리. pandas와 비슷한 문법을 쓰면서도 병렬 처리와 메모리 효율이 더 좋아요.
- delta-rs: JVM·Spark 없이 Rust로 구현된 Delta Lake 클라이언트 라이브러리. Python에서 Spark를 띄우지 않고도 Delta 테이블을 읽고 쓸 수 있게 해줘요.