원본에 컬럼이 하나 늘었을 때: Fabric에서 스키마 변화 다루기
Copy activity·Dataflow Gen2·Notebook은 원본 테이블에 컬럼이 추가되면 각자 다르게 반응해요. mergeSchema는 언제 켜야 하는지, 무엇을 기본으로 켜둘지 정리했어요.
카드뉴스
1 / 7
원문: Schema evolution for Delta tables 게시일: 2026-05-18 · 저자: Sneha Gunda(Microsoft, Fabric 데이터 엔지니어링 팀)
원본 시스템에 컬럼 하나가 추가되는 건 흔한 일이에요. 문제는 그게 우리 쪽 파이프라인에 도착했을 때 무슨 일이 벌어지느냐예요. 어떤 도구는 조용히 새 컬럼을 무시하고, 어떤 도구는 그 자리에서 실패하고, 어떤 도구는 알아서 스키마를 넓혀줍니다. Fabric 안에서도 Copy activity, Dataflow Gen2, Notebook(Delta 테이블 쓰기)이 이 상황에 각각 다르게 반응해요.
Delta 테이블의 기본값은 “거부”예요
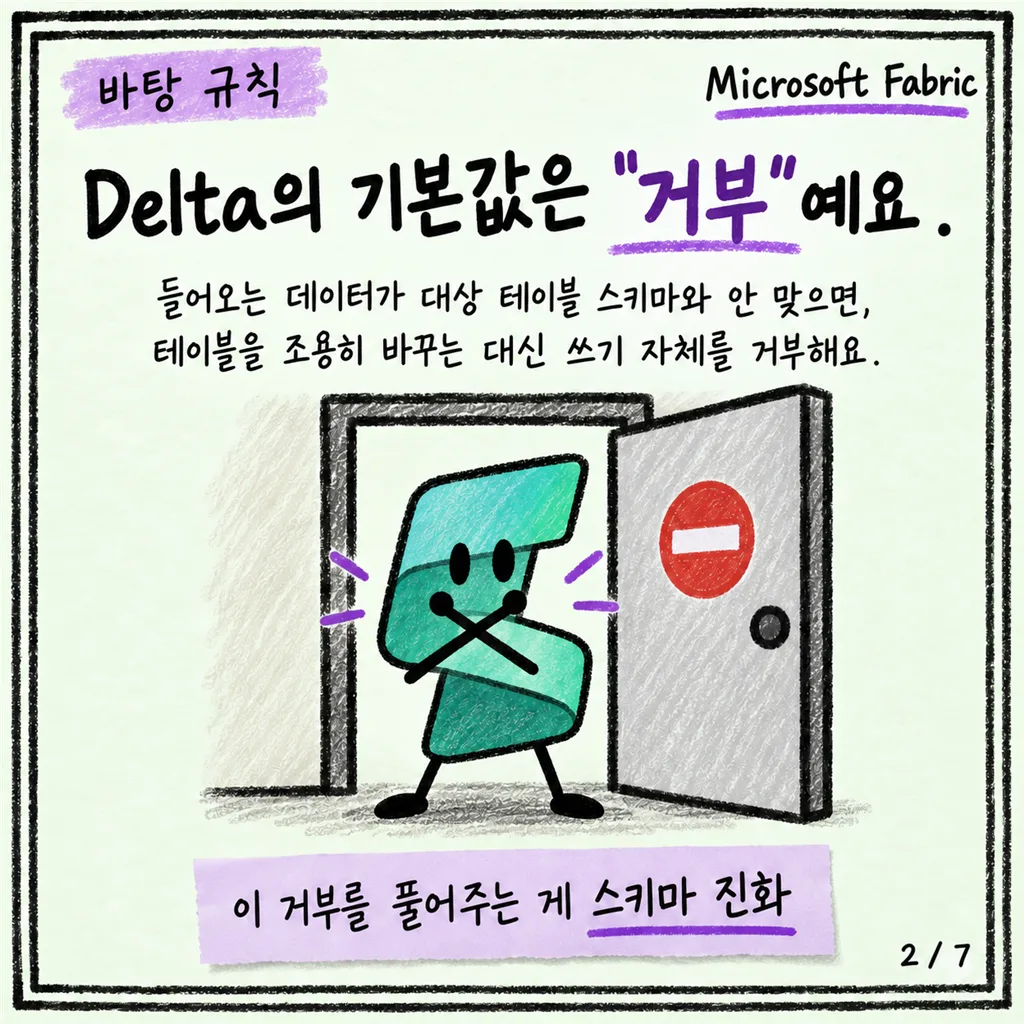
먼저 바탕이 되는 규칙부터예요. Delta Lake1는 기본적으로 쓰기 시점에 스키마를 강제해요. 들어오는 데이터가 대상 테이블의 스키마와 맞지 않으면, 테이블을 조용히 바꾸는 대신 쓰기 자체를 거부합니다. 예를 들어 대상 테이블이 customer_id, order_date, amount 컬럼을 기대하는데 원본에 예상 못 한 컬럼이나 다른 타입이 섞여 들어오면, 명시적으로 허용하기 전까지는 그 쓰기가 실패해요. 스키마가 의도치 않게 흘러가는(drift) 걸 막기 위한 안전장치예요.
이 기본 동작을 바꾸는 옵션이 바로 스키마 진화(schema evolution)예요.
Notebook·Spark: mergeSchema로 컬럼 추가하기
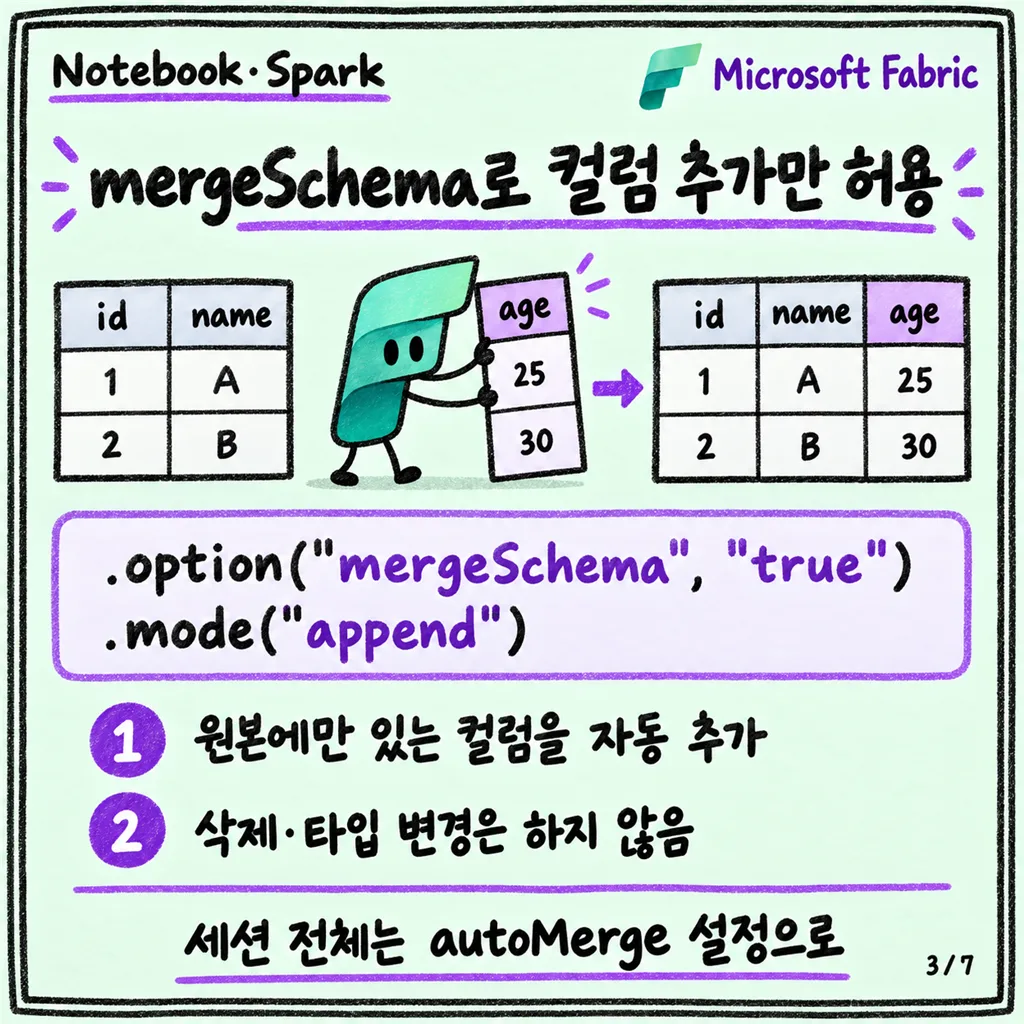
Notebook에서 Spark로 Delta 테이블에 쓸 때, 원본에 새로 생긴 컬럼을 기존 테이블에 반영하고 싶다면 mergeSchema 옵션을 켜면 돼요. 원본에는 있는데 대상 테이블에는 없는 컬럼을 자동으로 추가해 주는 옵션이고, 기존 컬럼을 지우거나 타입을 바꾸지는 않아요. 즉 추가만 되는(additive) 변화에 한해 동작해요.
df.write \
  .format("delta") \
  .option("mergeSchema", "true") \
  .mode("append") \
  .saveAsTable("sales")
세션 전체에 적용하고 싶으면 Spark 설정으로 자동 병합을 켜둘 수도 있어요.
spark.conf.set("spark.databricks.delta.schema.autoMerge.enabled", "true")컬럼을 이름 대신 순서로 추적하던 방식에서 벗어나 이름 기준으로 추적하게 하는 컬럼 매핑을 켜두면, ALTER TABLE ... RENAME COLUMN·DROP COLUMN처럼 이름 변경·삭제도 데이터 전체를 다시 쓰지 않고 처리할 수 있어요. 반대로 테이블 스키마를 통째로 새 DataFrame 스키마로 바꿔치기하는 overwriteSchema는 기존 스키마 계약을 깨는 파괴적인 옵션이라 신중하게 써야 해요. MERGE INTO 구문에도 WITH SCHEMA EVOLUTION 절을 붙이면 업서트2 과정에서 새 컬럼을 함께 반영할 수 있어요.
Copy activity: 이름 기준 매핑, 실패는 다른 이유로
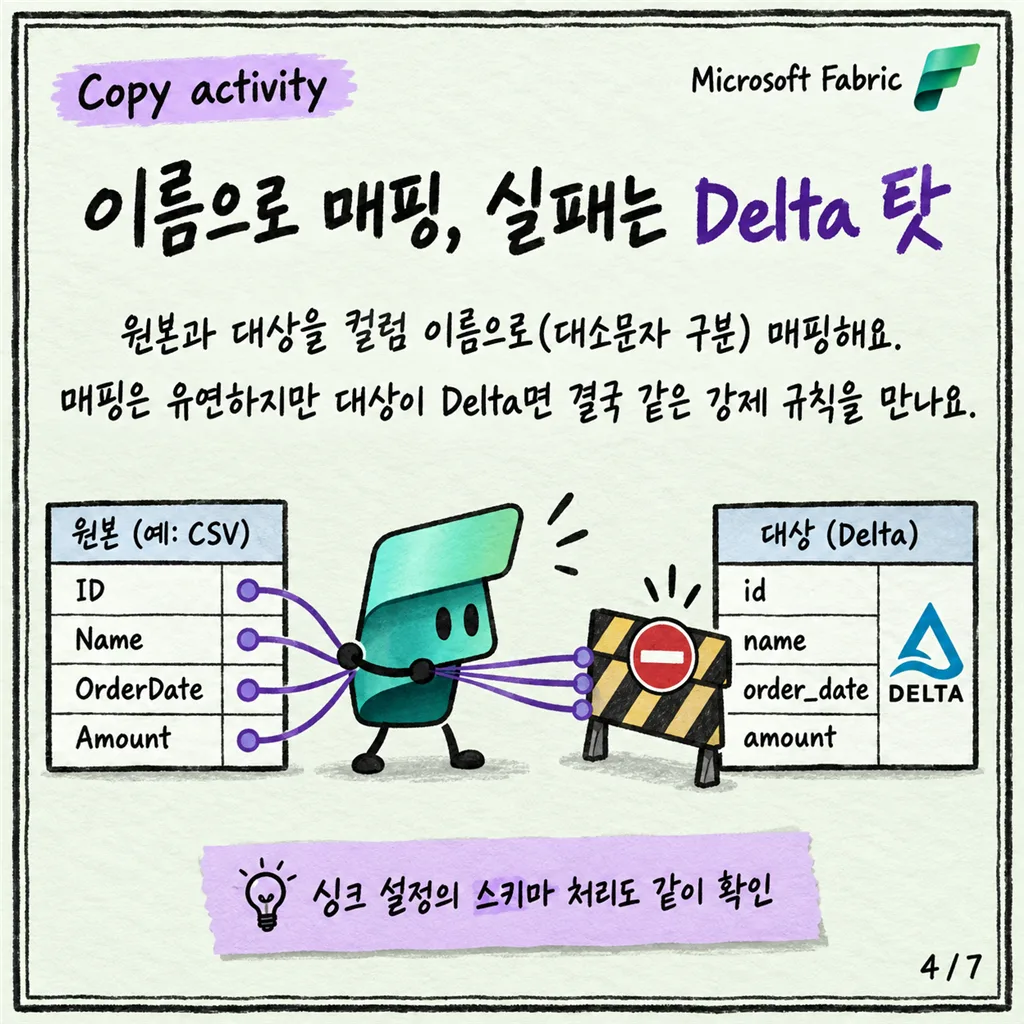
Copy activity는 기본적으로 원본과 대상을 컬럼 이름으로 대소문자까지 구분해서 매핑해요. 대상이 아직 없으면(파일로 쓰는 경우 등) 원본 필드 이름이 그대로 대상 이름이 되고, 대상이 이미 있으면 원본에서 복사하는 모든 컬럼을 대상이 갖고 있어야 해요. 이 기본 매핑 방식 자체는 실행마다 원본 스키마가 조금씩 달라지는 상황(스키마 드리프트)을 유연하게 받아주도록 설계돼 있어요. 즉 원본이 반환하는 데이터는 기본적으로 그대로 대상에 복사될 수 있는 구조예요.
다만 대상이 Delta 테이블이라면, 결국 Copy activity가 쓰는 시점에 Delta Lake의 스키마 강제 규칙이 그대로 적용돼요. 원본에 새 컬럼이 생겼는데 대상 Delta 테이블에는 없다면, Delta 쪽에서 그 쓰기를 거부할 수 있다는 뜻이에요. 그래서 Copy activity의 매핑 유연성과 별개로, 대상이 Delta 테이블일 때는 Notebook 쪽과 마찬가지로 스키마 진화 옵션을 함께 고려해야 해요.
Dataflow Gen2: 자동 설정이냐, 고정 스키마냐
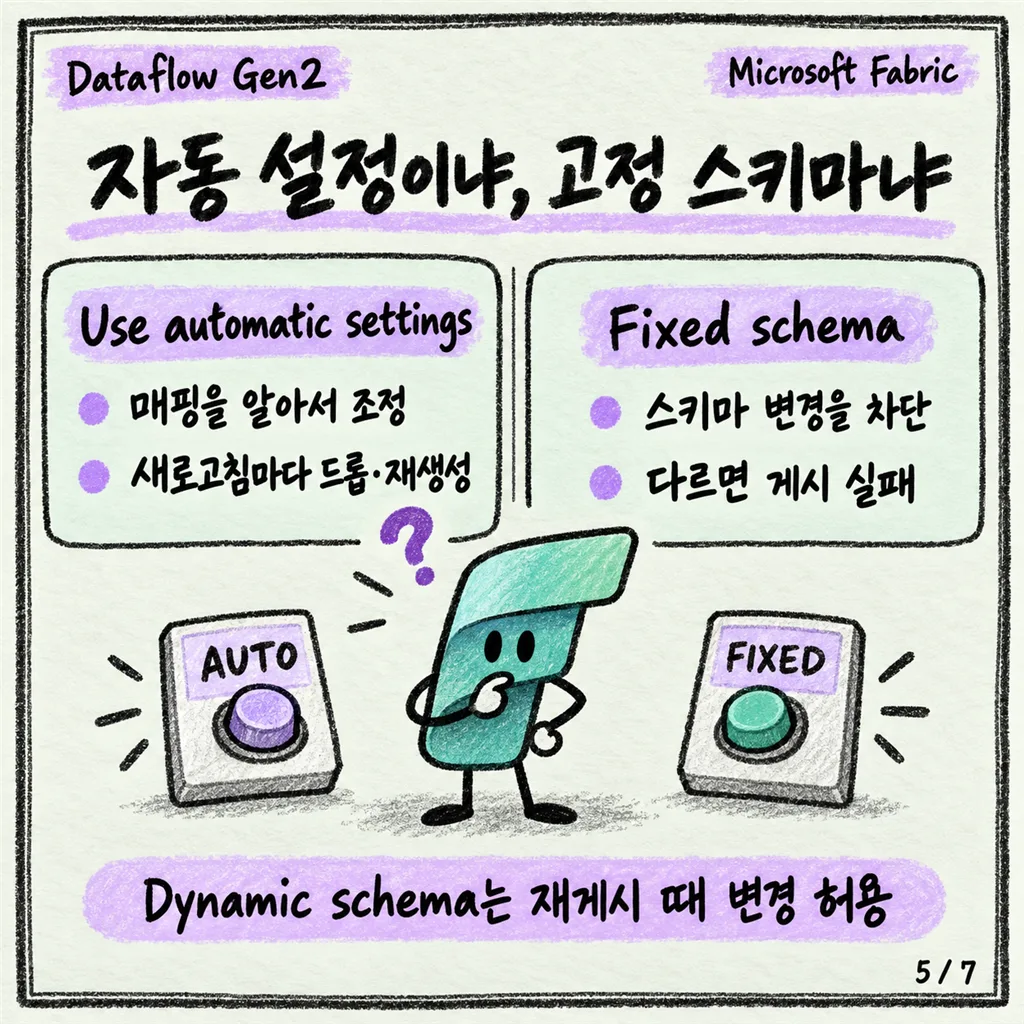
Dataflow Gen2는 목적지 설정 화면에서 스키마 변화를 다루는 방식을 고를 수 있어요.
- Use automatic settings를 켜두면(신규 테이블 로드 시 기본값), 매핑을 Fabric이 알아서 맞춰줘요. 쿼리에 컬럼을 추가하거나 타입을 바꾸고 다시 게시하면 매핑도 따라서 조정돼요. 이때 대상 테이블은 새로 고침마다 드롭하고 다시 만들어지기 때문에, 테이블에 나중에 추가해 둔 관계나 측정값이 사라질 수 있어요. 자동 설정은 지금 Lakehouse와 Azure SQL 데이터베이스 대상에서만 동작해요.
- 자동 설정을 끄면 수동으로 컬럼 매핑을 제어할 수 있고, 업데이트 방식도 Replace(매번 지우고 교체)와 Append(기존 데이터에 추가) 중 고를 수 있어요.
- 게시 시점 스키마 옵션은 업데이트 방식이 Replace일 때만 의미가 있어요. Dynamic schema는 재게시할 때 스키마 변경을 허용하고(역시 테이블을 드롭·재생성), Fixed schema는 스키마 변경을 아예 막아서 쿼리 스키마가 대상과 다르면 게시 자체가 실패해요. 대상에 관계나 측정값을 만들어 뒀고 스키마를 바꿀 계획이 없다면 Fixed가 안전한 선택이에요.
어떤 걸 기본으로 켜둘까
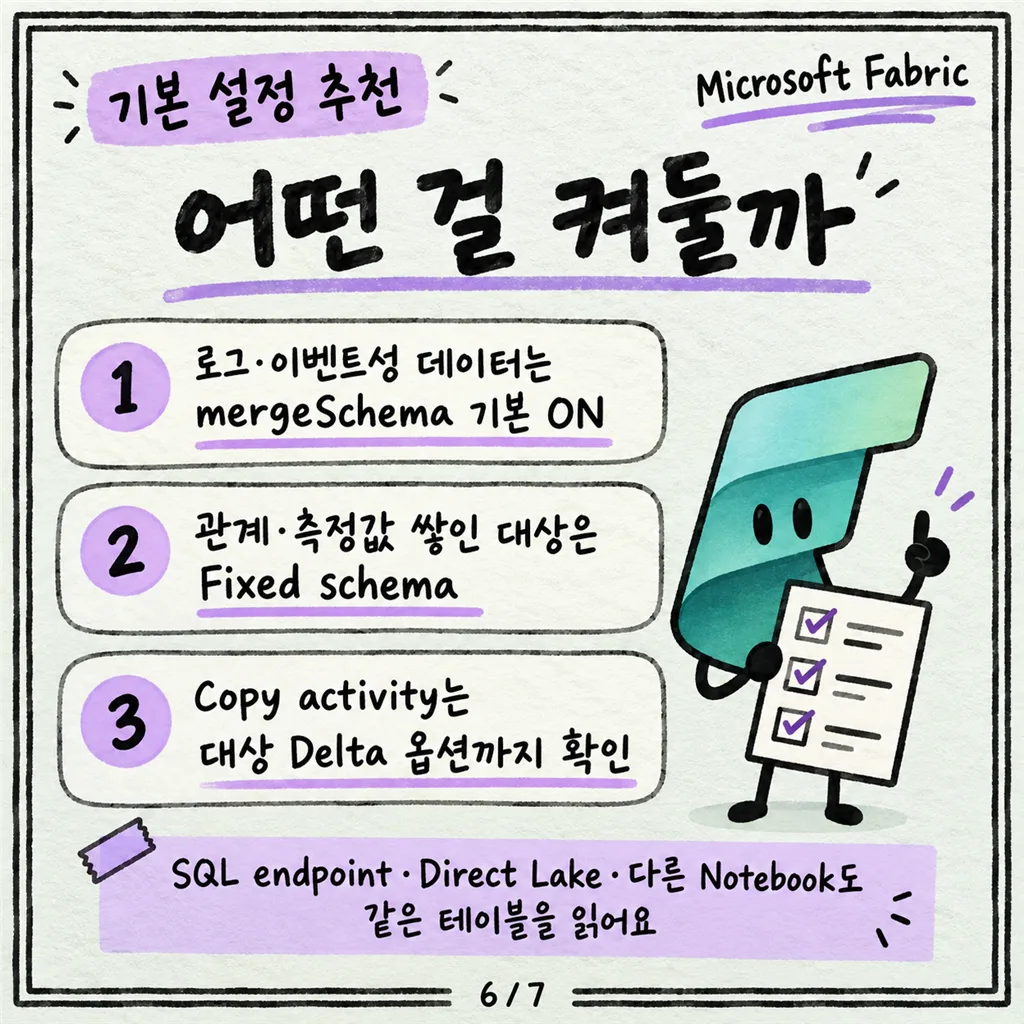
- 원본이 계속 컬럼을 늘려가는 로그성·이벤트성 데이터를 Notebook으로 적재한다면,
mergeSchema를 기본으로 켜두는 쪽이 파이프라인을 안 죽입니다. 다만 이건 “추가”만 받아주지 컬럼 삭제나 타입 변경까지 조용히 넘어가진 않는다는 점은 기억해 둬야 해요. - Dataflow Gen2로 Lakehouse에 적재하면서 관계·측정값을 쌓아둔 대상이라면 Fixed schema로 못을 박아, 예상 못 한 스키마 변경이 조용히 테이블을 드롭·재생성하는 사고를 막는 편이 낫습니다.
- Copy activity는 매핑 자체는 유연하지만 대상이 Delta라면 결국 Delta의 강제 규칙을 벗어나지 못한다는 점을 감안해서, 대상 테이블 쪽 옵션(예: 싱크 설정의 스키마 처리)을 같이 확인해야 해요.
- 어떤 경로든, 스키마 변경은 원본 테이블에서 끝나지 않아요. SQL analytics endpoint, Power BI Direct Lake, 다른 Notebook이 같은 테이블을 읽고 있다면 컬럼 이름 변경·삭제·타입 변경이 그쪽 쿼리를 깨뜨릴 수 있어요. 프로덕션 테이블을 바꾸기 전엔 이 다운스트림부터 확인하는 게 먼저예요.
정리
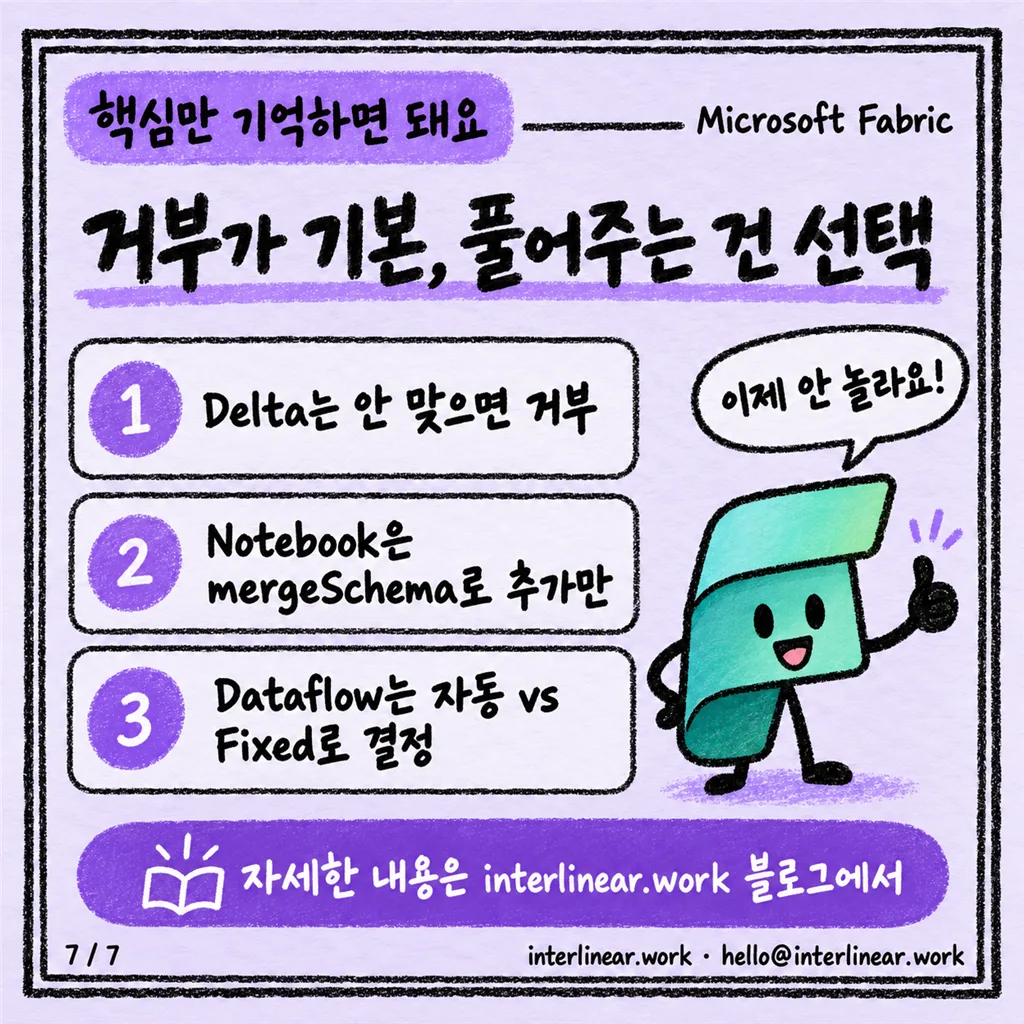
Delta 테이블은 기본적으로 스키마가 안 맞으면 쓰기를 거부하고, 이 거부를 풀어주는 게 mergeSchema(Notebook·Spark)예요. Copy activity는 이름 기준 매핑이 유연하지만 대상이 Delta면 결국 같은 강제 규칙을 만나고, Dataflow Gen2는 자동 설정이냐 Fixed schema냐로 “드롭·재생성을 허용할지”를 명시적으로 고르게 돼 있어요. 셋 다 규칙이 다르니, 원본이 얼마나 자주 바뀌는지와 대상에 걸린 관계·측정값이 있는지를 기준으로 도구별 옵션을 미리 정해두는 게 좋아요.
어휘 주석
- Delta Lake: Parquet 파일 위에 트랜잭션 로그를 얹어서, 일반 파일 저장소에 데이터베이스에 가까운 스키마 강제·버전 관리 기능을 더한 오픈소스 저장 포맷. Fabric Lakehouse의 테이블은 기본적으로 이 포맷을 씁니다.
- 업서트(upsert): update와 insert를 합친 말로, 키가 이미 있으면 갱신하고 없으면 새로 추가하는 쓰기 방식이에요.