SQL analytics endpoint는 읽기 전용이에요 — 그리고 가끔 늦어요
Lakehouse에 자동으로 붙는 SQL analytics endpoint는 T-SQL 조회는 되지만 쓰기는 안 돼요. Spark로 쓴 테이블이 보이기까지 생기는 메타데이터 동기화 지연까지, 초심자가 부딪히는 두 가지 함정을 정리했어요.
카드뉴스
1 / 7
원문: SQL analytics endpoint metadata sync 게시일: 2026-05-29 · 저자: William D. Assaf
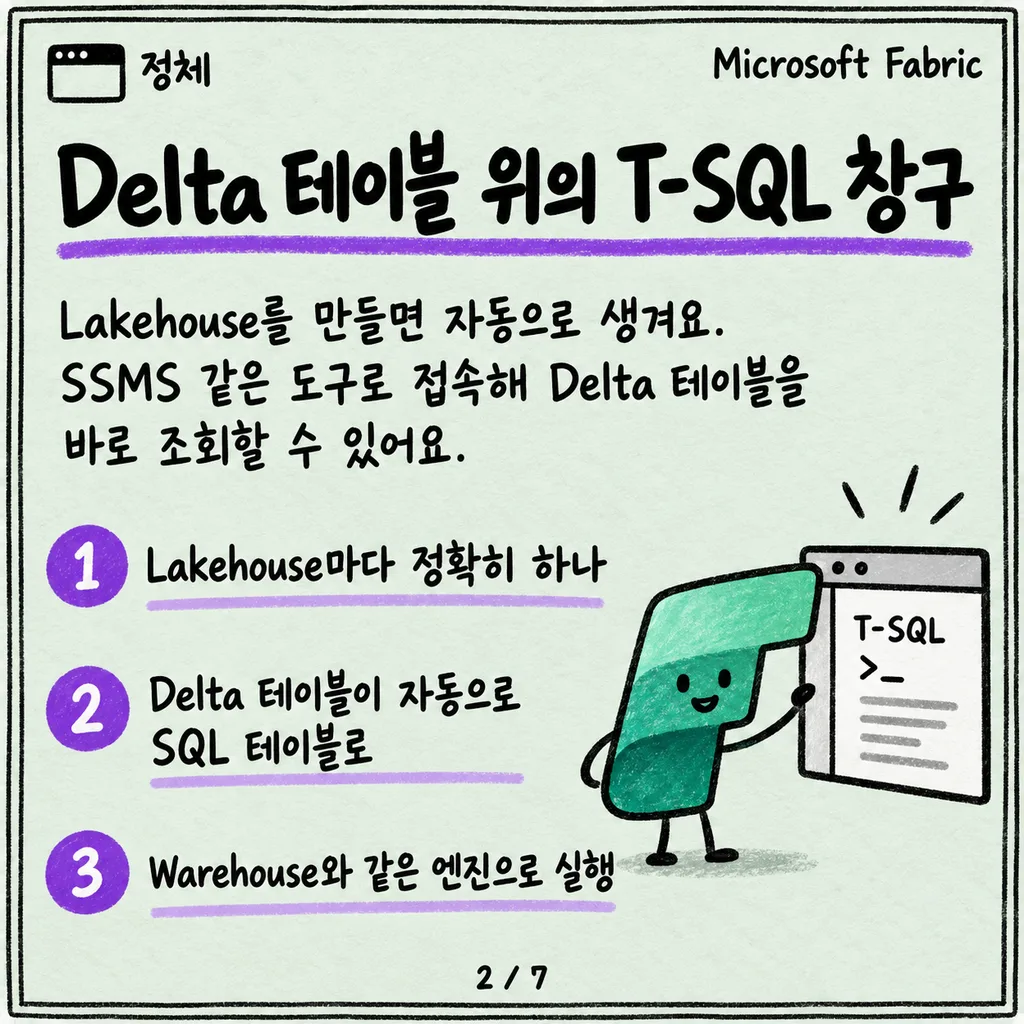
Lakehouse를 처음 만들면 아무것도 안 했는데 SQL analytics endpoint가 자동으로 붙어 있어요. SQL Server Management Studio든 Fabric 포털 쿼리 창이든, TDS 프로토콜을 쓰는 도구라면 그대로 접속해서 T-SQL로 Delta 테이블을 조회할 수 있죠. 데이터를 옮기거나 복사할 필요도 없어요.
문제는 여기서부터예요. SQL에 익숙한 사람일수록 “쿼리가 되니까 당연히 INSERT도 되겠지”라고 기대하기 쉬운데, 실제로는 그렇지 않아요. 그리고 Spark로 방금 쓴 테이블이 SQL 쪽에 바로 보이지 않는 경우도 있어요. 이 두 가지가 초심자가 가장 자주 부딪히는 함정이에요.
함정 1: 조회는 되지만 쓰기는 안 돼요
SQL analytics endpoint의 정체를 한 문장으로 정리하면 이래요. Lakehouse의 Delta 테이블 위에 자동으로 얹히는 읽기 전용 T-SQL 조회 표면이에요.
- Lakehouse, Warehouse, 데이터베이스, 미러링된 데이터베이스는 각각 정확히 하나의 SQL analytics endpoint를 가져요.
- 밑에 있는 각 Delta 테이블은 자동으로 endpoint의 SQL 테이블로 나타나요.
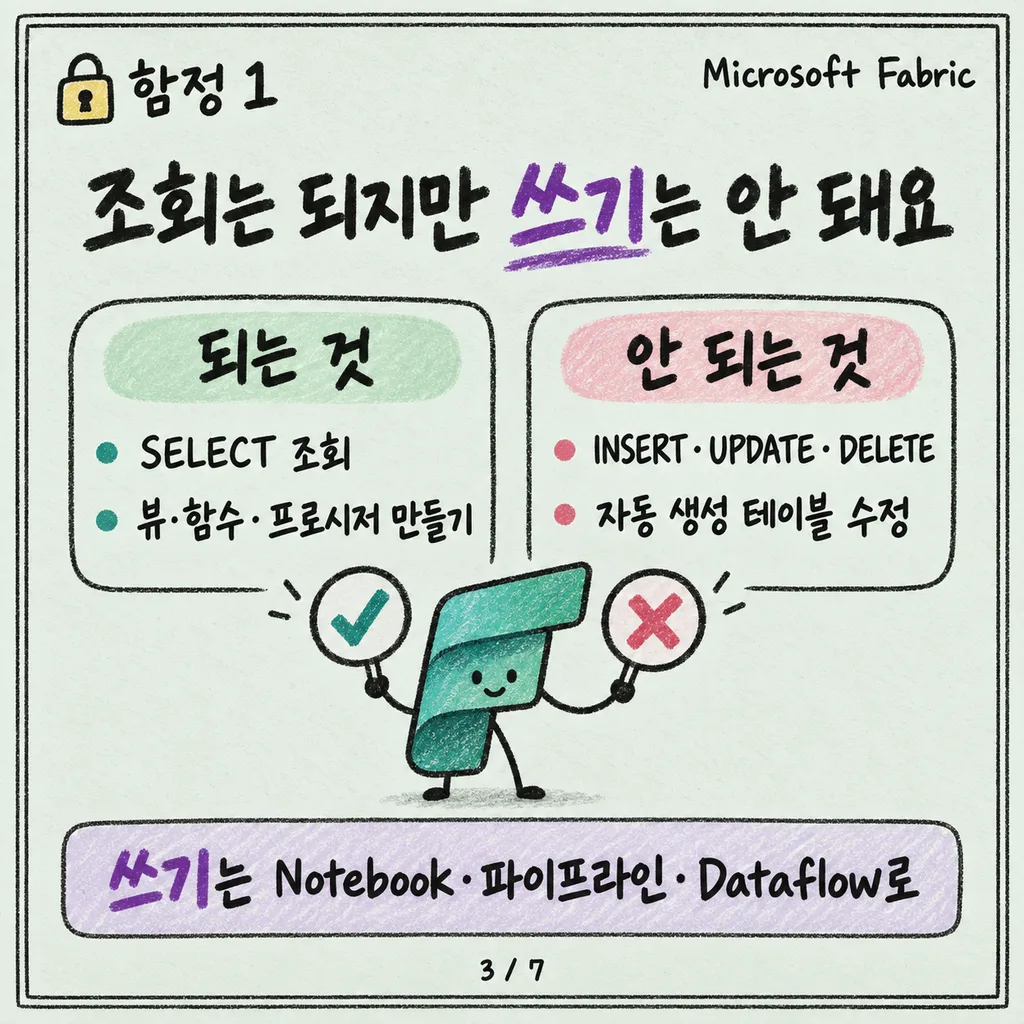
- 자동 생성된 테이블에 대해서는 endpoint가 읽기 전용이에요. 다만 여러분이 직접 만드는 스키마, 뷰, 저장 프로시저, 함수로는 모델을 확장할 수 있어요.
- endpoint는 Fabric Data Warehouse와 같은 컴퓨트 엔진으로 구동돼서, Delta 파일에 대해 고성능·저지연 SQL 쿼리를 제공해요.
즉 INSERT·UPDATE·DELETE 같은 DML은 자동 생성 테이블에서 쓸 수 없어요. 데이터를 쓰려면 Spark 노트북이나 파이프라인, 데이터플로우처럼 Lakehouse 쪽 경로를 써야 해요. SQL 쪽에서는 뷰·테이블 반환 함수(TVF) 같은 조회용 객체를 얹어서 모델을 확장하는 정도가 한계예요. “왜 내가 만든 뷰는 되는데 원본 테이블엔 INSERT가 안 되지?“라는 질문이 나온다면, 그게 정확히 이 읽기 전용 경계 때문이에요.
함정 2: Spark가 쓴 테이블이 SQL에 바로 안 보일 수 있어요
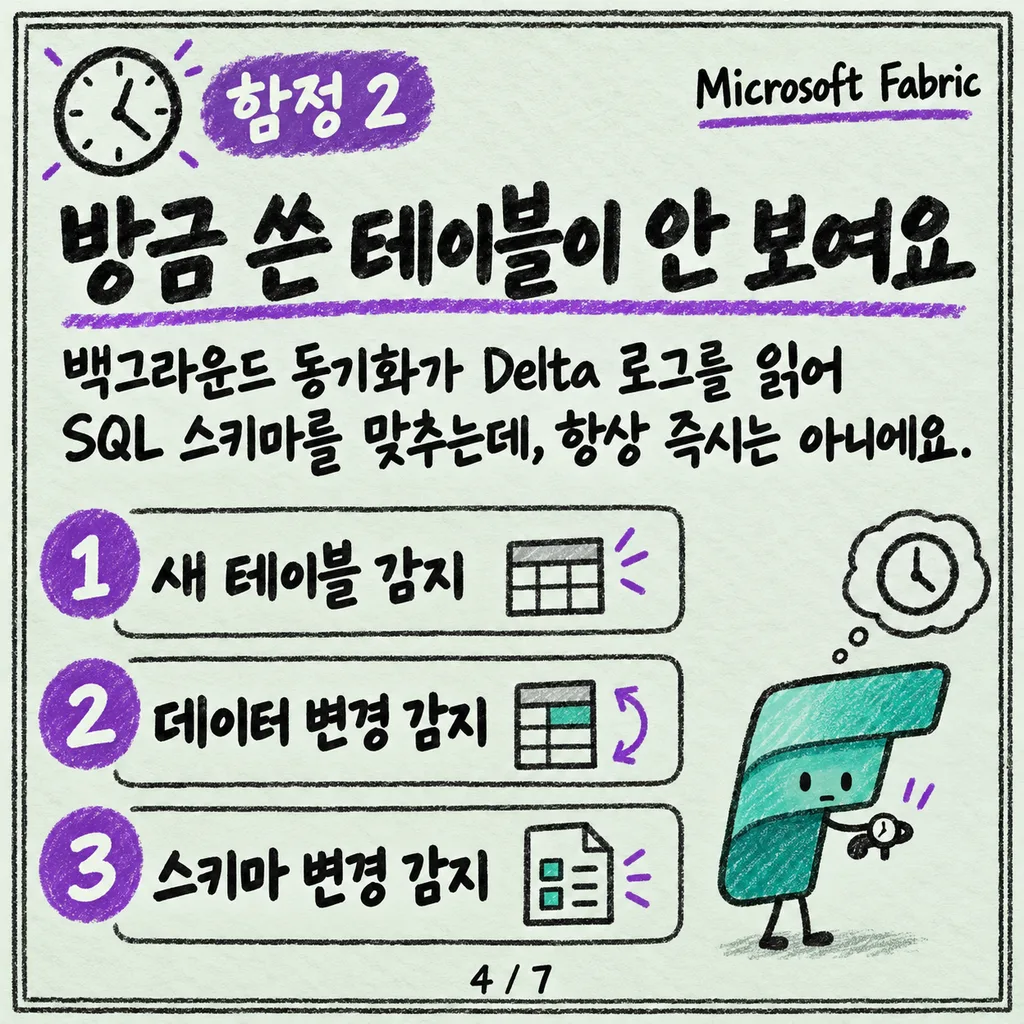
두 번째 함정은 지연이에요. Fabric은 SQL analytics endpoint를 밑단의 Lakehouse와 자동으로 동기화해줘요. 별도 인프라를 설정할 필요도, 대부분의 경우 사용자가 손댈 일도 없어요. 이 백그라운드 동기화 프로세스가 OneLake의 /Tables 폴더에서 Delta 로그를 읽어 SQL 스키마를 최신 상태로 유지하는데, 플랫폼이 책임지는 일은 세 가지예요.
- 테이블 탐색(table discovery): Lakehouse에 새로 생기거나 삭제된 Delta 테이블을 감지해서 endpoint의 SQL 테이블을 만들거나 지워요.
- 데이터 신선도(data freshness): 기존 테이블에 생긴 삽입·수정·삭제를 감지해서 쿼리 결과가 최신 상태를 반영하게 해요.
- 스키마 변경 감지: 기존 Delta 테이블의 컬럼 추가·삭제·타입 변경을 감지해서 SQL 테이블 정의를 갱신해요.
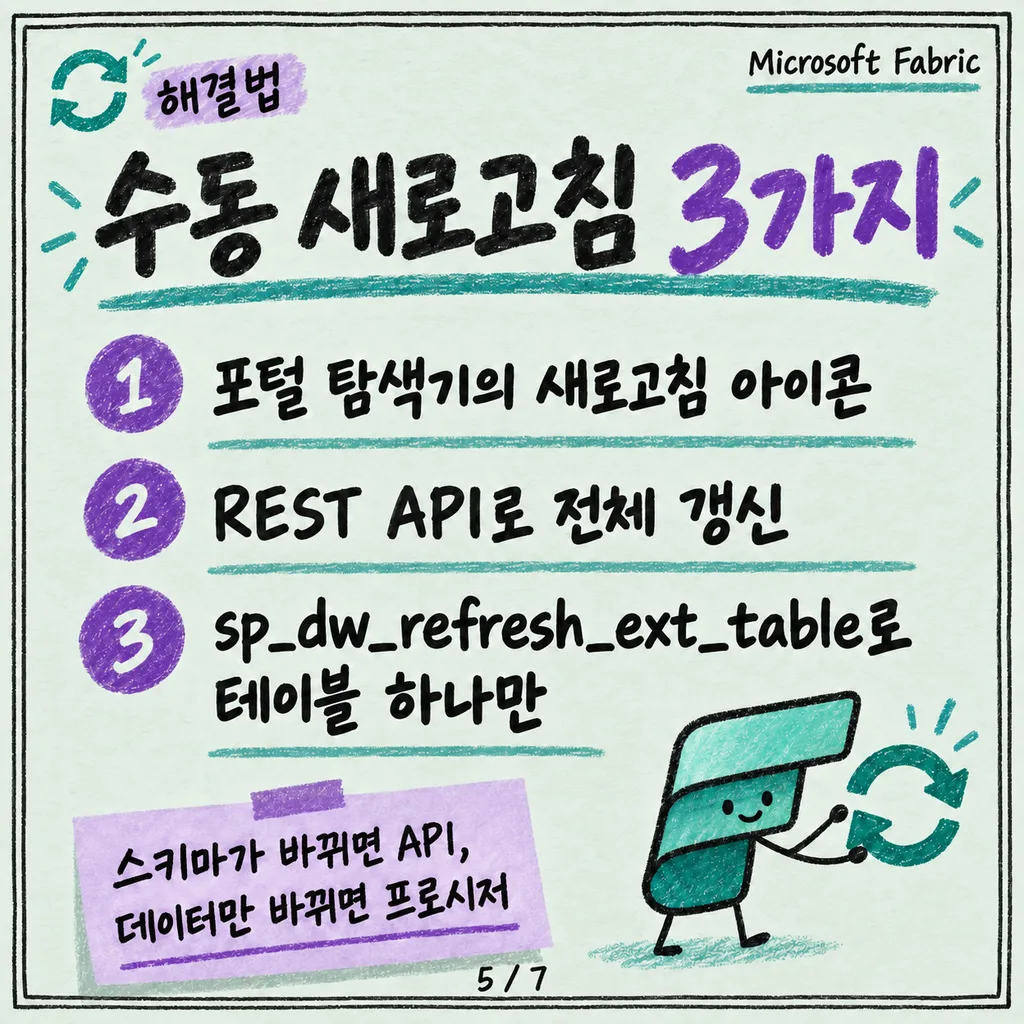
그런데 이 동기화가 항상 “즉시”는 아니에요. Spark로 테이블을 새로 만들거나 대량으로 데이터를 적재한 직후, SQL analytics endpoint 목록에 아직 안 보이거나 방금 넣은 행이 조회되지 않는 상황이 실제로 생겨요. 원문은 이럴 때 쓸 수 있는 수동 새로고침 방법 세 가지를 안내해요.
- 포털에서 새로고침: SQL analytics endpoint 편집기의 탐색기 도구모음에서 새로고침 아이콘을 눌러요.
- REST API로 새로고침: Refresh SQL analytics endpoint metadata API를 호출해 프로그래밍 방식으로 갱신해요.
- 저장 프로시저로 새로고침:
sys.sp_dw_refresh_ext_table시스템 저장 프로시저로 특정 테이블 하나만 갱신해요. 예를 들어EXEC sys.sp_dw_refresh_ext_table "dbo.publicholidays";같은 식이에요.
스키마 자체가 바뀌었다면(테이블·컬럼 추가/삭제, 타입 변경) API로 전체를 갱신하는 게 맞고, 데이터만 바뀐 경우라면 저장 프로시저로 해당 테이블만 갱신하는 편이 효율적이에요.
2026년, 더 빨라진 새 메타데이터 동기화(미리 보기)
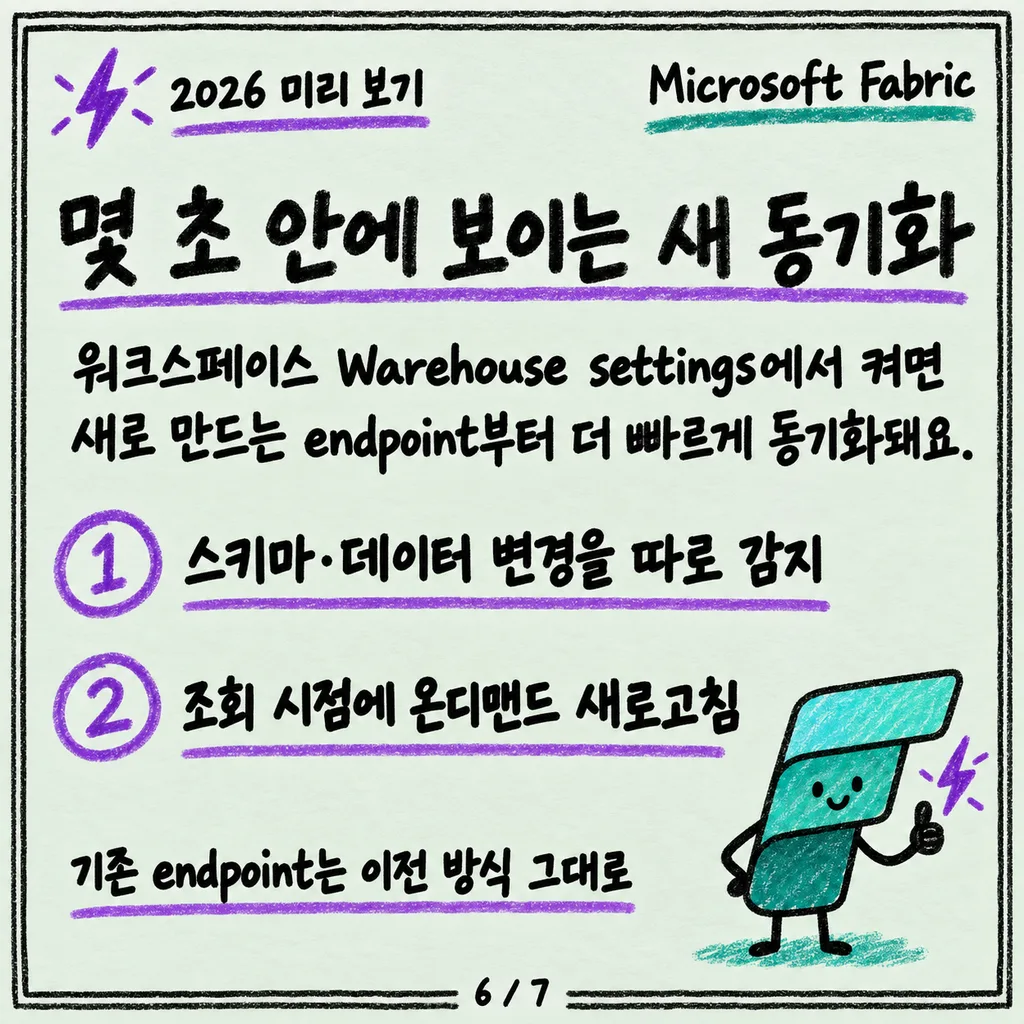
원문 기준으로 2026년 5월에 SQL analytics endpoint용 새 메타데이터 동기화가 미리 보기로 발표됐어요. 새로 만드는 SQL analytics endpoint에만 적용되는 옵션인데, 목표는 Lakehouse에 데이터가 들어온 지 몇 초 안에 조회 가능하게 만드는 거예요.
새 방식의 특징은 이래요.
- Delta 로그를 파싱하고 카탈로그를 만드는 방식을 외부 테이블(external table) 기반 아키텍처로 바꿨어요.
- 스키마 변경 감지와 데이터 변경 감지를 분리한 구조라서 각각 따로 갱신돼요.
- 주기적으로 데이터 변경 여부를 확인하는 백그라운드 새로고침이 있어요.
- 조회 쿼리가 들어왔는데 데이터가 최신이 아니라고 판단되면 그 자리에서 온디맨드로 새로고침해요.
워크스페이스 설정의 Warehouse settings에서 이 옵션을 켤 수 있고, 켠 뒤에는 그 워크스페이스에서 새로 만드는 endpoint부터 더 빠른 동기화를 적용받아요(기존 endpoint는 계속 이전 방식으로 남아요). 다만 아직 미리 보기 단계라 제약도 있어요. 예전 방식인 멀티파트 체크포인트(deprecated Delta 기능)를 쓰는 테이블은 새 동기화에서 갱신이 실패하고, 워크스페이스가 프라이빗 링크를 쓰는 경우엔 아직 이 옵션을 켤 수 없어요.
정리
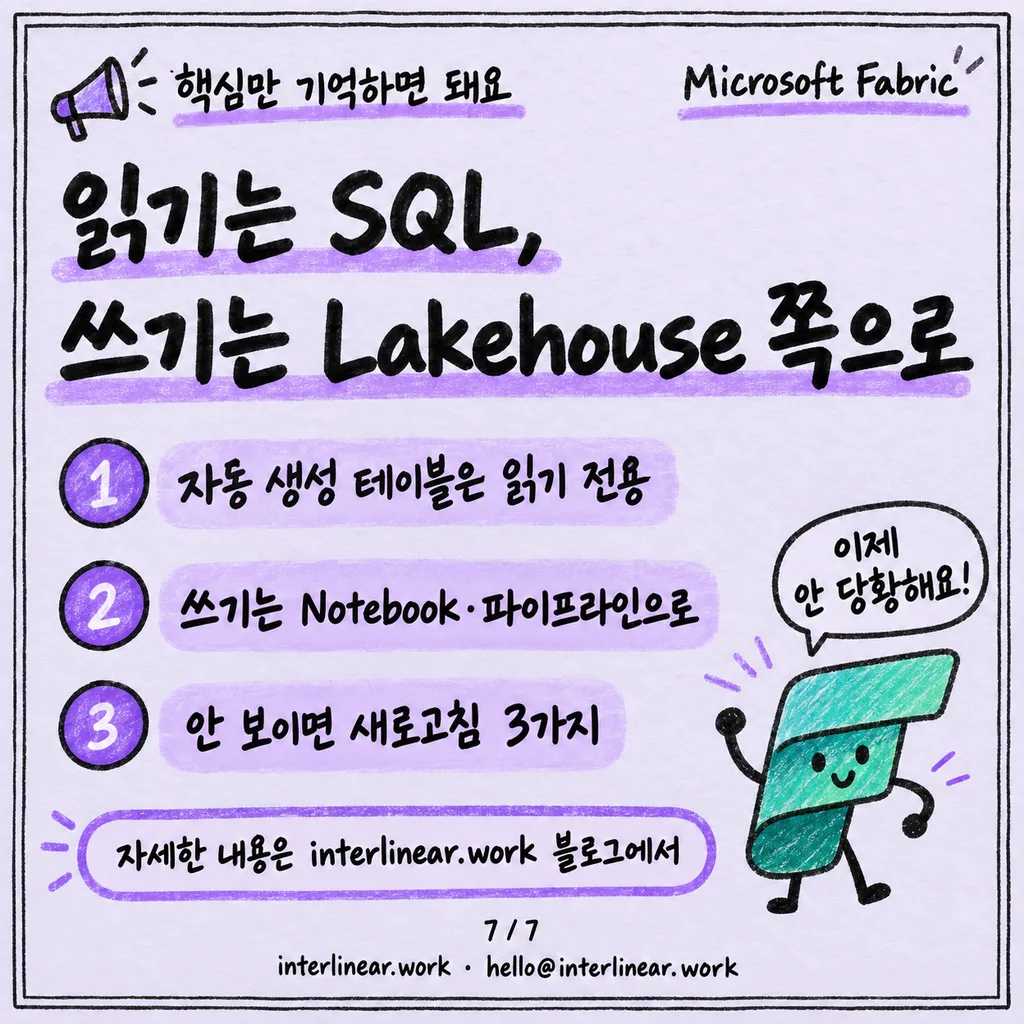
SQL analytics endpoint는 Lakehouse의 Delta 테이블을 T-SQL로 조회하게 해주는 편리한 창구지만, 자동 생성된 테이블 자체는 읽기 전용이라 DML은 Spark·파이프라인 쪽에서 처리해야 해요. 그리고 그 조회 결과가 항상 실시간은 아니라서, 방금 Spark로 쓴 데이터가 안 보이면 포털·REST API·저장 프로시저 중 하나로 수동 새로고침을 걸어보는 게 먼저예요. 2026년 미리 보기로 나온 새 메타데이터 동기화는 이 지연을 초 단위로 줄이는 걸 목표로 하고 있어요.