SQL database in Fabric: Warehouse와 뭐가 다른 거예요?
Fabric에 새로 생긴 SQL database는 트랜잭션용 운영 DB예요. 분석용 Warehouse와 목적이 왜 다른지, 데이터가 자동으로 OneLake에 미러링되는 구조까지 정리했어요.
카드뉴스
1 / 7
원문: SQL database Overview - Microsoft Fabric 최종 업데이트: 2026-05-19 · Microsoft Fabric 설명서 팀
Fabric을 처음 열어보면 항목 만들기 메뉴에 Warehouse도 있고 SQL database도 있어요. 둘 다 “SQL”이 붙어 있고 둘 다 T-SQL로 쿼리할 수 있으니, 뭐부터 만들어야 하나 헷갈리기 쉬워요. 결론부터 말하면 이 둘은 경쟁 관계가 아니라 역할이 달라요. 하나는 데이터를 “쓰는” 자리, 하나는 데이터를 “분석하는” 자리예요.
OLTP냐 분석이냐 — 애초에 쓰는 목적이 다르다
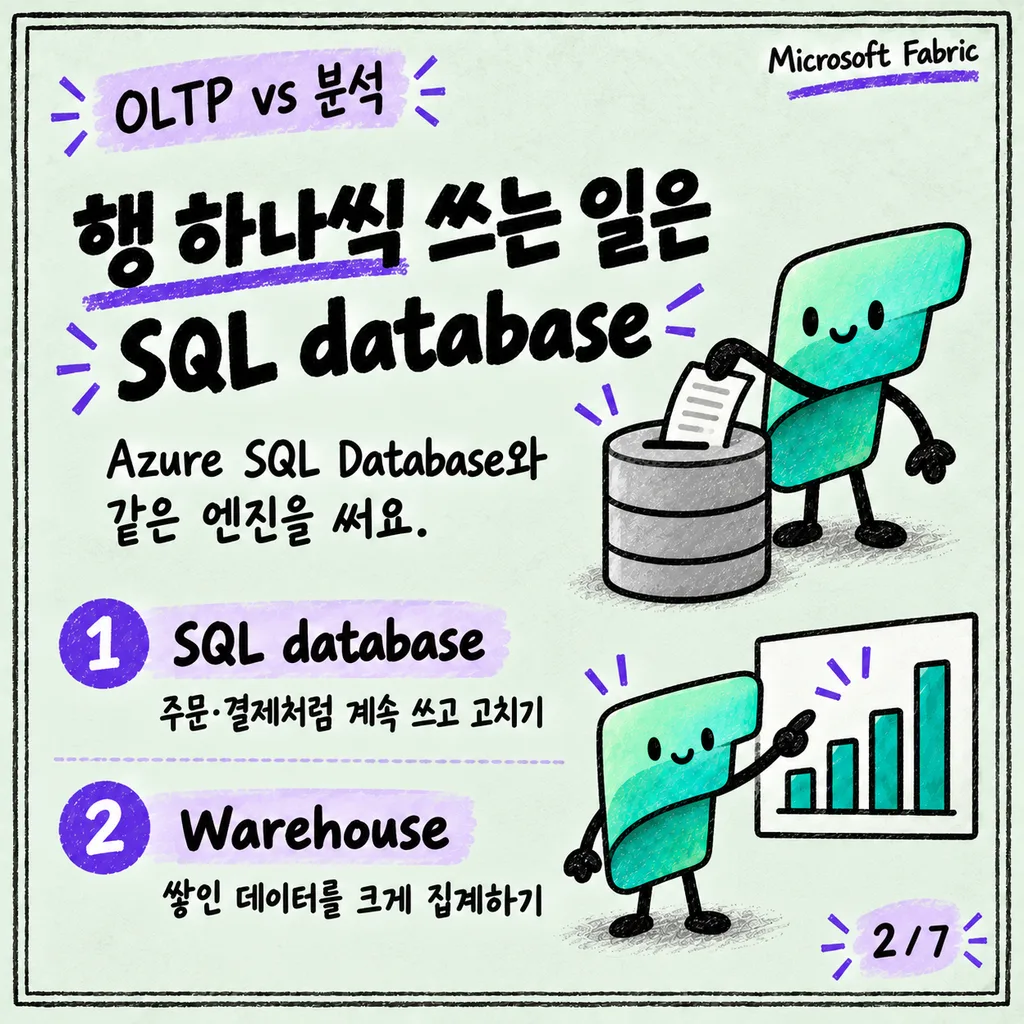
SQL database in Fabric은 Azure SQL Database와 같은 SQL Database Engine을 그대로 쓰는, 개발자 친화적인 트랜잭션 데이터베이스예요. 공식 문서는 이를 “Fabric 안에서 OLTP1 워크로드가 사는 자리”라고 소개해요. 즉 애플리케이션이 레코드를 계속 추가·수정·삭제하는 운영 데이터베이스 역할이에요.
반면 Warehouse는 이미 쌓인 대량의 데이터를 빠르게 집계·조회하기 위한 분석(OLAP) 엔진이에요. 트랜잭션 처리 성능보다 대규모 스캔·조인·집계 쿼리 성능에 최적화되어 있죠. 그러니까 “주문이 들어올 때마다 행 하나씩 쓰고 갱신하는 업무 시스템을 만들고 싶다”면 SQL database, “이미 쌓인 매출 데이터를 대시보드로 뽑고 싶다”면 Warehouse가 원래 있어야 할 자리예요.
데이터가 자동으로 OneLake에 미러링된다
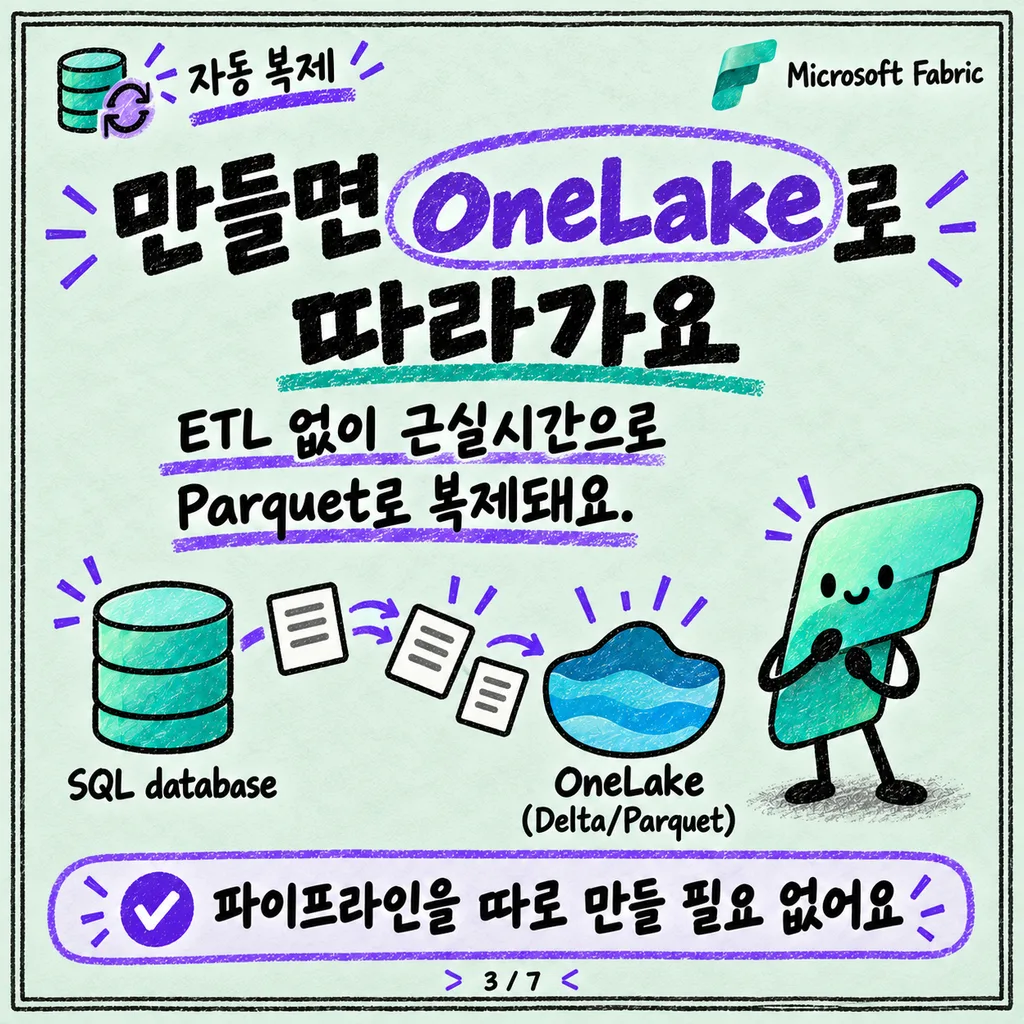
SQL database in Fabric에서 가장 눈에 띄는 부분은 여기예요. SQL database를 만드는 순간, 그 안의 데이터는 별도 ETL 파이프라인 없이 OneLake로 근실시간(near real time) 복제되고 Parquet 형식으로 자동 변환돼요. 문서 표현을 빌리면 “분석에 바로 쓸 수 있도록 자동으로 OneLake에 복제되도록 설정되어 있다”는 거예요.
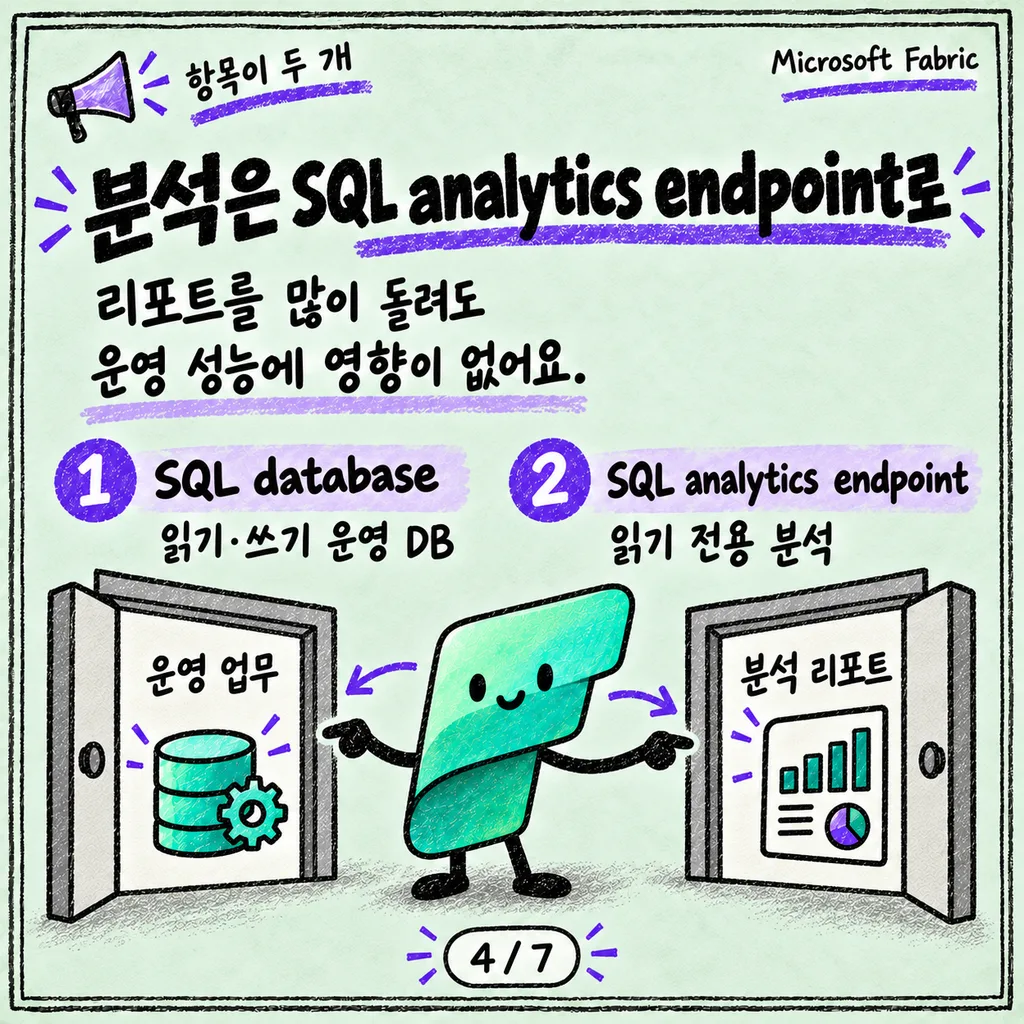
이때 함께 생기는 게 SQL analytics endpoint2예요. 운영 데이터베이스 자체와는 별개로, OneLake에 복제된 Delta 테이블을 T-SQL로 읽기만 할 수 있는 엔드포인트가 하나 더 만들어져요. 분석 쿼리가 이 엔드포인트로 몰리기 때문에, 리포트를 아무리 돌려도 운영 워크로드(트랜잭션 처리) 성능에는 영향을 주지 않아요. SQL database를 하나 만들면 워크스페이스에는 실제로 두 항목 — SQL database 본체와 SQL analytics endpoint — 가 함께 생기는 구조예요.
Warehouse·Lakehouse와 자유롭게 교차 쿼리
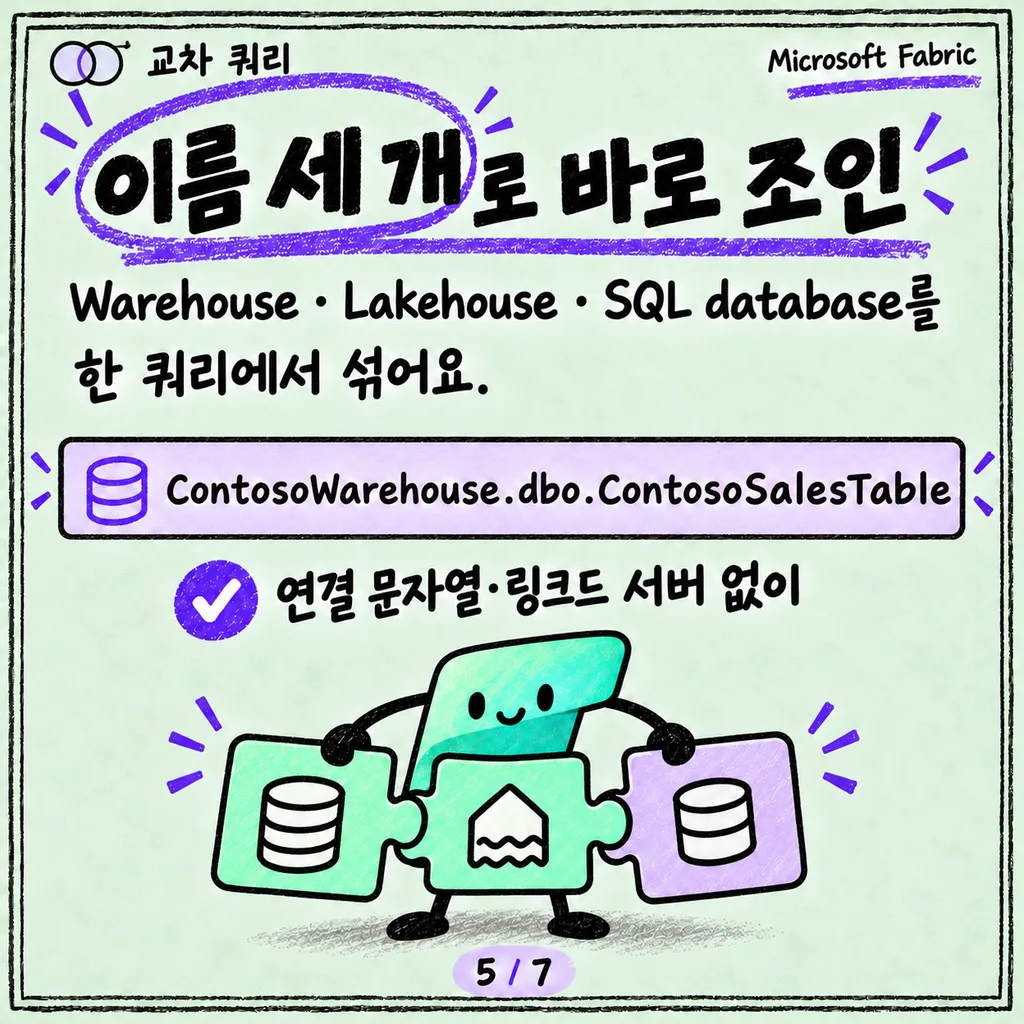
데이터가 전부 OneLake라는 한 곳에 모이기 때문에, SQL database·다른 미러링된 데이터베이스·Warehouse·Lakehouse를 하나의 T-SQL 쿼리 안에서 조인할 수 있어요. 이런 교차 쿼리는 SQL database나 Lakehouse의 SQL analytics endpoint에서 돌리고, 3-part naming으로 다른 항목을 그냥 테이블처럼 참조하면 돼요.
SELECT *
FROM ContosoWarehouse.dbo.ContosoSalesTable AS Contoso
INNER JOIN AdventureWorksLT.SalesLT.Affiliation AS Affiliation
  ON Affiliation.AffiliationId = Contoso.RecordTypeID;
운영 DB(SQL database)의 최신 데이터와 이미 적재해 둔 Warehouse의 이력 데이터를 하나의 쿼리로 섞어 볼 수 있다는 뜻이에요. 별도 연결 문자열이나 링크드 서버 설정 없이, 같은 Fabric 워크스페이스 안이라면 이름만으로 접근돼요.
언제 SQL database를, 언제 Warehouse를 쓰나
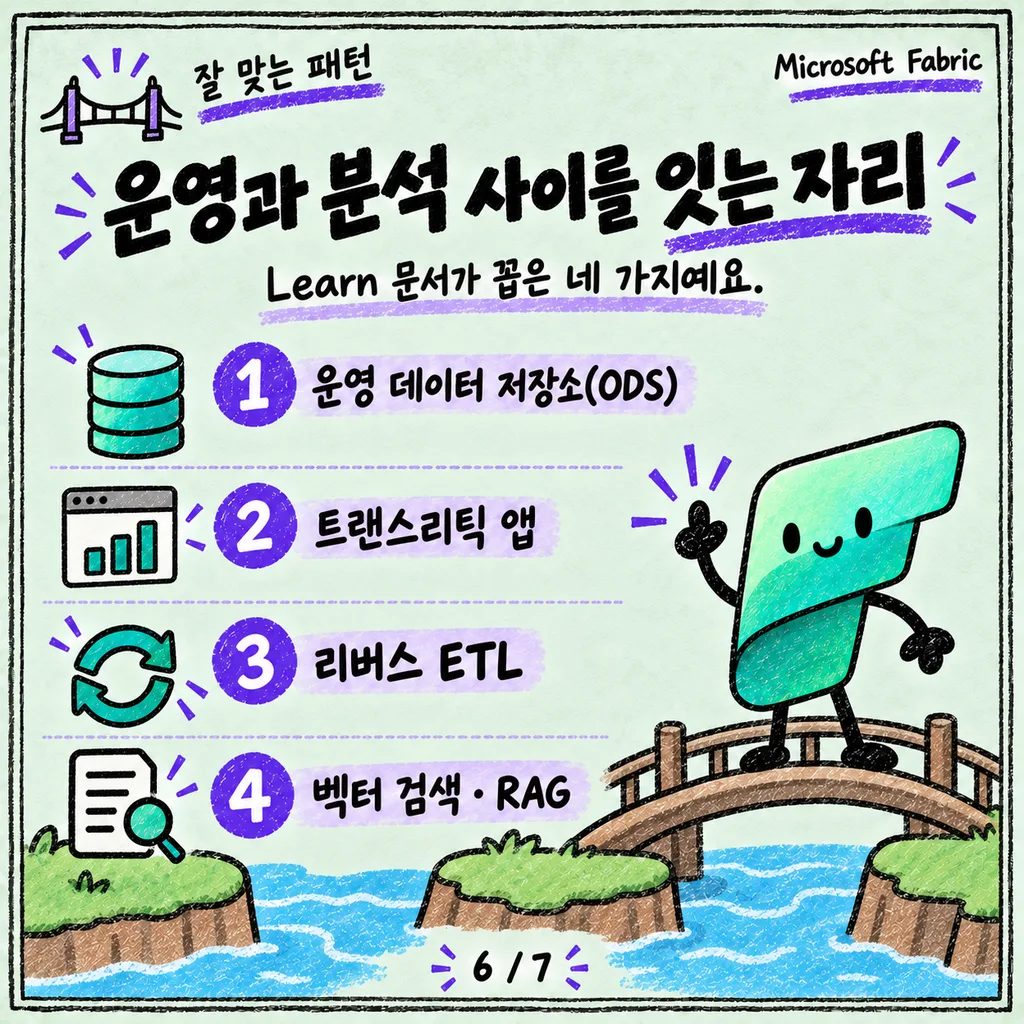
문서는 SQL database가 잘 맞는 대표 패턴 몇 가지를 소개해요.
- 운영 데이터 저장소(ODS)3: 여러 운영 시스템의 데이터를 정규화된 근실시간 저장소로 모아, 운영 리포팅과 가벼운 분석을 동시에 지원.
- 트랜스리틱(translytical) 애플리케이션: 같은 데이터에 대해 트랜잭션 처리와 분석 접근이 동시에 필요한 앱. 자동 미러링 덕분에 운영 성능에 영향 없이 분석 쿼리를 붙일 수 있어요.
- 리버스 ETL: Warehouse·Lakehouse에서 다듬은 분석 데이터를 다시 SQL database로 흘려보내, 애플리케이션·API·GraphQL 엔드포인트가 그 결과를 운영 의사결정에 바로 쓰게 하는 패턴.
- AI 애플리케이션: SQL Database Engine에 내장된 vector 데이터 타입으로 임베딩을 저장하고 유사도 검색까지 T-SQL로 처리할 수 있어서, RAG4 패턴을 구현할 때 별도 벡터 DB 없이 SQL database 하나로 끝낼 수 있어요.
반대로 대량의 이력 데이터를 쌓아두고 BI 리포트·대시보드를 위한 집계 쿼리를 반복적으로 돌리는 용도라면, 처음부터 분석에 최적화된 Warehouse를 쓰는 편이 맞아요.
정리
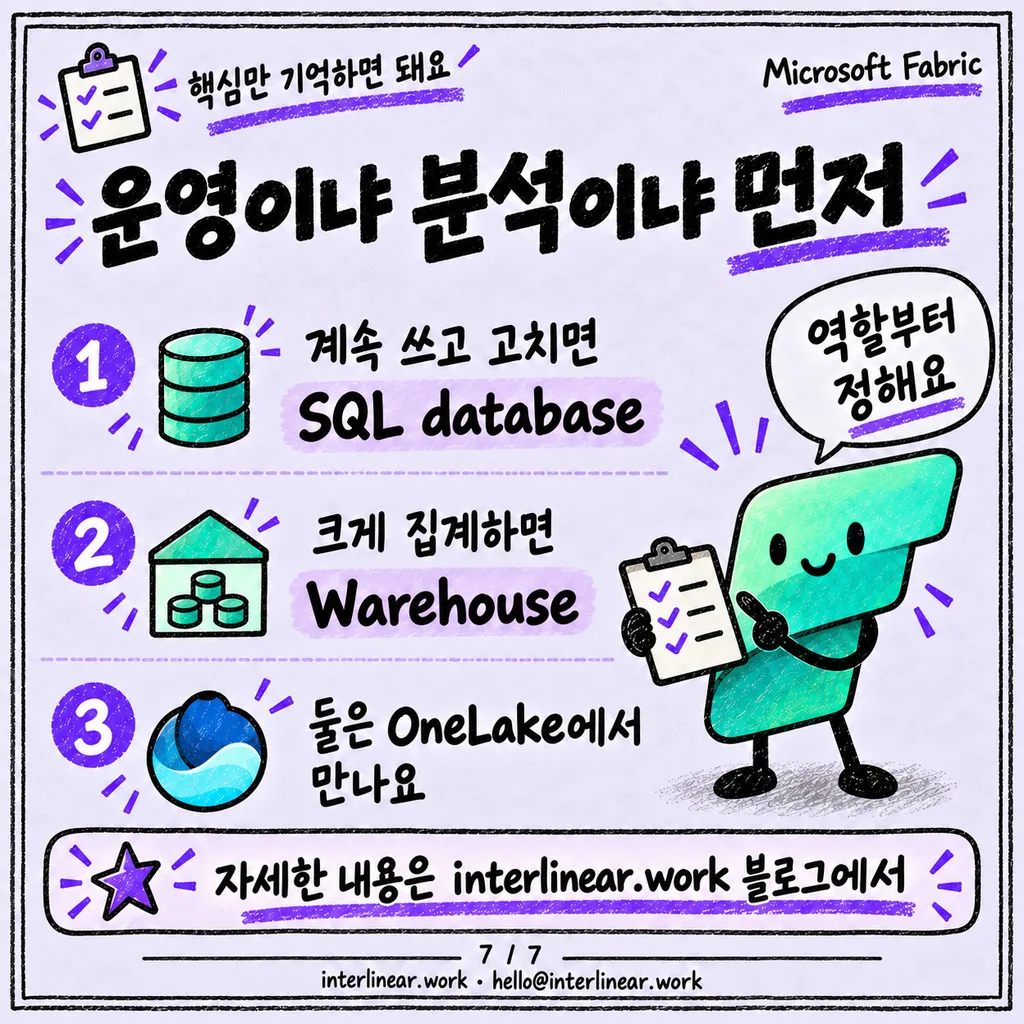
SQL database in Fabric은 “Fabric 안의 Azure SQL Database”라고 생각하면 쉬워요. 트랜잭션 처리가 본업이고, 그 데이터는 자동으로 OneLake에 미러링되어 SQL analytics endpoint를 통해 별도 ETL 없이 분석에 쓰일 수 있어요. Warehouse는 여전히 대량 분석용 엔진의 자리이고, 둘은 OneLake 위에서 3-part naming으로 자유롭게 교차 쿼리할 수 있으니 “운영이냐 분석이냐”를 먼저 따져서 고르면 돼요.
어휘 주석
- OLTP(Online Transaction Processing): 주문·결제처럼 짧은 트랜잭션 단위로 데이터를 계속 쓰고 갱신하는 처리 방식. 대량 집계 위주인 OLAP(분석 처리)와 대비돼요.
- SQL analytics endpoint: SQL database나 Lakehouse의 데이터를 OneLake에서 읽기 전용 Delta 테이블로 노출해, T-SQL로 분석 쿼리를 던질 수 있게 해주는 엔드포인트.
- 운영 데이터 저장소(Operational Data Store, ODS): 여러 운영 시스템의 데이터를 한곳에 모아 정리한, 데이터 웨어하우스보다 실시간에 가까운 중간 저장소.
- RAG(Retrieval-Augmented Generation): LLM이 답을 생성하기 전에 관련 문서·데이터를 검색해 함께 참고하도록 만드는 패턴. 벡터 검색이 이 검색 단계를 담당해요.